AI音声の機械っぽさをなくす方法:棒読みを直す12の対策(2026年版)
AI音声が機械っぽく聞こえる原因と、効果のある12の対策を解説。耳で聞くための書き方、句読点で作る間、数字の書き方、発音の直し方、速度の調整まで。
台本を貼り付けて生成ボタンを押すと、聞こえてくる声は……まあ、悪くはない。聞き取りやすいけれど、どこか棒読み。列挙の部分は早口で流れ、強調する場所はずれ、「$1.2M」はまるで表計算ソフトのセルを読み上げているかのようです。
意外かもしれませんが、いまや技術そのものが原因であることはほとんどありません。PLOS One に掲載された2025年の研究では、聞き手がAIのクローン音声を人間の声だと判断した割合は 58〜70% にのぼり、本物の人間の録音(62〜81%)に迫っていました。
つまり、いまAI音声が機械っぽく聞こえるとしたら、原因はたいていエンジンではなく、台本と設定にあります。どちらも数分で直せます。
このガイドでは、その具体的な方法を紹介します。
この記事でわかること:
- AI音声が機械っぽく聞こえる5つの原因
- 音声のどこに問題があるかを手早く見分ける方法
- 台本の書き直しから音声設定の調整まで、12の対策
- コードを使わずに、間・数字・発音をコントロールする方法
- AIナレーションに適した速度(実際の数値つき)
- そのまま参考にできる、書き直し前後の全文比較
結論から言うと: AI音声の機械っぽさをなくすには、人が話すように短い文で書き、読点・句点や段落の区切りで間を作ります。数字や略語は読み方どおりに書き、読み間違えられる言葉は発音どおりのつづりに直し、内容に合った声を選びましょう。そのうえで速度を少し落とし、安定性を少し下げると、表現が豊かになります。AIテキスト読み上げツールなら、そのほとんどが数秒で済みます。
AI音声が機械っぽく聞こえるのはなぜ?
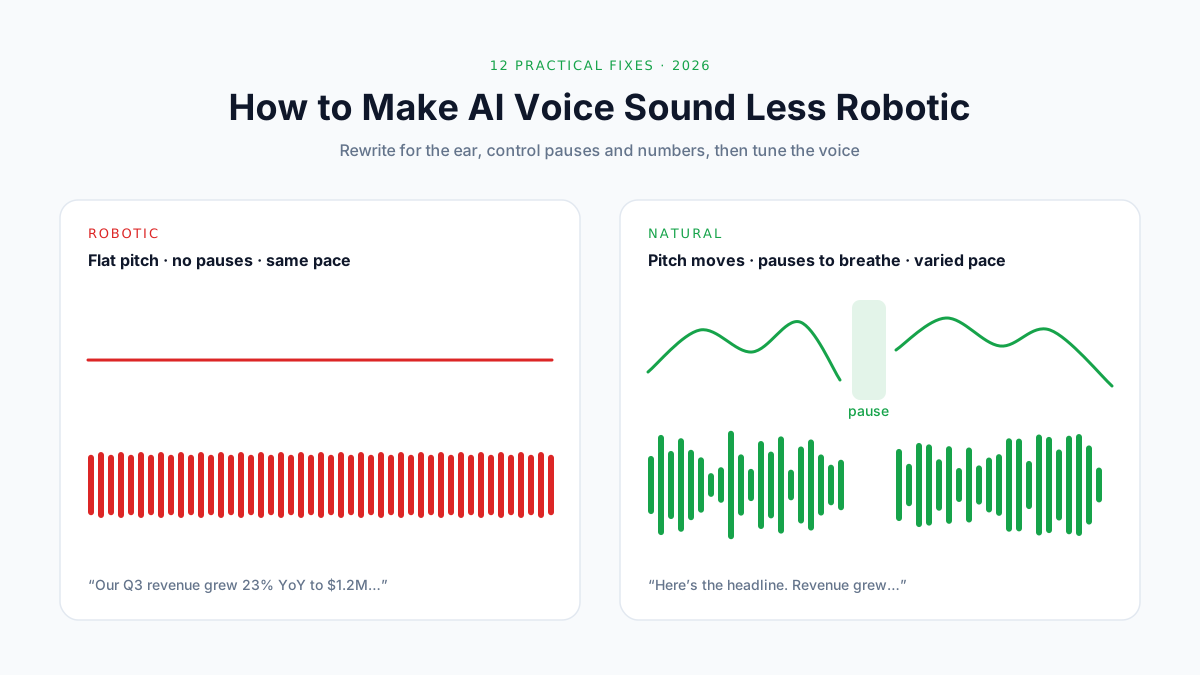
AI音声が機械っぽく聞こえるのは、リズム・音の高さ・間の取り方が、人の実際の話し方と合っていないときです。人は話す速さを変え、声の高さを上げ下げし、息継ぎのために間を置き、大事な言葉を強調します。合成音声がそれをしないと、機械っぽく聞こえるのです。
5つの原因
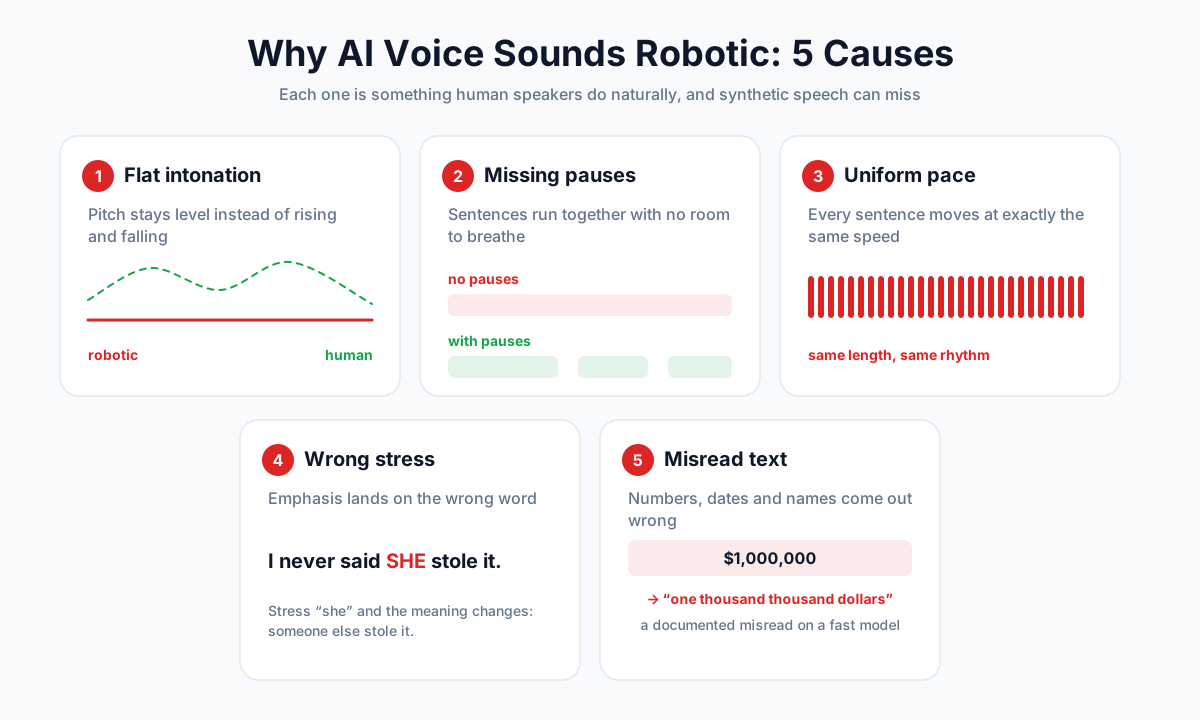
- 平坦なイントネーション。 意味に合わせて上下するはずの音の高さが、ずっと一定のまま。
- 間がない。 文と文がくっついてしまい、息をつく余裕がない。
- ペースが一定。 どの文もまったく同じ速さで進む。
- 強調の位置がずれている。 別の言葉が強調されて、意味が変わってしまう。
- テキストの読み間違い。 数字、日付、略語、名前が正しく読まれない。
最後の問題には、研究者のあいだで名前がついています。テキスト正規化(text normalization)、つまり書かれた文字を、音声が読み上げられる言葉に変換する処理です。これは最新のシステムにとっても難題です。たとえば「1/2」は、文脈によって「2分の1」にも「1月2日」にも「2月1日」にもなるからです。
AI音声はここまで進化した
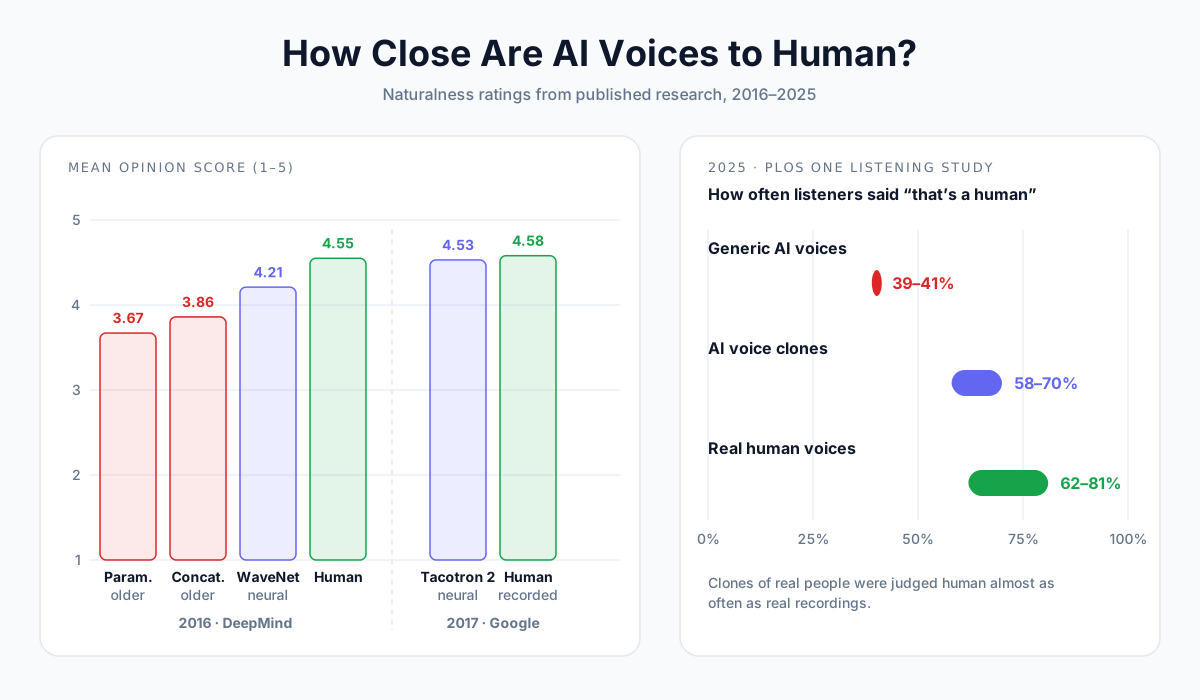
音声の研究者は、自然さを平均オピニオン評点(MOS:Mean Opinion Score)で測ります。聞き手が音声クリップを1(悪い)から5(非常に良い)の5段階で評価する指標です。
| 年 | 出来事 | スコア |
|---|---|---|
| 2016 | 従来の「パラメトリック」「波形接続型」の音声(ロボットのようなカーナビ音声の時代) | MOS 3.67と3.86。人間は4.55 |
| 2016 | DeepMindのWaveNet。初めての本格的なニューラル音声 | MOS 4.21 |
| 2017 | GoogleのTacotron 2 | MOS 4.53(録音音声は4.58) |
| 2022 | MicrosoftのNaturalSpeech | 録音との間に統計的な有意差なし |
| 2025 | PLOS One の聴取実験 | クローン音声が人間と判断された割合は58〜70%。本物の人間は62〜81% |
同じ研究では、汎用のAI音声(実在の人物からクローンしたものではない声)が人間と判断されたのは、約40%にとどまりました。この差は大きな意味を持つので、対策11であらためて取り上げます。
いまの「機械っぽさ」は、ほとんどが台本の問題
最新の音声は、人間のように話せます。ただし、読むのはあくまで渡された文章そのものです。
略語が3つとドルの金額が入った45語の一文は、ほぼどの音声で読ませても機械っぽく聞こえます。同じ内容でも、耳で聞くための文章に書き直せば、たいていの音声で自然に聞こえます。以下の対策の多くがテキストに関するものなのは、そのためです。
症状別クイック診断
何かを変える前に、まず一度聞いて、何が問題なのかを見きわめましょう。そのうえで、該当する対策に進みます。
| 聞こえ方 | 考えられる原因 | 対策 |
|---|---|---|
| 平坦で単調な読み方 | 声が内容に合っていない、または安定性が高すぎる | 対策1、2、9 |
| 話の区切りで息をつく余裕がない | 文が長く、読点や段落の区切りが少ない | 対策3、4 |
| 早口で、息つく間もない読み方 | 速度が速すぎる、列挙を1文に詰め込んでいる | 対策3、8 |
| 強調する言葉がずれている | 大事な言葉が文の途中に埋もれている | 対策7 |
| 「$1,000,000」の読み方がおかしい | 数字や記号がそのまま残っている | 対策5 |
| 名前やブランド名を読み間違える | つづりから発音がわかりにくい、珍しい言葉 | 対策6 |
| 段落ごとに声の印象が変わる | 長い台本を、設定がばらばらのまま分割している | 対策10 |
| 音が「きれいすぎて」、実験室で録ったように聞こえる | 響きのない乾いた音。ルームトーンやBGMがない | 対策12 |
12の対策
対策1:まずは適切な音声ティアを選ぶ
AI音声といっても、どれも同じ作りではありません。速くて安いモデルは下書きにぴったり。プレミアムモデルは、リズムや感情の表現にすぐれています。
AnySpeechでは、同じテキストを5つのティアで生成できます。
| ティア | 向いている用途 | 知っておきたいこと |
|---|---|---|
| Basic | 下書き、長文の読み上げ、アクセシビリティ | 無料。無料のテキスト読み上げで使えます |
| スタンダード | 幅広い言語とアクセント | 300以上の音声、40以上の言語 |
| Flash | 短く、生き生きとした会話調のコンテンツ | 高速で表現力豊か。1回の生成は最大5,000文字 |
| Advanced | 70以上の言語での自然なナレーション | 多くのナレーションでAnySpeechが標準としているティア |
| Pro | 最も繊細で自然な読み | 1文字あたり2クレジット。有料プラン限定 |
💡 プロのコツ: 平坦に聞こえる文があっても、すぐに書き直すのは待ちましょう。まずは同じ文を上位のティアで生成してみます。それで自然に聞こえたなら、原因は声でした。それでも違和感が残るなら、原因は台本です。
対策2:内容に合った声を選ぶ
広告では映える声も、寝る前の読み聞かせでは浮いてしまうことがあります。サンプルがいちばん良く聞こえる声ではなく、その音声を何に使うかで選びましょう。
| コンテンツ | 選びたい声 | 避けたい声 |
|---|---|---|
| オーディオブック、ドキュメンタリー | 温かみがあり、落ち着いたナレーター | 煽り気味の「アナウンサー」風の声 |
| 解説動画、eラーニング | 明瞭で親しみやすく、ほどよいペース | 息の多すぎる声、芝居がかった声 |
| 広告・プロモーション | エネルギッシュで明るい | ゆっくりした、柔らかい声 |
| YouTube・SNS | 会話調で自然 | 堅苦しすぎる声 |
| 瞑想・睡眠 | 穏やかで低く、ゆっくり | アップテンポなもの全般 |
音声ライブラリでは、スタイルで絞り込んで探せます。YouTube用の台本なら、YouTubeナレーションジェネレーターにナレーション向きの声がそろっています。
対策3:目で読む文章ではなく、耳で聞く文章を書く
書き言葉と話し言葉は別物です。読むときは長い文を読み返せますが、聞くときはそうはいきません。
- 文は短く。 英語なら20語以内が目安です。それより長い文は分けましょう。
- 話し言葉の言い回しを使う。 英語では「it's」「you'll」「don't」のような短縮形が人間らしく聞こえ、「it is」「you will」は硬く聞こえます。日本語でも「〜となっております」より「〜です」のほうが自然です。
- 1文に1つの内容。 2つの内容を「〜であり、」「〜で、」でつなぐと、そこでリズムが崩れます。
- 能動態で書く。 「10個のツールが当チームによって検証されました」より、「私たちは10個のツールを試しました」のほうがはっきり伝わります。
- 自分で声に出して読んでみる。 途中で息が続かなくなるなら、AIの声も同じように苦しくなります。
| 目で読む文章 | 耳で聞く文章 |
|---|---|
| 登録手続きの完了後、ユーザーに対して確認メールが送信されます。 | 登録が済んだら、確認メールをお送りします。 |
| 2024年にリリースされた本製品は、10,000以上のチームにより導入されています。 | リリースは2024年。それから、一万を超えるチームが使い始めてくれました。 |
対策4:句読点で間を作る
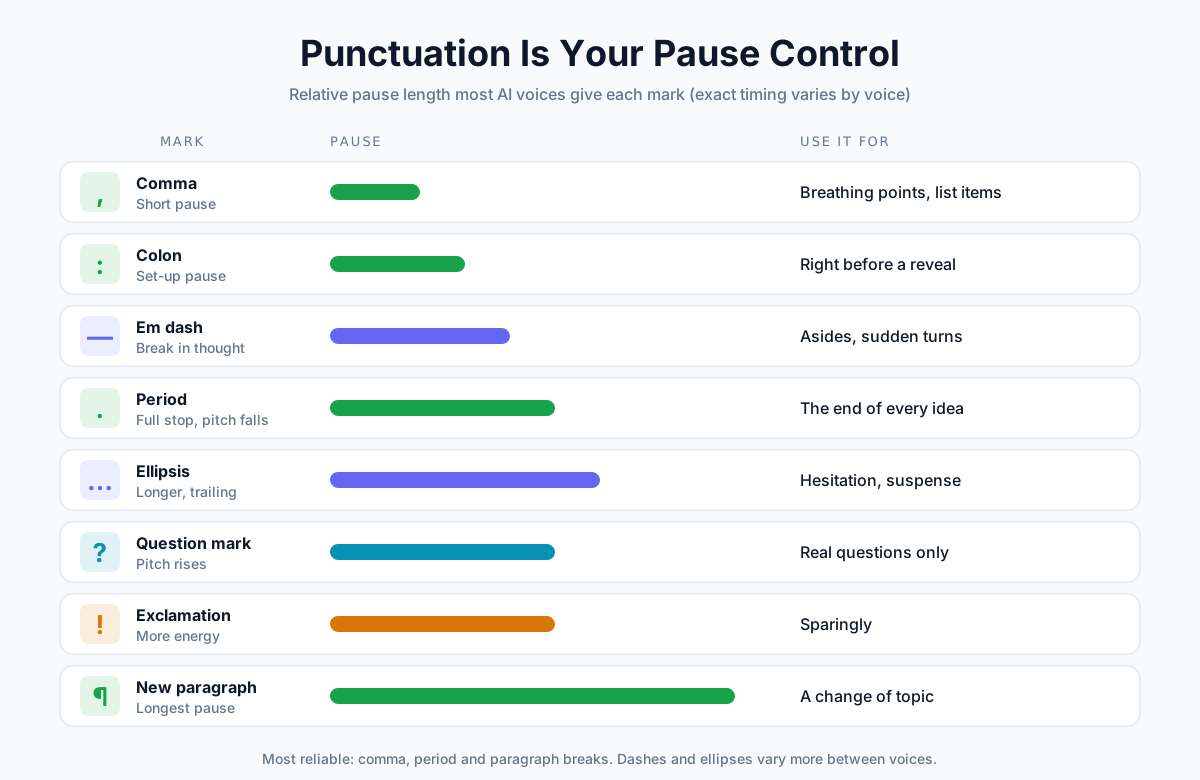
最新のAI音声は、句読点を台本の「ト書き」のように扱います。読点(カンマ)では短く息をつき、句点(ピリオド)では音程が下がります。そして段落を分けると、いちばん長い間が入ります。
| 句読点 | 主な効果 | 使いどころ |
|---|---|---|
| 読点「、」・カンマ「,」 | 短い間 | 息継ぎの位置、列挙 |
| 句点「。」・ピリオド「.」 | 文の区切り。音程が下がる | 1つの内容を言い終えるたびに |
| コロン「:」 | 次を予告する短い間 | 答えを明かす直前や、列挙の前 |
| ダッシュ「—」 | 話の切れ目 | 補足や、急な話題の転換 |
| 三点リーダー「…」 | 長く、余韻のある間 | ためらい、緊張感 |
| 疑問符「?」 | 音程が上がる | 本当に問いかけるときだけ |
| 感嘆符「!」 | 勢いが増す | ここぞというときだけ。多いと叫んでいるように聞こえる |
| 段落の区切り | いちばん長い間 | 話題が変わるとき |
📝 注意: 実際の間の長さは、声やエンジンによって異なります。ElevenLabs自身のドキュメントでも、ダッシュや三点リーダーは他の方法に比べて間の入り方が安定しないとされています。最も確実なのは、読点・句点と段落の区切りです。
対策5:数字・日付・記号は読み方どおりに書く
AI音声がいちばんつまずきやすいのが、数字と記号です。同じ文字でも、何通りもの読み方ができるからです。
ElevenLabsのドキュメントには、わかりやすい例があります。同社の高速モデルの1つは、「$1,000,000」を one thousand thousand dollars(直訳すると「千の千ドル」)と読んでしまうことがあるそうです。数字を読み方どおりに書いておけば、どの音声でも読み方に迷う余地がなくなります。
| 元の表記 | こう書く | 理由 |
|---|---|---|
| $1,000,000 | 百万ドル | 桁の区切り方がおかしくなるのを防ぐ |
| $42.50 | 42ドル50セント | セントの部分まで正しく読まれる |
| 3:30 pm | 午後3時半 | 比率ではなく時刻として読まれる |
| 2026-01-15 | 2026年1月15日 | 日付の書き方は国によって違う |
| 25% | 25パーセント | 記号を読み飛ばす音声がある |
| Dr. Smith | ドクター・スミス | 「Dr.」は「Drive」の略とも読める |
| Q3 | 第3四半期 | 略語はアルファベットのまま一文字ずつ読まれる |
| anyspeech.io/pricing | エニースピーチ ドット アイオー スラッシュ プライシング | URLはどう読まれるか予測しにくい |
| 1/2 | 2分の1 | 日付と取り違えられることがある |
すべての数字をこう書き換える必要はありません。「3」や「10」のような小さく単純な数字なら、たいてい問題なく読まれます。気をつけたいのは、金額、日付、時刻、パーセント、そして記号を含むものです。
対策6:つづりを変えて発音を直す
声が名前やブランド名を読み間違えたら、聞こえるとおりのつづりに書き換えましょう。裏ワザのように思えますが、どのエンジンでも確実に効く唯一の方法です。日本語なら、読み間違えられやすい言葉をかなで書くのが同じテクニックにあたります。
| 単語 | 書き換え例 | 解決する問題 |
|---|---|---|
| Nguyen | Win | よくある姓だが、読み間違えられやすい |
| Worcestershire | Wuss-ter-sher | 発音しない文字がある |
| AnySpeech | Any Speech | 単語をつなげたブランド名 |
| SQL | sequel(または S Q L) | 略語として読むか、単語として読むか |
| read(過去形) | red | つづりは同じでも発音が違う |
| live(形容詞) | lyve | 「a lyve show」と「I live here」の違い |
| GIF | jif(または gif) | どちらかに決めて、読み方を統一する |
AnySpeechなら、台本を毎回書き換える必要はありません。テキスト読み上げページで Pronunciation dictionary(発音辞書)を開き、Written text(表記)と Say it like(読み方)を入力すれば、そのルールがすべての音声に自動で適用されます。ログインすれば、ルールは最大50件まで保存できます。
💡 プロのコツ: 一文字ずつ読ませたい略語には、スペースかピリオドを入れましょう(「F B I」や「F.B.I.」)。「NASA」のように単語として読む略語は、そのままで構いません。
対策7:語順で強調を作る
プレーンテキストで入力するツールでは、特定の言葉に「ここを強調」と印をつけることはできません。それでも、文の組み立て方で強調はコントロールできます。
- 大事な言葉は文末に置く。 英語では、文の終わりが自然と強く読まれます(「The results surprised everyone」と「Everyone was surprised by the results」を比べてみてください)。日本語でも「誰もが驚いたのは、その結果でした」のように、伝えたい言葉を最後に回すと際立ちます。
- 独立した1文にする。 「無料です。完全に、無料です。」短い文は強く響きます。
- コロンやダッシュで「溜め」を作る。 「大事なのは、ひとつだけ——タイミングです。」
- 英単語をすべて大文字で書かない。 多くの音声は大文字の並びを略語とみなし、一文字ずつ読み上げてしまいます。
対策8:適切な速度に設定する
ナレーションが機械的に聞こえる最もよくある原因は、声がほんの少し速すぎることです。実際のナレーターの目安は次のとおりです。
| コンテンツ | 一般的なペース | 最初に試す速度設定 |
|---|---|---|
| オーディオブックのナレーション | 毎分約155語(ACX) | 0.9×〜1.0× |
| 日常会話 | 毎分約150語 | 1.0× |
| チュートリアル、技術的な内容 | 会話より少し遅め | 0.9× |
| 広告・プロモーション | 速めで勢いがある | 1.05×〜1.1× |
| 瞑想・睡眠 | ゆっくり、ゆったり | 0.8× |
155語という数字は、Audibleのオーディオブック制作プラットフォームであるACXによるものです。ACXによると、ほとんどのナレーターは1時間に約9,300語(英語)を読みます。
AnySpeechでは、スタンダード・Advanced・Proの各ティアにある速度スライダーを、0.7×〜1.2×の範囲で調整できます。変えるときは0.1×ずつ小刻みに。大きく動かすと、声が間延びしたり、詰まったりして聞こえることがあります。
対策9:安定性と類似度を調整する
AdvancedとProのティアでは、2つのスライダーで声の表現力を変えられます。
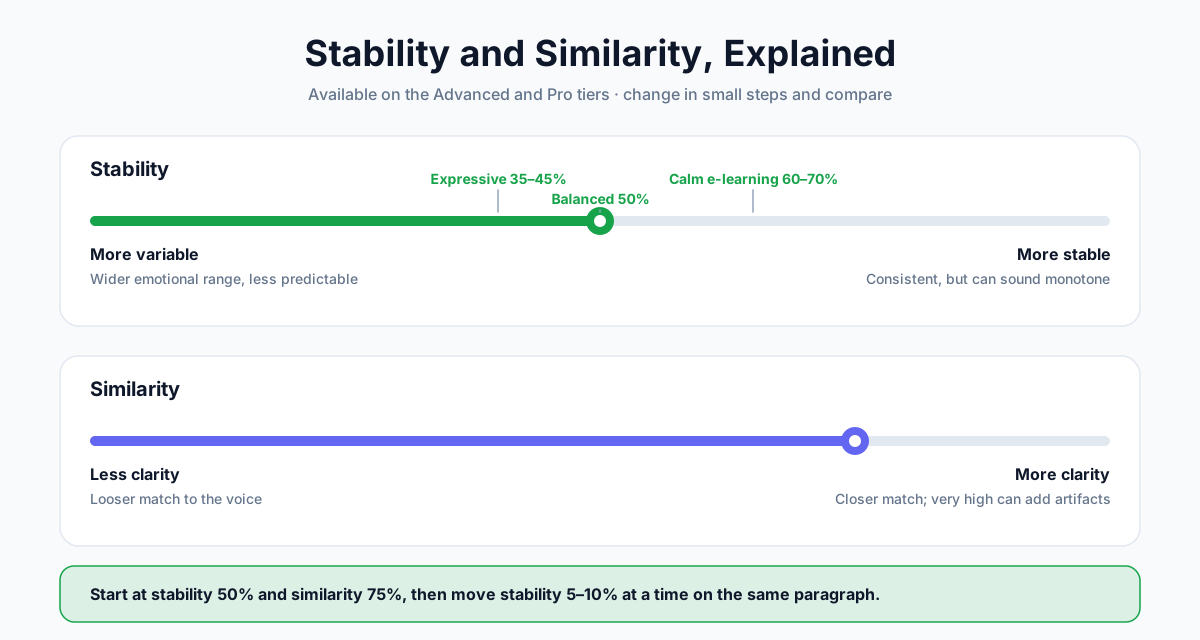
| スライダー | 下げると | 上げると |
|---|---|---|
| 安定性 | 変化が多い:感情の幅は広がるが、予測しにくくなる | 安定している:一貫性は出るが、単調に聞こえることも |
| 類似度 | 低い明瞭度:元の声との一致がゆるくなる | 高い明瞭度:元の声に近づく。高すぎるとノイズ(アーティファクト)が出ることも |
実用的な初期設定の目安は次のとおりです。
| 目的 | 安定性 | 類似度 |
|---|---|---|
| 表現豊かなストーリーテリング | 35〜45% | 75% |
| バランスの取れたナレーション(デフォルト) | 50% | 75% |
| 安定感のある、落ち着いたeラーニング | 60〜70% | 75〜80% |
安定性は5〜10%ほどずつ調整し、そのたびに同じ段落を生成し直して聞き比べましょう。
対策10:長い台本はセクションごとに生成する
長い台本には、2つの問題があります。1文でもうまくいかなければ、全体を生成し直さなければなりません。かといって無造作に分割すると、パートごとに声の印象が少しずつ変わってしまいます。
- 自然な区切りで分ける:章、場面、話題の変わり目で分け、段落の途中では決して切らない。
- 設定はすべてのパートで同じにする:声、ティア、速度、安定性をそろえます。
- ファイル名は順番どおりに付ける(01-intro、02-setup…)。あとで結合するのが楽になります。
AnySpeechの有料プランでは、一度に最大50,000文字まで生成できます(無料プランとFlashティアでは5,000文字)。それでも章ごとに生成しておけば、1行だけ直すのがずっと楽になります。
対策11:人間の声をクローンして使う
PLOS One の研究を覚えていますか?実在の人物のクローン音声は、汎用のAI音声よりもはるかに高い割合で人間の声だと判断されていました。汎用の約40%に対して、およそ58〜70%です。
クローン音声には、その人ならではのリズムや癖、息づかいが残ります。定期的にナレーションを作るなら、短い録音から自分の声をクローンし、どの台本にもその声を使えます。
- 静かな部屋で録音し、音楽や反響が入らないようにする。
- クローンに再現してほしい話し方で話す:「アナウンサー」口調ではなく、リラックスした自然な話し方で。
- クローンするのは自分の声だけ、または使用の許可をはっきり得ている声だけにする。
録音の手順は、AIで自分の声をクローンする方法のガイドでステップごとに解説しています。
対策12:ポストプロダクションで仕上げる
加工していないAI音声は、何もない空間に声だけが浮かんでいるような、不自然なほど「きれい」な音に聞こえることがあります。少し手を加えるだけで、現実の空間になじむ音になります。
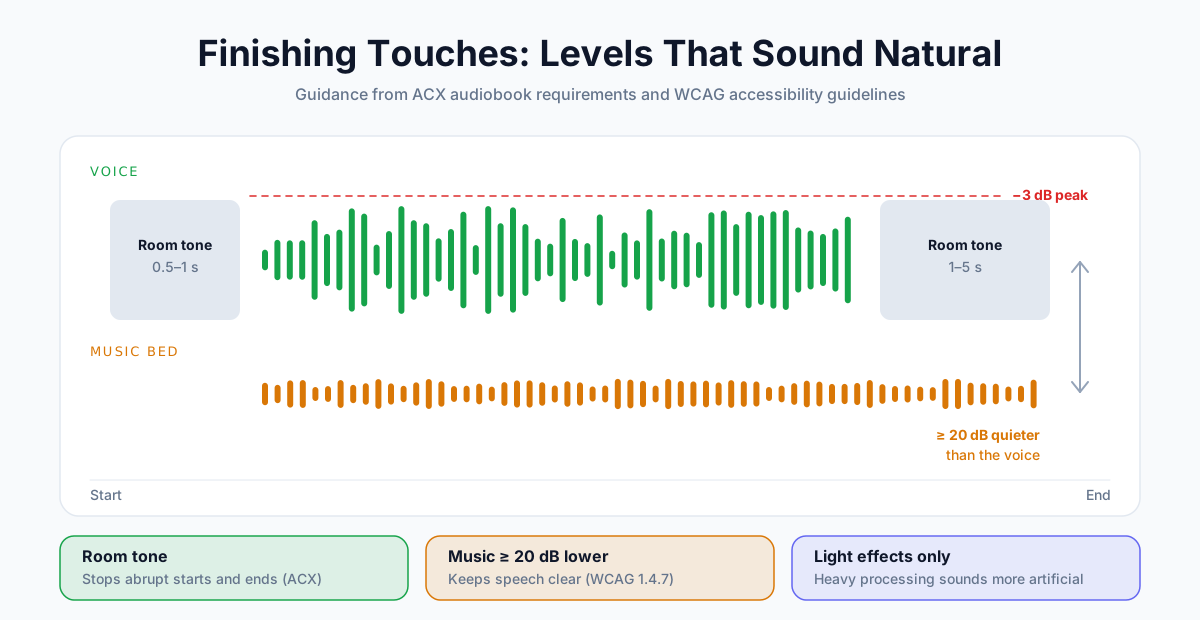
- ルームトーンを加える。 ACXは、各ファイルの冒頭に0.5〜1秒、末尾に1〜5秒のルームトーン(部屋の環境音)を入れるよう求めています。これで音声が唐突に始まったり終わったりしなくなります。
- BGMは声よりしっかり小さく。 アクセシビリティのガイドライン(WCAG)では、背景音を話し声より少なくとも20デシベル小さくすることが推奨されています。
- エフェクトは控えめに。 強いコンプレッション、リバーブ、EQをかけると、合成音声がかえって人工的に聞こえることがあります。
- ピークは−3 dB未満に抑える。 大音量で再生したときに音割れしないようにするためです(これもACXの要件です)。
ビフォー・アフター:段落まるごと書き直してみる
ビジネスレポートによくある書き方をした英文を1段落用意し、音声で読ませる前提で書き直してみました。
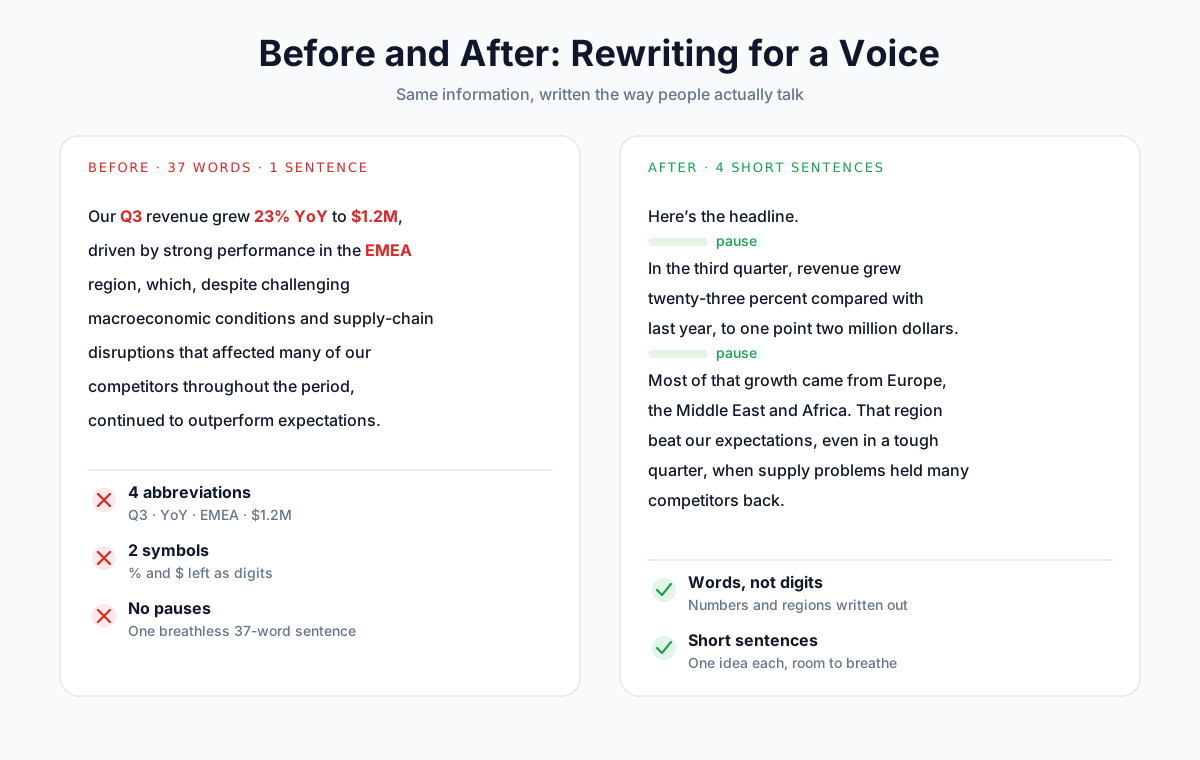
修正前(37語、1文):
Our Q3 revenue grew 23% YoY to $1.2M, driven by strong performance in the EMEA region, which, despite challenging macroeconomic conditions and supply-chain disruptions that affected many of our competitors throughout the period, continued to outperform expectations.
修正後(短い4文):
Here's the headline. In the third quarter, revenue grew twenty-three percent compared with last year, to one point two million dollars.
Most of that growth came from Europe, the Middle East and Africa. That region beat our expectations, even in a tough quarter, when supply problems held many competitors back.
変えたポイント:
| 変更点 | 使った対策 |
|---|---|
| 「Q3」「YoY」「EMEA」を略さずに言葉で書いた | 対策5 |
| 「23%」と「$1.2M」を読み方どおりに書いた | 対策5 |
| 37語の1文を4文に分けた | 対策3 |
| ニュースの前置きとして、短い導入(「Here's the headline.」)を入れた | 対策7 |
| 結果と背景のあいだで段落を分けた | 対策4 |
伝えている情報は同じ。凝ったテクニックも使っていません。それでも、ほぼどの音声で読ませても、後者のほうが人が話しているように聞こえます。
SSMLは使うべき?
SSML(Speech Synthesis Markup Language:音声合成マークアップ言語)は、一部のテキスト読み上げエンジンが受け付けるタグの仕組みです。たとえば、正確な長さの間を入れたり、特定の発音で言葉を読ませたりできます。
<speak>
  Welcome back. <break time="700ms"/> Let's get started.
</speak>
SSMLは、従来型のクラウド音声の多くでは今も使えます。しかし、より新しく表現力の高いモデルでは、無視されたり、一部しか対応していなかったりするケースが増えています。たとえばElevenLabsは、最新のv3・v4モデルがSSMLのbreakタグに対応していないと説明しています。GoogleのChirp 3 HD音声も、対応しているのは一部のタグだけです。
AnySpeechはプレーンテキストで動作します。このガイドの対策がすべて、タグではなく書き方・句読点・設定で解決する方法になっているのはそのためです。これらの方法は、どの声、どのティアでも使えます。
言語ごとのコツ
ここまでの対策の多くは、どの言語にも当てはまります。ただ、英語以外のテキストならではの問題もいくつかあります。
- ネイティブの声を使う。 スペイン語の台本は、スペイン語向けに作られた声で読ませたほうがはるかに自然です。テキスト読み上げの対応言語ページで言語別に探すか、イギリス英語のようにアクセントで選ぶこともできます。
- 数字はその言語の言葉で書く。 複数の言語が混ざったテキストでは、数字が別の言語で読まれてしまうことがあります。
- その言語本来の句読点を使う。 中国語や日本語では全角の記号(。,?)を使い、音声はそれを間として扱います。
- 言語が混ざるテキストは、本番前にテストする。 別の言語の文中に入ったブランド名や英語の用語は、よくあるつまずきポイントです。必要ならつづりを書き換えましょう(対策6)。
自然なAI音声のためのチェックリスト
公開する前に、このリストをひととおり確認しましょう。満たしていない項目があれば、症状別クイック診断の表で、どの対策を使えばよいかがわかります。
- 声が内容に合っている(ナレーター風、会話調、エネルギッシュなど)
- 文が短く、1文に1つの内容になっている
- 人が実際に話すような、くだけた言い回しを使っている
- 話題が変わるたびに段落を分けている
- 金額、日付、時刻、パーセントを読み方どおりに書いている
- 読みにくい名前やブランド名は、つづりを書き換えるか発音辞書に登録してある
- 重要な文では、伝えたい言葉が文末近くにある
- 速度が内容に合っている(ナレーションなら0.9×〜1.0×から)
- 狙ったトーンに合わせて安定性を設定している
- 長い台本は自然な区切りで分け、設定をそろえている
- BGMが声より20 dB以上小さい
- 最初から最後まで、一度通しで聞いた
よくある質問
作ったAI音声が機械っぽく聞こえるのはなぜですか?
たいていは声ではなく、テキストが原因です。長い文、句読点の不足、略語、数字はどれも、AI音声を平坦で早口な読み方にしてしまいます。内容に合わない声、速すぎる速度、高すぎる安定性も、単調に聞こえる原因になります。
最も自然に聞こえるAI音声はどれですか?
内容や言語によって変わるので、同じ台本をいくつかの声で試してみてください。AnySpeechのラインナップでは、AdvancedとProのティアが最も自然な読み方をします。実在の人間の声をクローンしたものは、さらに自然に聞こえることも少なくありません。2025年の PLOS One の研究では、クローン音声は58〜70%の割合で人間の声だと判断されました。
テキスト読み上げで間を入れるには?
句読点を使います。読点(カンマ)で短い間、句点(ピリオド)で文の区切りが入り、段落を分けるといちばん長い間になります。コロンやダッシュは、答えを明かす前のひと呼吸になります。SSMLのbreakタグを受け付けるエンジンもありますが、新しいモデルの多くはこれを無視します。
テキスト読み上げで言葉を正しく発音させるには?
聞こえるとおりのつづりに書き換えます。たとえば「Nguyen」は「Win」、過去形の「read」は「red」と書きます。AnySpeechなら、書き換えたつづりを Pronunciation dictionary(発音辞書)に保存しておけば、すべての音声に自動で適用されます。
AIナレーションに適した速度は?
ほとんどのナレーションには、毎分約150〜155語が合います。ACXによると、オーディオブックのナレーターは平均で1時間に約9,300語を読み、これはおよそ毎分155語にあたります。速度は0.9×〜1.0×から始め、技術的な内容なら少し遅くしましょう。
AI音声で感情を表現できますか?
できます。プレミアムな音声は言葉そのものから感情を読み取るので、気持ちは台本に書き込みましょう(「信じられなかった。」のように)。安定性を下げると、感情の幅が広がります。Proのクローン音声には、感情コントロールも用意されています。
今でもSSMLは必要ですか?
ほとんどのプロジェクトでは不要です。SSMLは従来型のクラウド音声で間や発音を正確に指定するのに便利ですが、新しい表現力の高いモデルでは、一部のタグが無視されることがよくあります。プレーンテキストでできる方法(句読点、つづりの書き換え、数字を読み方どおりに書くこと)なら、どのエンジンでも使えます。
人はAI音声と本物の声を聞き分けられますか?
聞き分けられないことも多いのが実情です。2025年の PLOS One の研究では、聞き手がクローン音声を人間の声だと判断した割合は58〜70%で、本物の人間の録音は62〜81%でした。汎用のAI音声はそれより低く、約40%でした。
次のナレーションは、人間らしい声で
機械っぽい声を直すのに、新しいツールも音響エンジニアも必要ありません。まずは台本から。文を短くし、句読点をきちんと打ち、数字は読み方どおりに書く。そのうえで、声・速度・安定性を微調整しましょう。
さっそく試してみてください。AnySpeechのテキスト読み上げに段落を1つ貼り付けて、まずはそのまま生成。次に対策3〜5を取り入れてから、もう一度生成します。違いははっきり聞き取れるはずです。
著者

カテゴリー
他の記事
YouTube動画を吹き替えする方法:別の言語の音声を追加する手順(2026年版)
YouTube動画を別の言語に吹き替える方法を解説。YouTubeの自動吹き替えとAIで自作する吹き替えの違い、YouTube Studioで多言語音声トラックを追加する手順、費用、品質チェックリストまで。

2026年版テキスト読み上げ完全ガイド:スマホ・PC・動画ツール、プラットフォーム別の使い方
iPhone、Android、Googleドキュメント、TikTok、Discordなど、あらゆるデバイス・プラットフォームでテキスト読み上げを使う方法をステップバイステップで解説。最良の結果を得るためのヒントも満載。
曲からボーカルを除去する方法:カラオケ音源・インストを作る簡単な5つのやり方(2026年版)
AIボーカルリムーバー、Audacity、UVR、DAW、スマホを使って曲からボーカルを除去する方法を手順つきで解説。うまく消えないときの対処法や、法律面の基本もまとめました。