如何用 AI 做音乐:从一个想法到一首完整的歌(2026)
一步步教你用 AI 做音乐:好用的提示词写法、让 AI 唱你自己的歌词、效果不好时怎么改,以及发布前要知道的版权规则。
现在,输入一句话,就能拿到一首三分钟的完整歌曲:有主歌、有副歌,歌手听起来就像真人。
这是简单的部分。难的是做出你心里想的那首歌,而不是一首听过就忘的「标准答案」。
大多数人第一次尝试失败,原因都差不多:提示词太笼统,歌词不好唱,或者第二次不知道该改什么。
这篇指南把这三个问题一次讲清楚。你会一步步学会如何用 AI 做音乐,从写第一句提示词,到拿到一个能放进视频、播客或生日惊喜里的 MP3 成品。
文中每个例子都附上了当时输入的原始提示词或歌词,以及最终生成的歌,你可以自己听出差别。
你将学到:
- 一套六步流程,30 秒的广告歌和完整歌曲都适用
- 一个五要素提示词公式,配真实提示词和对应生成的歌
- 如何用结构标签让 AI 唱你自己写的歌词
- 哪些设置真正有用:人声、时长、排除的风格和创意度
- 怎么修好听起来千篇一律、人声被盖住、歌词唱得太赶的歌
- AI 歌曲在法律上能怎么用,发布前要确认什么
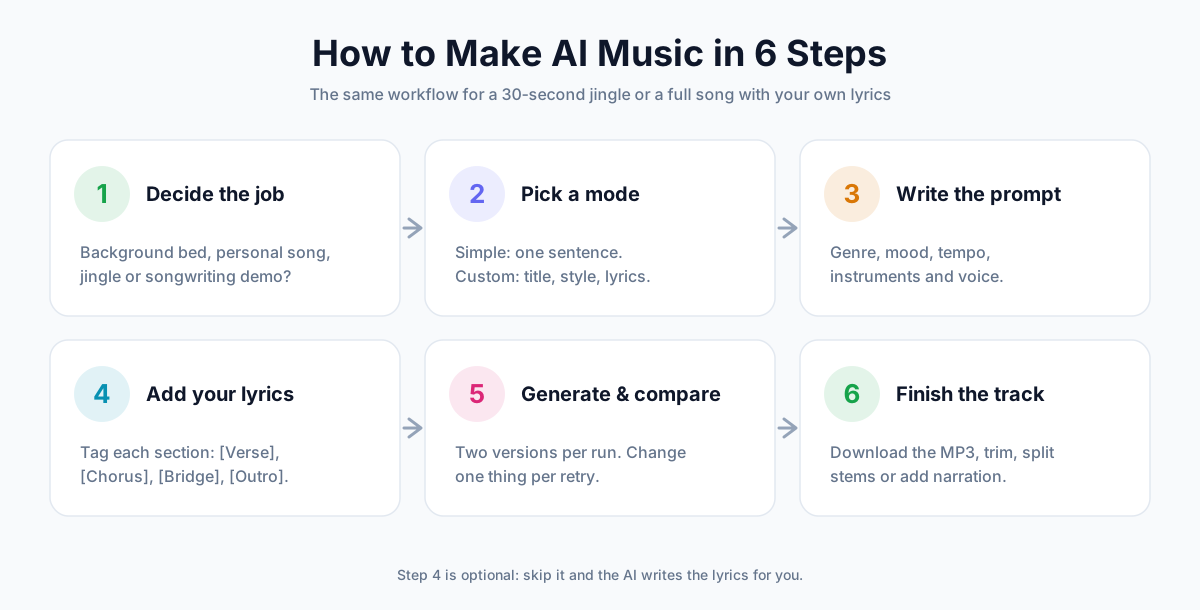
一句话答案: 用 AI 做音乐,打开 AI 音乐生成器,用一两句话描述这首歌:曲风、情绪、速度、乐器和人声。也可以粘贴自己的歌词,并用 [Verse]、[Chorus] 标好段落。点生成,对比返回的两个版本,需要的话改一个细节再生成,最后下载 MP3。一首完整的歌大约一分钟。
AI 音乐生成器是怎么工作的
用好它不需要懂模型原理。但知道它能做什么、不能做什么,可以少浪费很多次尝试。
点下「生成」之后发生了什么
文字生成音乐的模型从海量音乐中学会了文字和声音之间的对应关系。
你描述一首歌,它就一次性写出旋律、和弦、编曲、人声,并完成混音。
它不是把现成的素材循环拼在一起。每首歌都是新生成的,所以同一个提示词永远不会得到完全相同的结果。
哪些你能控制,哪些交给 AI
你的文字决定歌的方向,但不会规定每一个音符。
| 歌曲的组成部分 | 你能控制的 | AI 决定的 |
|---|---|---|
| 曲风和情绪 | 提示词里写的内容 | 你没写到的部分 |
| 歌词 | 自定义模式下的每一个字 | 简单模式下全部由它写 |
| 旋律 | 无法直接控制 | 整段曲调 |
| 结构 | 歌词里的段落标签 | 每个段落内部的编曲 |
| 人声 | 男声或女声,加上描述音色的词 | 具体的音色 |
| 时长 | 自定义模式下 30 秒到 6 分钟 | 选「自动」时通常 2 到 4 分钟 |
最出乎很多人意料的是旋律这一行。你没法哼一段调子让 AI 照着写。你描述感觉,曲调由模型来写。
为什么每次会得到两个版本
每次生成都会用同一份输入返回两首歌。
这是对你想法的两种演绎,不是出错。常常是一个版本主歌更好,另一个副歌更好。选更接近的那个,再在它的基础上调整。
用 AI 做音乐的三种方式
「用 AI 做音乐」其实可以指三件很不一样的事。
| 方式 | 你得到什么 | 需要的技能 | 适合 |
|---|---|---|---|
| 文字生成歌曲 | 一首带人声、已混好音的完整歌曲 | 不需要 | 视频配乐、私人定制歌曲、广告歌、小样 |
| 编曲软件里的 AI 功能 | 帮你做鼓、贝斯、混音或母带 | 基本的制作能力 | 本来就在做音乐的人 |
| AI 分轨与改编工具 | 把一首现成的歌拆成几个部分 | 几乎不需要 | 卡拉 OK、混音改编、练习伴奏 |
这篇指南讲的是第一种,也是大多数人问「如何用 AI 做音乐」时真正想知道的:不用乐器、不用录音设备,从一个想法直接做出成品。
如果你本身就在做音乐,第二种也值得了解。比如 Logic Pro 的 Session Players,就能在你自己的工程里加入 AI 鼓手、贝斯手和键盘手。
第 1 步:先想清楚这首歌用在哪里
想用 AI 做出真正合用的音乐,答案要从这里开始,而不是从提示词开始。用途几乎决定了其他所有选择:要不要人声、多长、用哪种模式、提示词写什么。
所以先回答一个问题:这首歌会在哪里被听到?
按用途选择设置
| 用途 | 人声 | 时长 | 模式 | 提示词要点 |
|---|---|---|---|---|
| 视频或 Vlog 背景音乐 | 纯音乐 | 跟剪辑时长一致 | 自定义 | 写明「background music」,并说清节奏快慢 |
| 播客片头 | 纯音乐 | 30 秒,再自己剪短 | 自定义 | 要求开头短而有力 |
| 生日或婚礼歌曲 | 有人声 | 自动 | 自定义,用你自己的歌词 | 写进名字、地点和共同的回忆 |
| 广告歌 | 可有可无 | 30 秒 | 自定义 | 要求「catchy, singable hook」(抓耳、好唱的副歌) |
| 词曲创作小样 | 有人声 | 自动 | 自定义,用你自己的歌词 | 风格写个大概就行,你要试的是歌词 |
| 学习或专注音乐 | 纯音乐 | 自动 | 简单 | 「lo-fi」「mellow」「no drops」 |
示例:一段一分钟的旅行 Vlog 背景音乐
下面这段纯音乐只为一个用途而做:安静地垫在旅行画面下面。
风格提示词(自定义模式,纯音乐):
upbeat cinematic background music for a travel vlog, warm acoustic guitar, light percussion, soft strings, hopeful and bright两个版本都是 1 分 02 秒,没有人声,正适合垫在旁白下面。
第 2 步:选择简单模式还是自定义模式
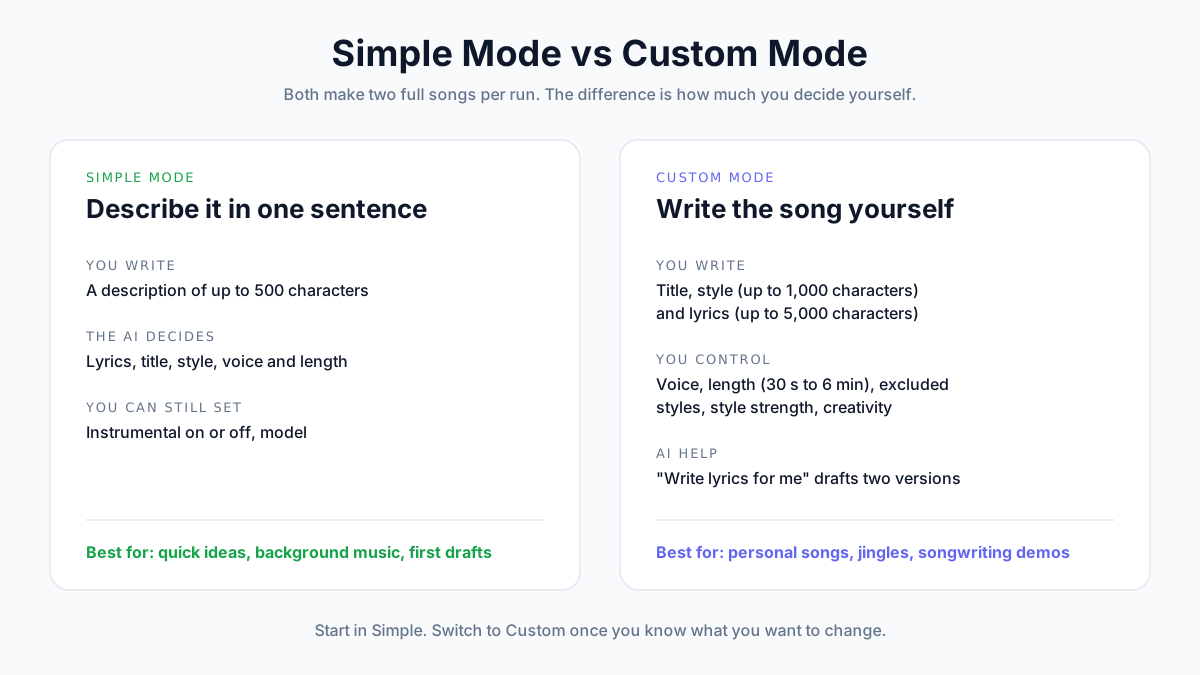
两种模式每次都生成两首完整的歌,区别在于有多少由你自己决定。
简单模式:输入一句话,得到两首歌
在简单模式下,你写一段最多 500 个字符的描述,AI 负责写歌词、定风格、起歌名。
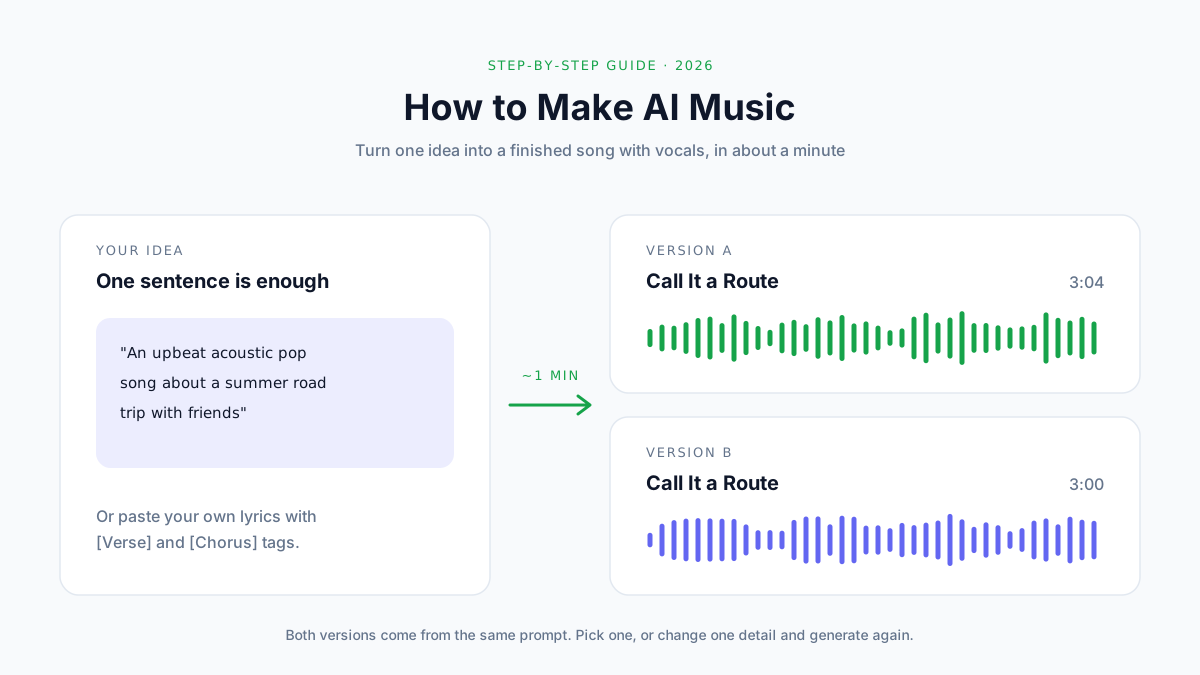
这是验证一个想法最快的方式。下面是一段 65 个字符的提示词:
An upbeat acoustic pop song about a summer road trip with friends歌名「Call It a Route」和全部歌词都是模型自己写的。一切都来自那一句话。
提示词很短时,模型会做什么
短提示词之所以管用,是因为模型会自己补全细节。
这段纯音乐只用了一行提示词:
a calm lo-fi hip hop beat for late-night studying, mellow piano, soft drums, vinyl crackle歌曲附带的风格说明读起来像一份制作人的编曲笔记:「Verse section stays sparse with piano, dust, and drums; a small lift adds filtered keys and tape-wobble before the loop returns.」(主歌只留钢琴、底噪和鼓,比较空;循环回来之前,用滤波键盘和磁带抖动的效果稍微推高一点。)
「稍微推高一点」和「磁带抖动」都不是你要求的,是模型自己的决定。做背景音乐时这很好;如果你脑子里已经有一首具体的歌,就没那么好了。
自定义模式:歌由你来写
自定义模式把输入拆成几个独立的框:
- 标题,最多 80 个字符
- 风格,最多 1,000 个字符,可以自己输入,也可以从曲风、情绪、人声、速度、乐器几组标签里点选
- 歌词,最多 5,000 个字符,或者打开「纯音乐」
它还会解锁下面这些设置。
自定义模式的设置项
| 设置 | 作用 | 什么时候改 |
|---|---|---|
| 人声 | 自动选择人声、男声或女声 | 这首歌需要特定性别的歌手时 |
| 时长 | 自动,或 30 秒到 6 分钟之间的任意长度 | 视频、广告等有固定时长的场景 |
| 排除的风格 | 把你不想要的声音排除在外 | 某种不想要的元素反复出现时 |
| 风格贴合度 | 歌曲贴着你的风格描述走的程度 | 模型老是跑偏到别的曲风时调高 |
| 创意度 | 模型可以偏离常规选择多远 | 想要惊喜就调高,想要稳妥就调低 |
两种模式上方都可以选模型:Studio 音质最佳,Fast 出歌更快,Experimental 风格更大胆。三个模型价格相同。
该用哪种模式?
先用简单模式。它能很快告诉你这个想法到底行不行。
一旦你清楚自己想改什么,比如换成自己的歌词、换个歌手、固定时长,或者去掉某种声音,就切到自定义模式。
第 3 步:写一段好用的提示词
提示词就像写给伴奏乐队的一份说明。对乐队说「弄得好听点」没用,对模型也一样。
五要素提示词公式
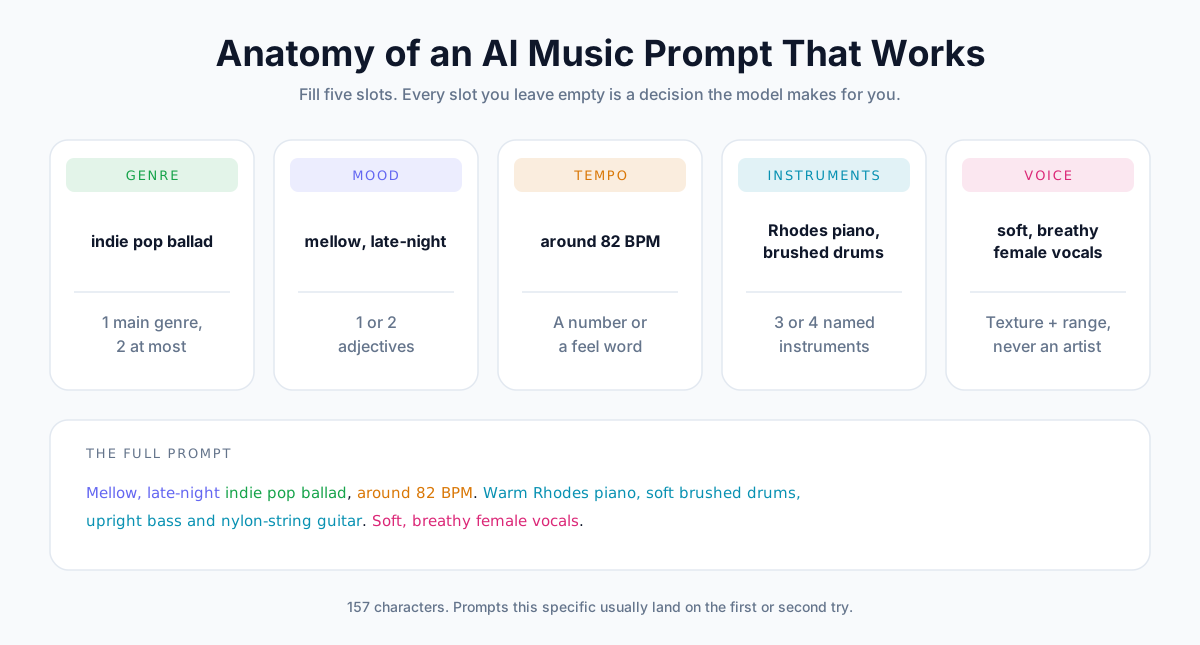
写全五项:曲风、情绪、速度、乐器和人声。 少写一项,模型就替你猜一项。风格提示词建议用英文写,模型理解得最好,所以下面的示例保留英文,括号里附中文意思。
曲风:只选一个主曲风
选一个曲风,最多两个。「indie pop ballad」(独立流行抒情曲)很好用。「jazz metal reggae trap」给了模型四个方向,它只能跟一个。
想要融合风格,就把主曲风放在前面:「R&B with a touch of gospel」(带点福音色彩的 R&B)。
情绪:一两个形容词
「mellow」(柔和)、「euphoric」(狂喜)、「nostalgic」(怀旧)、「dark」(暗黑)。一两个就够了。
情绪词同时影响和弦、唱法和混音,个头小,作用大。
速度:一个数字,或一个感觉
BPM 数字最精确。不知道具体数字时,用描述感觉的词(「slow」「driving」「upbeat」)也可以。
| 风格 | 常见速度 |
|---|---|
| 抒情曲、慢歌、氛围音乐 | 60 到 80 BPM |
| 嘻哈、Boom Bap、R&B | 80 到 100 BPM |
| 流行、摇滚、放克 | 100 到 130 BPM |
| House 和电子舞曲 | 120 到 130 BPM |
| 朋克、鼓打贝斯 | 160 BPM 以上 |
乐器:点名三到四种声音
「Warm Rhodes piano, soft brushed drums, upright bass」(温暖的 Rhodes 电钢琴、轻柔的刷鼓、低音提琴)能让人脑中有画面。只写「instruments」就没有。
乐器超过四五种,混音就会变挤,人声往往会被推到后面。
人声:描述音色,不写人名
描述歌手的声音听起来怎样:「soft, breathy female vocals」(轻柔带气声的女声)、「raspy male vocals」(沙哑的男声)、「powerful soul voice」(有力量的灵魂乐嗓音)、「airy falsetto」(空灵的假声)。
不要写真实歌手的名字。写了名字的提示词会被拒绝(下面会讲)。
弱提示词 vs 强提示词
| 弱提示词 | 强提示词 | 改了什么 |
|---|---|---|
| "a happy song" | "Upbeat acoustic pop around 110 BPM, handclaps, bright guitar, warm male vocals, about a summer road trip" | 五项写全,再加一个主题 |
| "sad piano" | "Slow, melancholic piano ballad around 70 BPM, soft strings, intimate female vocals, about missing an old friend" | 补上情绪、速度、人声和主题 |
| "rap beat" | "Boom bap hip hop around 90 BPM, dusty sampled piano loop, hard-hitting drums, vinyl crackle" | 写明细分曲风和具体声音 |
| "epic music" | "Epic cinematic trailer music, booming drums, rising strings, brass hits, slow build to a huge final hit" | 加上乐器和整首歌的走向 |
描述编曲走向,而不只是音色
最好的提示词会说清楚这首歌怎么推进。
「Call It a Route」附带的风格说明就是这样写的:「Open with guitar and a small percussion pulse, build into buoyant full-band choruses, then pull back for a more intimate bridge before a final lifted chorus.」(以吉他和轻打击乐开场,副歌推到轻快的全乐队,桥段收回来变得更私密,最后一遍副歌再把情绪抬起来。)
在自定义模式里,你也可以自己写这样一句。「Starts with solo piano, drums enter at the chorus, quiet last verse」(钢琴独奏开场,副歌进鼓,最后一段主歌安静下来)就够了。
描述声音,不要写歌手名字
提示词里出现真实歌手或乐队的名字会被拒绝,积分会退回你的余额。
改为描述你喜欢那位歌手的哪些地方:
- 年代: 「early 2000s pop-punk」(2000 年代初的流行朋克)、「80s synth-pop」(80 年代合成器流行)
- 嗓音: 「husky alto」(略带沙哑的女中音)、「bright tenor with vibrato」(带颤音的明亮男高音)
- 制作: 「big gated drums」(大门限混响鼓)、「lo-fi bedroom recording」(低保真卧室录音)、「dry, close-mic vocals」(干声、近距离收音的人声)
这样往往更接近你想要的声音,因为你说出的正是你在乎的那几点。
用「排除的风格」去掉反复出现的东西
如果每个版本都带着你没要的自动修音(autotune),不用重写整段提示词,把「autotune」填进自定义模式设置里的排除的风格即可。
每项排除词尽量短,两三个词就够。
不同曲风的提示词示例
下面每一段都是真实用过的风格提示词,后面附上它生成的 A 版本。
另类摇滚
Energetic alternative rock at around 150 BPM. Driving live drums with crashing cymbals, crunchy overdriven electric guitars, punchy bass and a soaring guitar solo before the last chorus.前卫浩室(Progressive House)
Euphoric progressive house EDM at 126 BPM. Bright supersaw chords, pulsing sidechained bass, four-on-the-floor kick, shimmering arpeggios and big risers.R&B 慢歌
Smooth contemporary R&B slow jam around 80 BPM. Warm Rhodes electric piano, deep round sub bass, crisp finger snaps and soft rolling hi-hats, subtle clean guitar licks.注意它们的规律:先写曲风和速度,再点名三到五种声音。没有一段超过 200 个字符左右。
第 4 步:加入你自己的歌词
想让 AI 做出一首真正属于你的歌,就靠这一步。简单模式会替你写歌词,自定义模式则会唱出你粘贴进去的任何歌词。
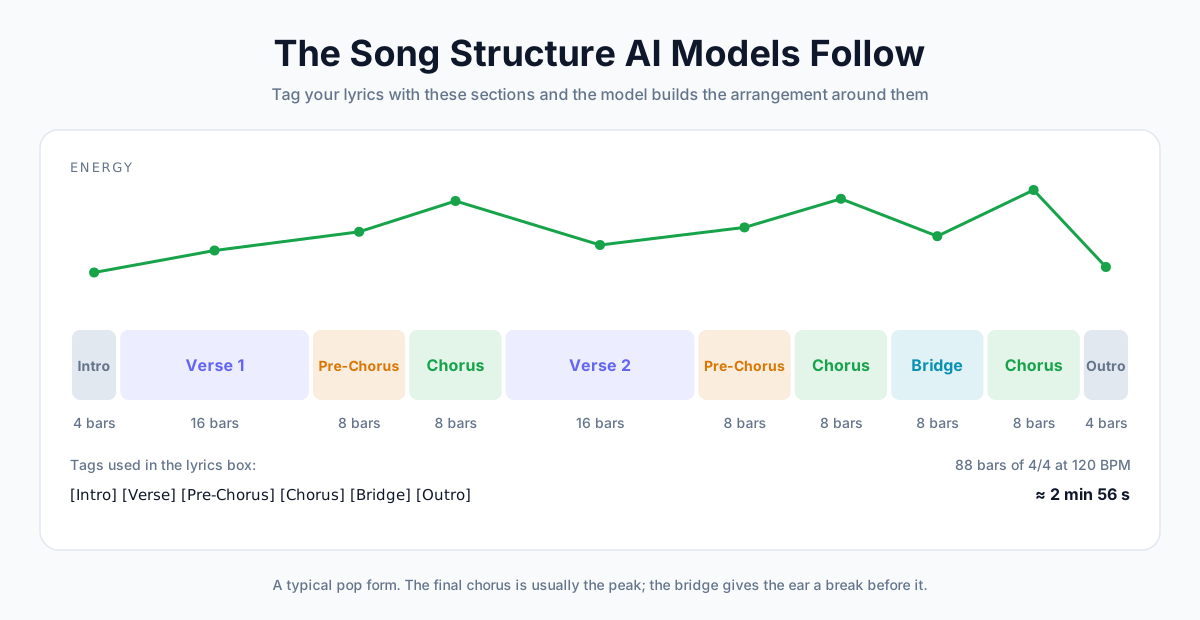
模型能识别的结构标签
在每个段落前单独一行,用方括号写上标签。模型靠它们判断哪里该推高、哪里该收住。
| 标签 | 作用 | 常见长度 |
|---|---|---|
[Intro] | 前奏,常常没有人声 | 一两行,或者不写歌词 |
[Verse] | 主歌,讲故事,旋律相对平稳 | 4 到 8 行 |
[Pre-Chorus] | 预副歌,为副歌蓄势 | 2 到 4 行 |
[Chorus] | 副歌,最抓耳、重复最多的部分 | 4 到 6 行 |
[Bridge] | 桥段,在最后一遍副歌前换个角度 | 2 到 4 行 |
[Outro] | 尾奏,让歌慢慢收尾 | 一两行,或者不写歌词 |
带编号的写法,比如 [Verse 2] 或 [Final Chorus],也很常见,歌词长的时候方便你自己对照。
一份真实的歌词,以及它变成的歌
下面是「Paper Cup Rain」歌词的前半部分,和当时输入的一字不差:
[Verse 1]
Late night, the windows shine
Rain keeps time on the glass
You trace circles in the steam
Like you don't want this to pass

[Pre-Chorus]
And I swear the whole room leans
When you say my name like that
The storm can knock outside
But it can't pull us back

[Chorus]
Stay here with me
Stay here with me
Let the rain talk loud tonight
Stay here with me
Stay here with me
Till the glass turns silver-white
风格提示词是「Mellow late-night indie pop ballad around 82 BPM. Warm Rhodes piano, soft brushed drums, round upright bass, and gentle nylon-string guitar.」(柔和的深夜独立流行抒情曲,约 82 BPM,温暖的 Rhodes 电钢琴、轻柔的刷鼓、圆润的低音提琴和柔和的尼龙弦吉他。)
完整歌词还有第二段主歌、一段桥段和最后一遍副歌,整首歌长 3 分 33 秒。
怎样写出 AI 好唱的歌词
模型什么都会试着唱。下面这些习惯能让它唱得更自然。
每行写短一点
每行 6 到 10 个音节比较舒服。中文一个字就是一个音节;英文例句「Late night, the windows shine」是 6 个音节。
行太长就会唱得很赶,歌手得把字硬塞进节拍里。
对应的两行字数差不多
共用同一段旋律的几行,字数要大致相同。如果第一行 7 个字、第三行 14 个字,模型只能硬挤或硬拉。
重复副歌的记忆点
副歌反复唱同一句短语,好唱也好记。上面的副歌里,「Stay here with me」出现了四次。
句尾押韵
句尾押韵(比如英文的「glass」和「pass」)能给旋律天然的落脚点。不必押得很严。
数字和生僻字写成好唱的样子
数字直接写成汉字,比如写「二〇二六」而不是「2026」;容易读错的字词换个写法。第一次生成把特殊的名字唱错了,可以试着换成读音相同的常用字。
让 AI 先写草稿,你再修改
不知道从何下笔?在自定义模式里,点 AI 帮我写词,输入一句话的想法(最多 150 个字符),就能得到两版完整的歌词草稿。
付费套餐写歌词不消耗积分,每天最多 50 次。
把草稿当作起点,换上真实的名字、地点和细节。正是这些细节,让一首普通的歌变成专属于某个人的歌。
用其他语言写歌词
想让它用哪种语言唱,歌词就用哪种语言写。模型能唱英语和大多数主要语言,包括西班牙语、葡萄牙语、法语、德语、日语、韩语和中文。
风格提示词仍然用英文写。不管歌词是什么语言,「indie pop」「brushed drums」这类风格词用英文效果最好。
第 5 步:生成、对比、迭代
点「生成音乐」。两首歌通常一分钟左右就到。
听的时候注意什么
先把两个版本各完整听一遍,再检查五件事:
- 前十秒。 开头是不是你要的情绪?
- 人声。 清楚吗,还是被乐器盖住了?
- 副歌。 和主歌比,有没有推上去?
- 歌词。 每一行都唱到了吗,顺序对不对?
- 结尾。 是好好收尾了,还是一句没唱完就停了?
哪里听着不对,可以直接跳到常见问题的解决方法,找最可能的改法。
每次只改一处
如果曲风、速度和人声一起改,你就没法知道是哪一处起了作用。
边做边简单记一下:
| 第几次 | 改了什么 | 重点听什么 |
|---|---|---|
| 1 | 什么都没改:第一次生成 | 哪个版本更接近? |
| 2 | 加上「around 90 BPM」 | 律动现在对了吗? |
| 3 | 排除「autotune」 | 人声更自然了吗? |
| 4 | 把副歌的句子改短 | 副歌更容易跟着唱了吗? |
你做的每一首歌都会保存在历史记录里,后面某一次改坏了,也能回到之前的版本。
每次生成的花费
在 AnySpeech,每次生成消耗 1,000 积分,返回两首歌。生成失败时积分会自动退回。
Basic 套餐每月 50,000 积分,够生成 50 次;如果全部用来做音乐,就是 100 首歌。其他套餐见价格页。
第 6 步:下载并完成成品
生成的歌已经混好音,可以直接用。再花几分钟收尾,能让它更贴合你的用途。
下载 MP3 和歌词
把你喜欢的版本下载为 MP3;如果要做字幕或歌词视频,顺手复制歌词。
剪辑、淡出、调音量
任何音频或视频编辑软件都能做这些基础处理:Audacity、GarageBand、剪映(CapCut),或者你平时用的剪辑软件。
- 剪短到视频或广告位的长度
- 如果提前截断,最后几秒加个淡出
- 有人声说话时,压低音乐,让每个字都听得清
要发到流媒体平台?别把音量推得太大。根据 Spotify 的响度标准化说明,它默认会把歌曲调整到 -14 dB LUFS,并建议真峰值保持在 -1 dB 以下。母带做得再响,也只会被调小。
拆成分轨
需要卡拉 OK 版本,或者单独的人声?把歌放进去人声工具,就能得到伴奏和干声。
想保留 AI 写的旋律、换成你自己录的人声,也是这个办法。详细步骤见我们的如何去除歌曲人声指南。
加旁白,或者做成播客
一首歌往往只是项目的一半。写好旁白稿,用 AI 文字转语音生成配音,再在任意剪辑软件里叠到纯音乐上。
做节目的话,先做一段简短的纯音乐片头,再用 AI 播客生成器做出整期节目。
如何解决 AI 音乐的常见问题
大多数不理想的结果都出自少数几个原因,每个都有快速的改法。
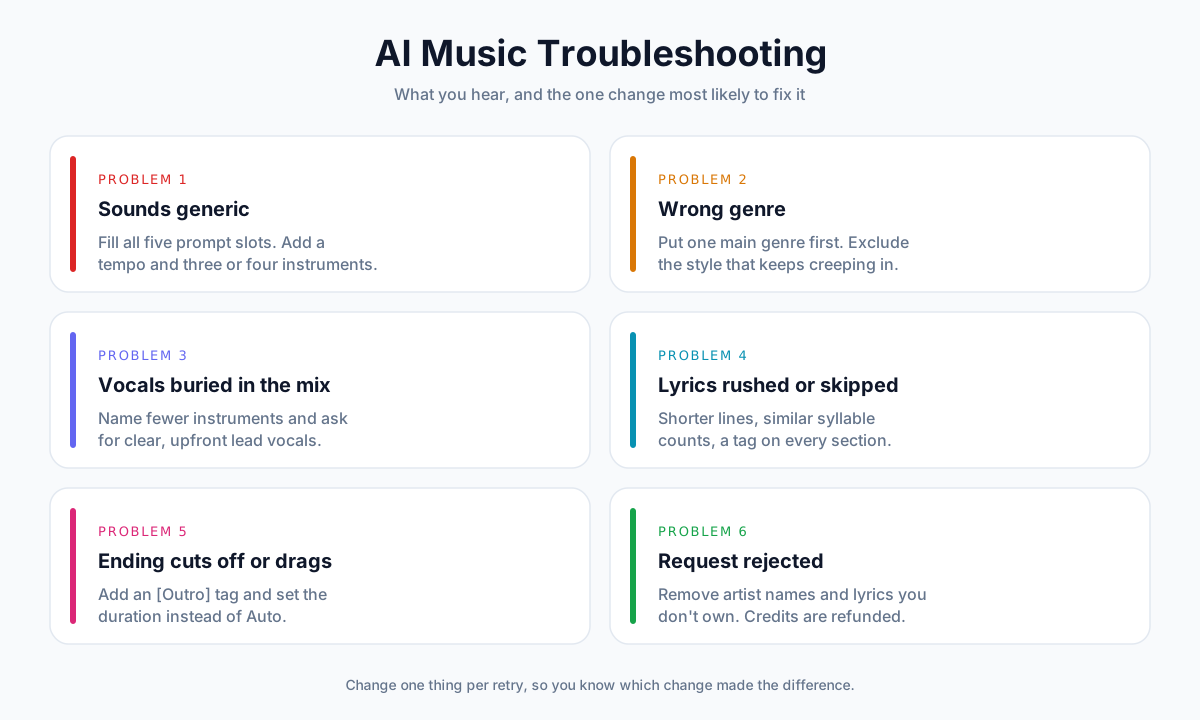
问题 1:歌听起来千篇一律
原因: 提示词把大部分决定都留给了模型,于是它每一项都选了最常见的。
改法: 把提示词公式的五项写全。加上速度和三四种具体乐器,变化最明显。
问题 2:曲风不对
原因: 一段提示词里塞了太多曲风,或者用了一个人人理解不同的曲风词。
改法: 把一个主曲风放在最前面。如果另一种风格老是混进来,就把它加进「排除的风格」。调高「风格贴合度」也能让模型更贴着你的描述走。
问题 3:人声被盖住
原因: 编曲太满。六种乐器都挤在中频,歌手就被推到了后面。
改法: 少写几种乐器,并要求「clear, upfront lead vocals」(清晰、靠前的主唱)或「intimate, close-mic vocals」(私密、近距离收音的人声)。
问题 4:歌词唱得太赶、重复或被跳过
原因: 句子太长、对应的几行字数不均,或者段落没有标签。
改法: 把句子改短,让对应的几行字数接近,每个段落前都加标签。如果某一段老是被漏掉,就把它删短。
问题 5:结尾突然断掉或拖得太长
原因: 模型没有收到这首歌该在哪里结束的信号。
改法: 加一个 [Outro] 标签,写一两句收尾的歌词;或者把时长从「自动」改成固定值。
问题 6:请求被拒绝
原因: 提示词或歌词里出现了真实歌手的名字、包含你没有版权的歌词,或者违反了内容政策。
改法: 描述声音,不写歌手名字,歌词用你自己写的。被拒绝的那次生成,积分会退回。
AI 音乐可以商用吗?
做出一首歌很简单,规则是从发布那一刻开始的。
平台在收紧规则,因为 AI 歌曲的数量实在太大。2026 年 7 月,Deezer 称每天收到将近 90,000 首完全由 AI 生成的歌曲,在高峰日占当天全部投递量的 50% 以上,但 AI 音乐只占总播放量的 1–3%(Deezer)。
以下是截至 2026 年 10 月的情况,仅供参考,不构成法律建议。
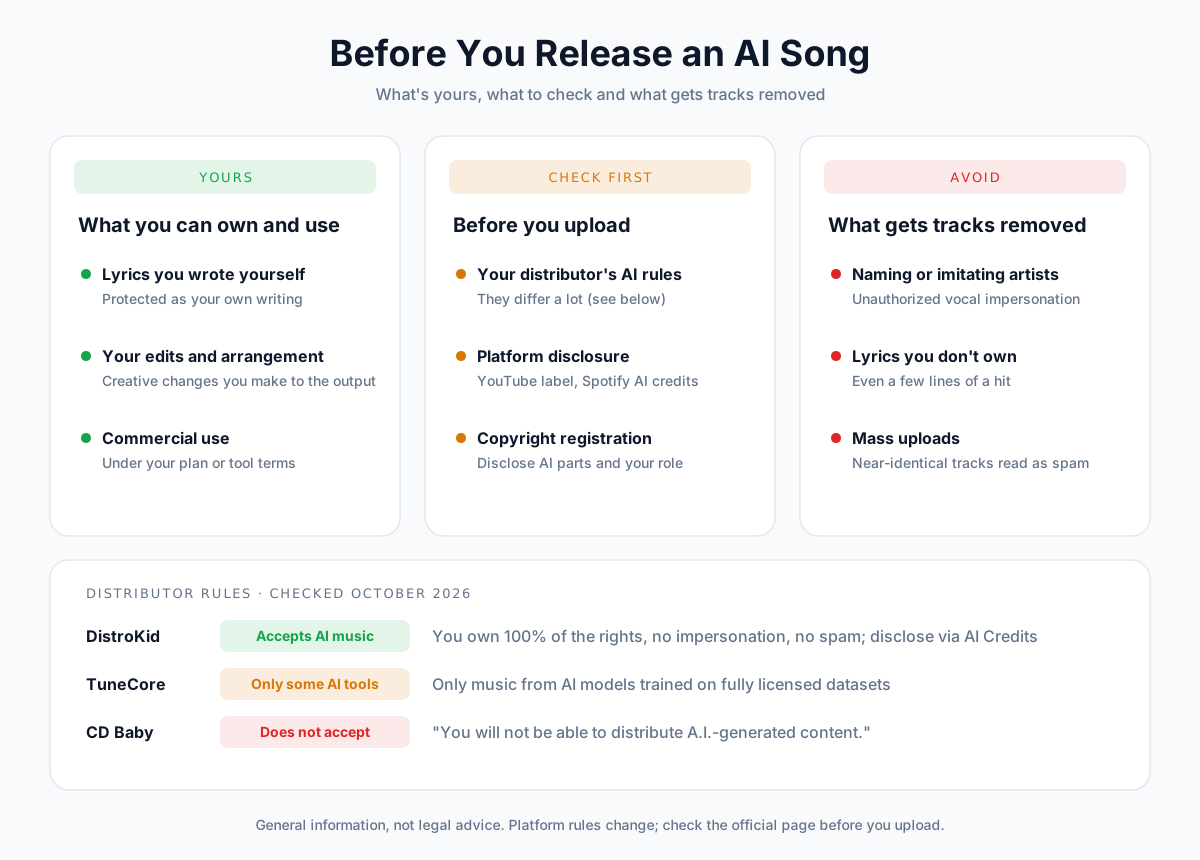
商用授权不等于版权
有两个问题经常被混为一谈。
- 商用授权是指工具的条款允许你怎么用这首歌:放进有收益的视频、广告或产品里。在 AnySpeech,付费套餐生成的每首歌都包含商用授权。
- 版权是指你能不能阻止别人复制这首歌。这由法律决定,不由工具决定。
你可以有前者而没有后者。对现在的 AI 音乐来说,这很正常。
AI 生成的歌归谁所有?
在美国,最清楚的依据是美国版权局 2025 年 1 月发布的报告(Copyright and Artificial Intelligence, Part 2)。
报告的关键结论:
- 版权不延及纯由 AI 生成的内容,也不延及人类对表达性元素控制不足的内容。
- 以目前普遍可用的技术来看,仅靠提示词不足以构成足够的控制。
- 人类作者对自己能在 AI 输出中被感知到的作品享有版权,对素材所做的创造性选择、编排或安排,以及对输出的创造性修改,也享有版权。
落到实际中:
| 这首歌的来源 | 在美国大概率的版权状态 |
|---|---|
| 一句提示词,其余全部由 AI 完成 | 不受保护:光有提示词不够 |
| 你自己写的歌词,AI 作曲和演唱 | 你的歌词受保护,AI 生成的部分不受保护 |
| 你编辑、重新编排或重新录唱过的 AI 输出 | 你的修改可能受保护,需个案判断 |
如果你要登记一首含有 AI 内容的歌,版权局要求你说明哪些部分由 AI 生成,以及你自己贡献了什么。
所以,自己写歌词不只是创作上的选择。在一首 AI 歌曲里,这是你最能明确称为「属于自己」的部分。
把 AI 音乐上传到 Spotify
Spotify 并不禁止用 AI 做的音乐。用它自己的话说,这些规则「not about punishing artists who use AI responsibly」(不是为了惩罚负责任地使用 AI 的音乐人)(Spotify,2025 年 9 月)。
它真正管的是这几件事:
- 冒充: 只有在被模仿的歌手授权的情况下,Spotify 上的音乐才允许模仿其嗓音。
- 垃圾内容: 音乐垃圾内容过滤器专门针对批量上传和近似重复的歌曲。Spotify 称过去 12 个月已删除超过 7,500 万首垃圾歌曲。
- 披露: 你可以通过发行商添加可选的 AI 署名信息(AI credits),告诉听众 AI 在哪些环节参与了制作。
- AI 虚拟歌手: 从 2026 年 8 月起,身份可能由 AI 生成的艺人会被打上 AI Persona 标识,并默认不进入编辑推荐和算法推荐。这个标识「is about the artist's public identity, not about how the music was made」(针对的是艺人的公开身份,而不是音乐的制作方式)(Spotify,2026 年 8 月)。
发行商对 AI 音乐的规定
你没法直接把歌上传到 Spotify 或 Apple Music,要通过发行商代为上架,而各家发行商的 AI 政策差别很大。
| 发行商 | 接受 AI 音乐吗? | 规则要点 |
|---|---|---|
| DistroKid | 接受,但有条件 | 你必须拥有 100% 的权利,不得冒充他人,不得批量发布垃圾内容(DistroKid) |
| TuneCore | 只接受部分 AI 工具 | 只发行由「trained on fully licensed datasets」(完全使用授权数据训练)的 AI 模型生成的音乐(TuneCore) |
| CD Baby | 不接受 | 「You will not be able to distribute A.I.-generated content.」(你无法发行 AI 生成的内容。)(CD Baby) |
TuneCore 的规则取决于 AI 模型的训练方式,而大多数用户无从核实。我们无法保证用我们的生成器做的歌符合这一条,所以上传前请先向 TuneCore 确认。
在 YouTube 上发布 AI 音乐
YouTube 要求创作者披露逼真的 AI 生成内容,「AI generated music」(AI 生成的音乐)就是它列出的例子之一。这条规则特别点明了「creates music that's the main focus of the video」(制作作为视频主体的音乐)的内容(YouTube 帮助中心)。
所以,如果这首歌本身就是视频的重点,比如歌词视频或音乐作品,就打开披露选项。如果只是垫在你自己旁白下面的轻音乐,规则写得没那么明确。
拿不准就披露。YouTube 表示,单纯披露 AI 内容不会限制视频的观众范围,也不影响赚钱资格。反复不披露的创作者可能受到处罚,最严重会被移出 YouTube 合作伙伴计划。
另外还有两点:
- 变现: 对于批量生产、套模板、没有原创内容的视频,YouTube 一律不付费,不管是不是 AI 做的。我们的如何用 AI 配音开一个不露脸的 YouTube 频道指南详细讲了这条政策。
- Content ID: YouTube 没有公布过关于 AI 音乐和 Content ID 的规定。Content ID 是为拥有独家权利的版权方设计的,而纯 AI 生成的内容在美国无法获得版权,所以别指望能用它认领 AI 歌曲。
要避免的做法
下面这些做法会让 AI 歌曲被删除、降低推荐或被拒:
- 写出或模仿真实歌手。 改为描述声音。
- 使用你没有版权的歌词, 哪怕只是一首名曲里的几句。
- 批量上传几十首几乎一样的歌。 垃圾内容过滤器会发现。
- 平台或发行商要求披露时不披露。
常见问题
怎样免费用 AI 做音乐?
有些 AI 音乐工具提供免费额度,通常有每日次数限制,条款也往往不允许商用。用它们做的东西发布之前,先看清授权条款。在 AnySpeech,音乐生成是付费套餐的功能,最便宜的套餐每月可以做 100 首歌,并且包含商用授权。
怎样用自己的歌词做一首 AI 歌曲?
切换到自定义模式,把歌词粘贴进「歌词」框,每个段落前加上 [Verse] 或 [Chorus] 这样的标签,写好风格,然后生成。句子写短一点,副歌里重复你的记忆点。
能用我自己的声音做 AI 歌曲吗?
不能直接做到:生成器用的是它自己的歌手。你可以先生成歌曲,用去人声工具去掉 AI 人声,再在伴奏上录你自己的声音。
能用 AI 翻唱一首现有的歌吗?
用有版权的歌词不行。我们的生成器会拦截你没有版权的歌词,而且发行翻唱作品本来就需要取得原曲的机械复制许可。你可以写一套风格相近的新歌词,只要不写出或模仿真实的歌手。
用 AI 做一首歌要多久?
每次生成大约一分钟,每次给你两首歌。写好提示词或歌词花的时间,往往比生成本身更长。
AI 生成的歌最长能有多长?
选「自动」时,歌曲通常在两到四分钟之间。在自定义模式里,可以设成 30 秒到 6 分钟之间的任意长度。
AI 能做没有人声的音乐吗?
能。两种模式里都可以打开「纯音乐」。纯音乐最适合做视频背景、播客片头和学习专注音乐。
AI 能用英语以外的语言唱歌吗?
能。想用哪种语言唱,就用哪种语言写歌词或描述想法。风格提示词用英文写效果最好。
AI 生成的音乐有版权吗?
在美国,如果完全由 AI 生成,就没有。美国版权局认为,纯 AI 生成的内容不受保护,光有提示词也不够。你自己写的歌词、你做出的创造性修改则可能受保护。本文介绍的是美国的情况,其他国家的规定各不相同。
可以把 AI 音乐上传到 Spotify 吗?
可以,通过接受 AI 音乐的发行商上传,比如 DistroKid。Spotify 不禁止用 AI 做的音乐,但会删除未经授权的嗓音冒充和垃圾内容,并允许你通过可选的 AI 署名信息披露 AI 的使用情况。
用 AI 做音乐需要懂乐理吗?
不需要。你用平常的话描述这首歌,旋律、和弦和编曲都由模型完成。懂一点术语,比如 BPM 或歌曲段落的名称,能帮你更接近想要的效果。
哪个 AI 做音乐最好?
评判任何 AI 音乐生成器,看四点:人声是否真实、能否用你自己的歌词、商用授权是否清楚,以及每首歌的成本。然后用你真正会用的提示词实际试一试。
总结
用 AI 做音乐只要一分钟,做出你心里想的那首歌,靠的是一份好的说明。
简单回顾一下:
- 先确定用途。 人声、时长和模式都由它决定。
- 先用简单模式验证想法,再切到自定义模式。
- 提示词写全五项: 曲风、情绪、速度、乐器和人声。
- 给歌词加上标签,句子短一点、好唱一点。
- 每次只改一处,并对比两个版本。
- 发布前看清规则,了解你要发布的平台怎么规定。
现在你已经知道如何用 AI 做出心里想的那首歌了。打开 AI 音乐生成器,输入一句话,大约一分钟就能听到它的两个版本。
要给节目做片头?我们的如何制作 AI 播客指南讲了整期节目的其余部分。
作者

分类
更多文章
如何让 AI 配音不那么机械:12 个实用方法(2026)
AI 语音为什么听起来像机器人?12 个真正有效的方法:为耳朵写稿、用标点控制停顿、把数字写成文字、纠正发音、调好语速和声音设置。

将文字转换为音频:文本转音频完整指南(2026)
几分钟内用 AI 语音将文字转换为音频。免费工具推荐、分步操作指南、语音质量对比,以及适合内容创作者、教育工作者和营销人的实用技巧。
如何把音频转成文字:2026 完整分步指南
学会如何快速把音频或视频转成文字。包含分步操作流程、7 项准确度自查清单、支持的格式,以及会议、采访、字幕等场景实操手册。