如何让 AI 配音不那么机械:12 个实用方法(2026)
AI 语音为什么听起来像机器人?12 个真正有效的方法:为耳朵写稿、用标点控制停顿、把数字写成文字、纠正发音、调好语速和声音设置。
你把稿子贴进去,点一下生成,出来的声音……还行。清楚,但平。列举时一口气念完,重音落错地方,"$1.2M" 读得像在念表格。
但有一点可能出乎你的意料:如今问题很少出在技术本身。2025 年发表在 PLOS One 上的一项研究发现,听众在 58–70% 的情况下会把 AI 克隆的声音判断为真人,和真人录音的 62–81% 已经相差不远。
所以,今天 AI 配音听起来机械,原因通常出在稿子和设置上,而不是引擎。这两样都能在几分钟内改好。
这篇指南会告诉你具体怎么做。
这篇文章会告诉你:
- 让 AI 语音听起来机械的五个原因
- 如何快速判断你的音频哪里出了问题
- 12 个方法,从改写稿子到调整声音设置
- 不写任何代码,如何控制停顿、数字和发音
- AI 旁白的语速应该是多少,附真实数据
- 一个可以直接照抄的完整改写示例
一句话答案: 想让 AI 配音不那么机械:用短句、像说话一样写;用逗号、句号和分段制造停顿;把数字和缩写写成文字;把读错的词按读音重写;选一个适合内容的声音。然后把语速稍微放慢,把稳定性稍微调低,让表达更有起伏。在 AI 文字转语音工具 里,这些大多只需要几秒钟。
AI 语音为什么听起来像机器人?
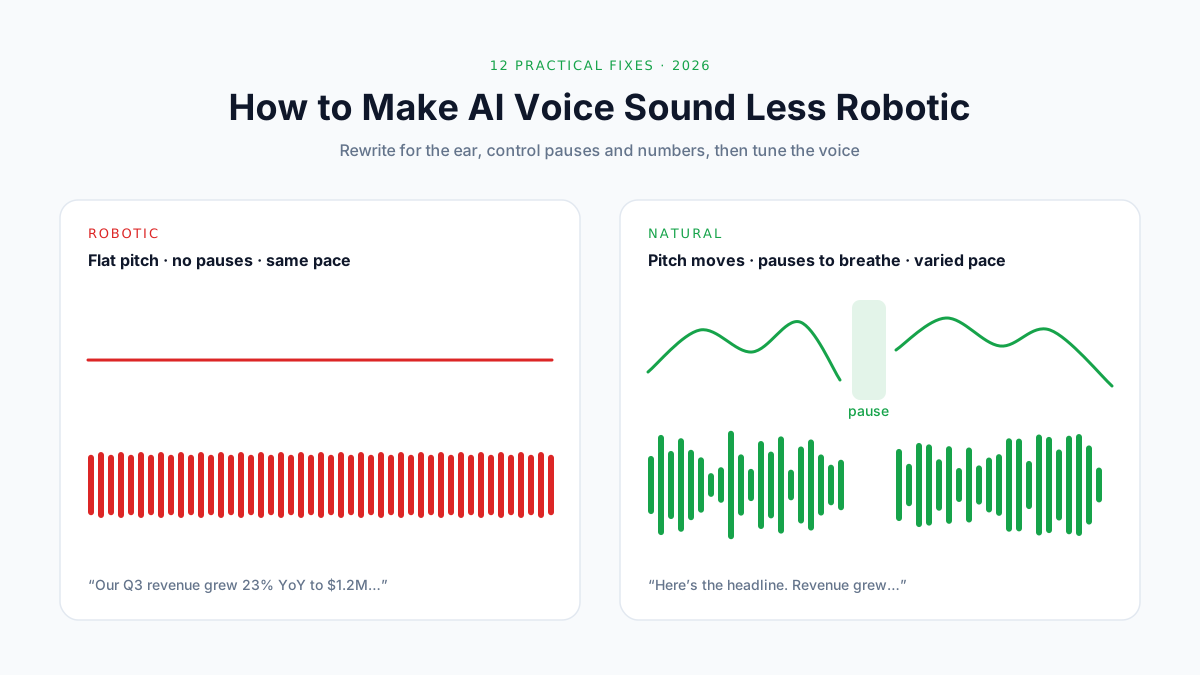
当 AI 语音的节奏、音高和停顿与人真实说话的方式对不上时,它听起来就会像机器人。 人说话时会变换快慢、让音调起伏、停下来换气,并且重读关键的词。合成语音做不到这些时,就会显得机械。
五个原因
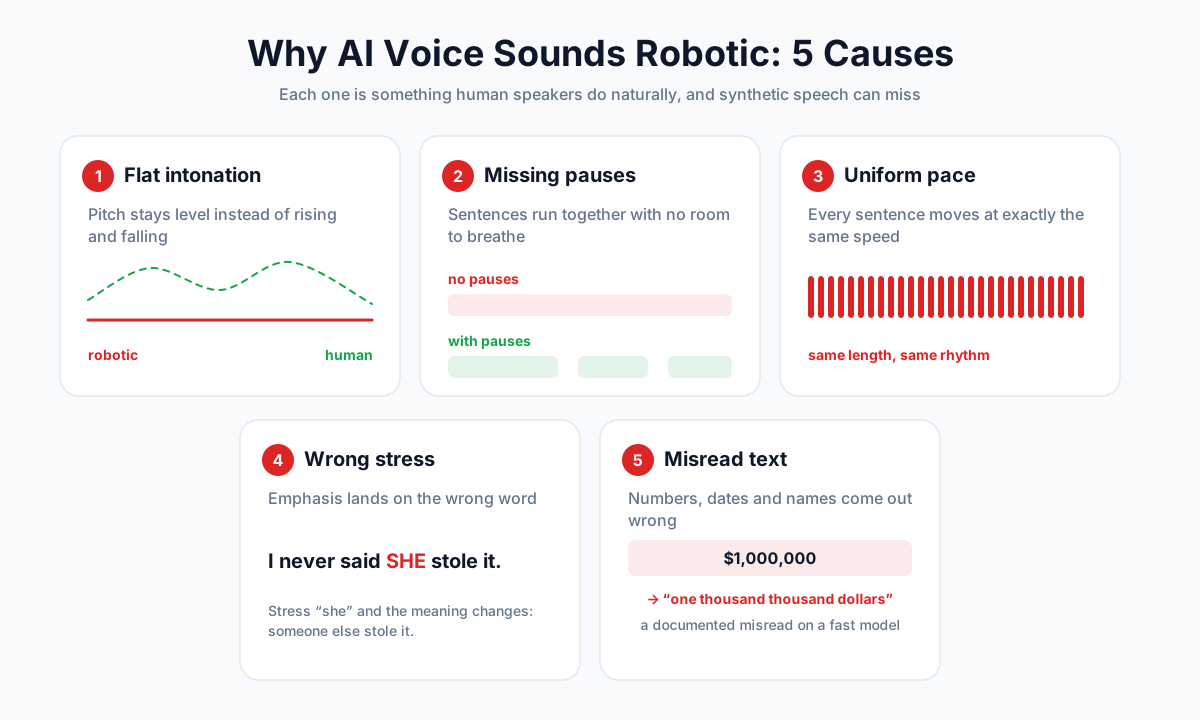
- 语调平淡。 音高一直是平的,不会随着意思起伏。
- 缺少停顿。 句子一句接一句,没有换气的空间。
- 语速一成不变。 每句话都用完全相同的速度念。
- 重音错误。 强调落在错误的词上,意思就变了。
- 文字被读错。 数字、日期、缩写和人名读得不对。
最后一点,研究者称为文本正则化(text normalization),也就是把书面文字转换成语音能说出口的词。即使对现代系统来说这也不容易,因为 "1/2" 根据上下文,可能是"二分之一"、"1 月 2 日"或"2 月 1 日"。
AI 语音已经进步了多少
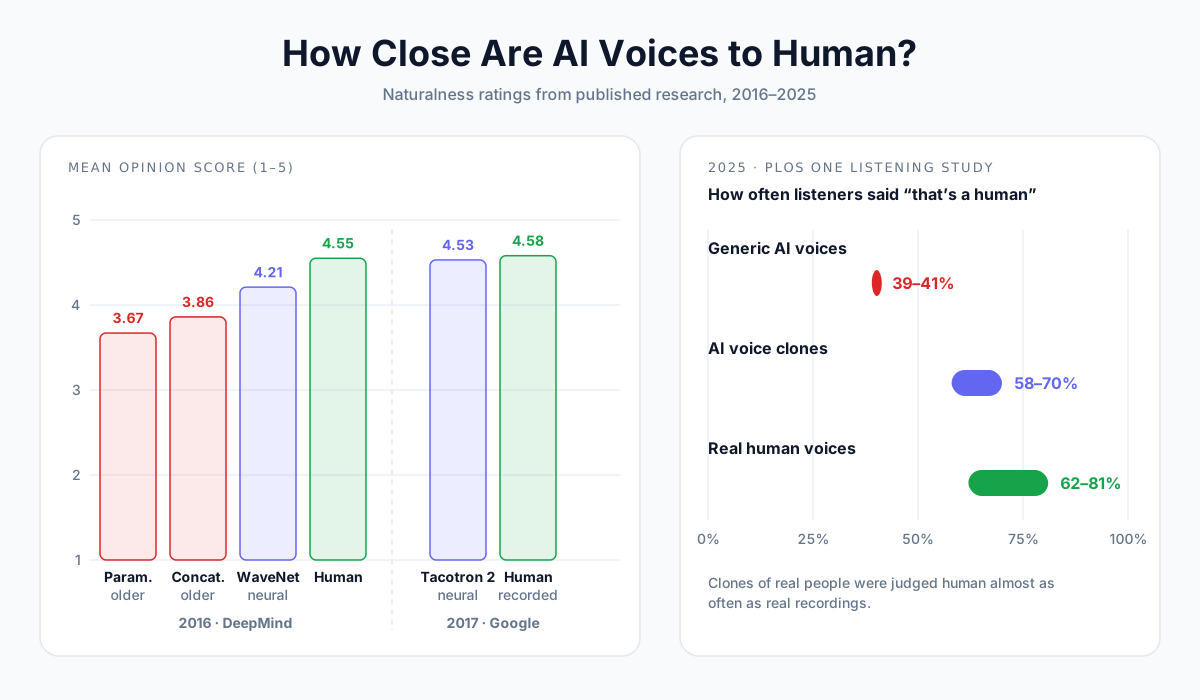
语音科学家用平均意见分(MOS)来衡量自然度:听众给音频片段打分,从 1(很差)到 5(很好)。
| 年份 | 里程碑 | 分数 |
|---|---|---|
| 2016 | 旧式"参数合成"和"拼接合成"声音(就是早年导航那种机械声) | 3.67 和 3.86 分;真人 4.55 分 |
| 2016 | DeepMind 的 WaveNet,第一个有影响力的神经网络语音 | 4.21 分 |
| 2017 | Google 的 Tacotron 2 | 4.53 分,录音为 4.58 分 |
| 2022 | 微软的 NaturalSpeech | 与录音没有统计学上的显著差异 |
| 2025 | PLOS One 听感研究 | 克隆声音 58–70% 的时候被判断为真人;真人为 62–81% |
同一项研究还发现,通用 AI 声音(不是从真人克隆的)只有约 40% 的时候被判断为真人。这个差距很关键,我们在第 11 个方法里还会提到。
如今大多数"机械感"都是稿子的问题
现代的声音已经可以听起来像真人了。但它们只会一字不差地念你给的内容。
一句 45 个词、夹着三个缩写和一个金额的长句,几乎用什么声音念都会显得机械。同样的意思,改写成适合听的版本,大多数声音都能念得很自然。所以下面的方法,大部分都和文字有关。
快速诊断
改之前,先完整听一遍,说出问题在哪里,再直接跳到对应的方法。
| 你听到的问题 | 可能的原因 | 对应方法 |
|---|---|---|
| 平淡、单调 | 声音不适合内容,或稳定性调得太高 | 1、2、9 |
| 意思之间没有喘息的空间 | 句子太长,逗号和分段太少 | 3、4 |
| 念得太赶、上气不接下气 | 语速太快,列举全塞在一句话里 | 3、8 |
| 重音落在错误的词上 | 关键词埋在句子中间 | 7 |
| "$1,000,000" 读得很奇怪 | 数字和符号保留了原样 | 5 |
| 人名或品牌名读错 | 生僻词,拼写和读音没有明显对应 | 6 |
| 每一段听起来都不太一样 | 长稿分段生成时用了不同设置 | 10 |
| 听起来"太干净",像实验室录音 | 音频太干,没有底噪或背景音乐 | 12 |
12 个方法
方法 1:从选对声音档位开始
AI 声音并不都一样。更快、更便宜的模型适合打草稿,高端模型处理节奏和情绪更好。
在 AnySpeech 上,同一段文字可以用五个档位生成:
| 档位 | 最适合 | 值得了解 |
|---|---|---|
| 基础 | 草稿、长文朗读、无障碍用途 | 免费,可在免费文字转语音使用 |
| 标准 | 覆盖的语言和口音最广 | 300+ 种声音,40+ 种语言 |
| Flash | 短小、活泼、口语化的内容 | 快速且富有表现力;每次最多 5,000 个字符 |
| 高级 | 70+ 种语言的自然旁白 | 我们大多数配音的默认选择 |
| 专业 | 最细腻、最自然的表达 | 每个字符消耗 2 积分;需付费套餐 |
💡 小技巧: 如果某一句听起来很平,先别急着改稿。先用更高的档位生成同一句。如果这时听起来对了,问题在声音;如果还是不对,问题在稿子。
方法 2:让声音匹配内容
在广告里很出彩的声音,拿来念睡前故事可能会很怪。按音频的用途选声音,而不是看哪个试听最好听。
| 内容 | 适合 | 避免 |
|---|---|---|
| 有声书、纪录片 | 温暖、沉稳的旁白 | 亢奋的"播音腔" |
| 讲解视频、网课 | 清晰、友好、语速适中 | 气声太重或太戏剧化的声音 |
| 广告和推广 | 有活力、明亮 | 缓慢、轻柔的声音 |
| YouTube 和社交媒体 | 口语化、自然 | 过于正式的声音 |
| 冥想、助眠 | 平静、低沉、缓慢 | 任何欢快的声音 |
去声音库按风格筛选。如果是 YouTube 稿子,YouTube 配音生成器里列出了适合做旁白的声音。
方法 3:为耳朵写稿,而不是为眼睛
书面语和口语是两回事。看的时候,长句可以回头再读一遍;听的时候不行。
- 句子要短。 一句尽量不超过 20 个词(中文大约 30 个字),更长的就拆开。
- 用口语化的说法。 "我们会给你发邮件"听起来像人在说话,"系统将向用户发送邮件"就显得生硬。
- 一句话只讲一件事。 用"并且""其中"把两件事连在一起的地方,节奏最容易断。
- 用主动句。 "我们测试了十款工具"好过"十款工具被我们的团队进行了测试"。
- 自己先念一遍。 你念得喘不过气,声音也一样。
| 为眼睛写的 | 为耳朵写的 |
|---|---|
| 在完成注册流程后,用户将会收到一封确认邮件。 | 注册好之后,我们会给你发一封确认邮件。 |
| 该产品于 2024 年推出,目前已被超过 10,000 个团队采用。 | 我们 2024 年上线。到现在,已经有一万多个团队在用。 |
方法 4:用标点制造停顿
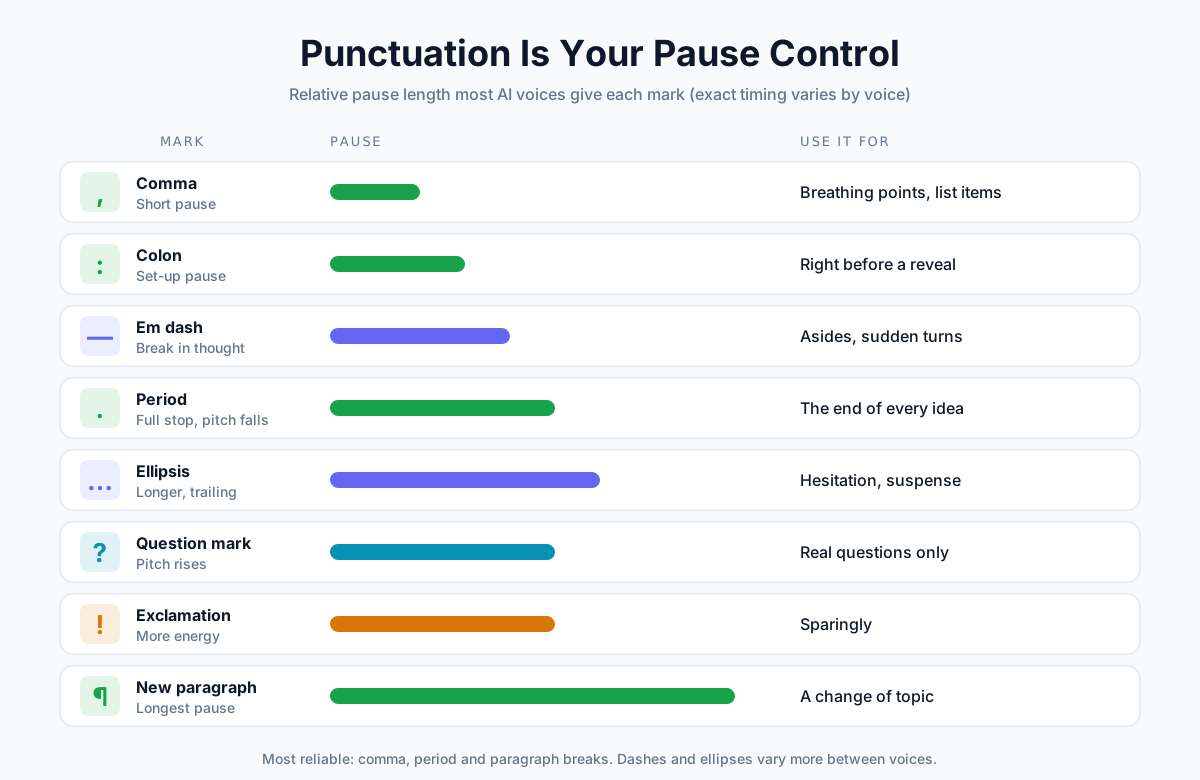
现代 AI 声音会把标点当作舞台提示。逗号是一次短暂的换气,句号让语调落下来,而新起一段是最长的停顿。
| 标点 | 通常的效果 | 用在哪里 |
|---|---|---|
| 逗号 , | 短停顿 | 换气处、列举项之间 |
| 句号 。 | 完整停顿,语调下降 | 每个意思的结尾 |
| 冒号 : | 短暂的铺垫停顿 | 揭晓答案或列举之前 |
| 破折号 —— | 思路的一次转折 | 插入语、突然的转折 |
| 省略号 …… | 更长的拖尾停顿 | 犹豫、制造悬念 |
| 问号 ? | 语调上扬 | 只用在真正的问题上 |
| 感叹号 ! | 更有能量 | 少用,否则像在喊 |
| 新起一段 | 最长的停顿 | 换话题的时候 |
📝 注意: 具体停顿多长,因声音和引擎而异。ElevenLabs 的官方文档指出,破折号和省略号制造的停顿不如其他方法稳定。逗号、句号和分段是最可靠的。
方法 5:把数字、日期和符号写成文字
数字和符号是 AI 声音最容易出错的地方,因为同样的字符可以有好几种读法。
ElevenLabs 的文档里有个很直观的例子:它的一个快速模型可能会把 "$1,000,000" 读成 "one thousand thousand dollars"("一千千美元")。把数字写成文字,在任何声音上都不用再猜。
| 原来写的 | 改写成 | 为什么 |
|---|---|---|
| $1,000,000 | 一百万美元 | 避免奇怪的数字分组 |
| $42.50 | 四十二美元五十美分 | 小数部分读得对 |
| 3:30 pm | 下午三点半 | 是时间,不是比例 |
| 2026-01-15 | 二〇二六年一月十五日 | 各国日期格式不同 |
| 25% | 百分之二十五 | 有些声音会漏读符号 |
| Dr. Smith | 史密斯医生 | 英文里 "Dr." 也可能是 "Drive"(街道) |
| Q3 | 第三季度 | 缩写容易被逐个字母念出来 |
| anyspeech.io/pricing | anyspeech 点 io 斜杠 pricing | 网址的读法没法预测 |
| 1/2 | 二分之一 | 可能被当成日期 |
不用每个数字都这样改。"3""10"这种简单的小数字通常没问题。重点改金额、日期、时间、百分比,以及任何带符号的内容。
方法 6:按读音重写,纠正发音
如果声音把某个人名或品牌名读错了,就按它的读音来拼写。听起来像是投机取巧,但这是唯一在所有引擎上都有效的办法。
| 单词 | 重写成 | 解决的问题 |
|---|---|---|
| Nguyen | Win | 常见姓氏,英文声音经常读错 |
| Worcestershire | Wuss-ter-sher | 不发音的字母 |
| AnySpeech | Any Speech | 由几个词拼成的品牌名 |
| SQL | sequel(或 S Q L) | 缩写还是单词 |
| read(过去式) | red | 拼写相同,读音不同 |
| live(形容词) | lyve | "a lyve show" 和 "I live here" |
| GIF | jif(或 gif) | 选一种读法,并保持一致 |
中文里最常见的是多音字,比如"重新"和"重要"、"银行"和"行走"。办法一样:把容易读错的字换成同音、不会读错的写法。
在 AnySpeech 上,你不用每份稿子都手动改。在文字转语音页面打开发音词典,填好书面文本和实际读法,这条规则就会自动应用到所有声音上。登录后最多可以保存 50 条规则。
💡 小技巧: 想让缩写逐个字母念出来,就加上空格或点:"F B I" 或 "F.B.I."。像 "NASA" 这种当作单词读的缩写,保持原样即可。
方法 7:用语序制造强调
在纯文本工具里,你没法标记"这个词要重读"。但你可以通过句子的组织方式来控制强调。
- 把关键词放在句尾。 英语天然会重读句子结尾,中文也常把新信息放在句末。"结果让所有人都很意外"不如"让所有人意外的,是结果"。
- 让它单独成句。 "免费。完全免费。"短句最有力量。
- 用冒号或破折号来揭晓。 "这里真正重要的只有一件事:时机。"
- 英文单词别全大写。 很多声音会把全大写当成缩写,逐个字母念出来。
方法 8:设置合适的语速
语速稍微快了一点,是旁白听起来像机器最常见的原因。看看真人旁白是怎么做的:
| 内容 | 典型语速(英语) | 建议的起始语速 |
|---|---|---|
| 有声书旁白 | 每分钟约 155 个词(ACX) | 0.9×–1.0× |
| 日常对话 | 每分钟约 150 个词 | 1.0× |
| 教程、技术内容 | 比对话稍慢 | 0.9× |
| 广告和推广 | 更快、更有活力 | 1.05×–1.1× |
| 冥想、助眠 | 缓慢、舒展 | 0.8× |
155 这个数字来自 Audible 旗下的有声书平台 ACX,它表示大多数旁白每小时大约念 9,300 个词。
在 AnySpeech 上,标准、高级和专业档位的语速滑块范围是 0.7× 到 1.2×。每次只调 0.1×。一下子调太多,声音会听起来被拉长或被挤压。
方法 9:调整稳定性和相似度
在高级和专业档位上,有两个滑块会改变声音的表现力。
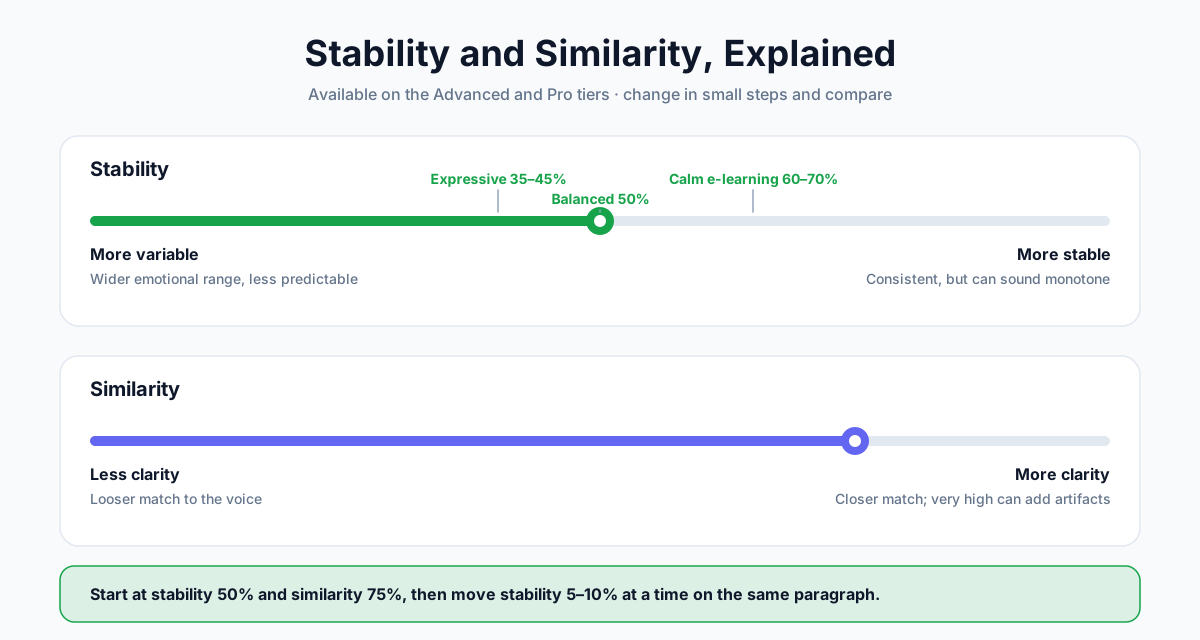
| 滑块 | 调低 | 调高 |
|---|---|---|
| 稳定性 | 更多变化:情绪起伏更大,但更难预测 | 更稳定:前后一致,但可能单调 |
| 相似度 | 清晰度低,与原声的贴合度更松 | 清晰度高,更贴近原声;调得太高可能出现杂音 |
一个实用的起点:
| 目标 | 稳定性 | 相似度 |
|---|---|---|
| 富有表现力的讲故事 | 35–45% | 75% |
| 平衡的旁白(默认) | 50% | 75% |
| 平稳、冷静的网课 | 60–70% | 75–80% |
稳定性每次调 5–10% 左右,每次都重新生成同一段,方便对比。
方法 10:长稿分段生成
长稿会带来两个问题。一句出错,就得全部重新生成;随意切分,每段听起来又可能略有不同。
- 在自然的断点切分:章节、场景或换话题的地方,不要在一段中间切。
- 每一段的设置保持完全一致:同样的声音、档位、语速和稳定性。
- 按顺序给文件命名(01-开场、02-准备……),拼接时一目了然。
在 AnySpeech 上,付费套餐一次最多可以生成 50,000 个字符(免费套餐和 Flash 档位为 5,000)。即便如此,按章节生成也会让修改某一句容易得多。
方法 11:用真人克隆的声音
还记得那项 PLOS One 研究吗?真人声音的克隆被判断为真人的比例,远高于通用 AI 声音:大约 58–70%,对比约 40%。
克隆会带上一个真人的节奏、习惯和换气方式。如果你经常需要旁白,可以用一段短录音克隆你自己的声音,之后每份稿子都用它。
- 在安静的房间录音,不要有音乐和回声。
- 用你希望克隆出来的方式说话:放松、自然,不要切换成"播音模式"。
- 只克隆你自己的声音,或者你明确获得授权的声音。
我们的声音克隆指南一步步讲了录音流程。
方法 12:在后期处理里收尾
未经处理的 AI 音频可能"干净"得不自然,像一个悬在真空里的声音。几处轻微的处理,就能让它落回真实环境里。
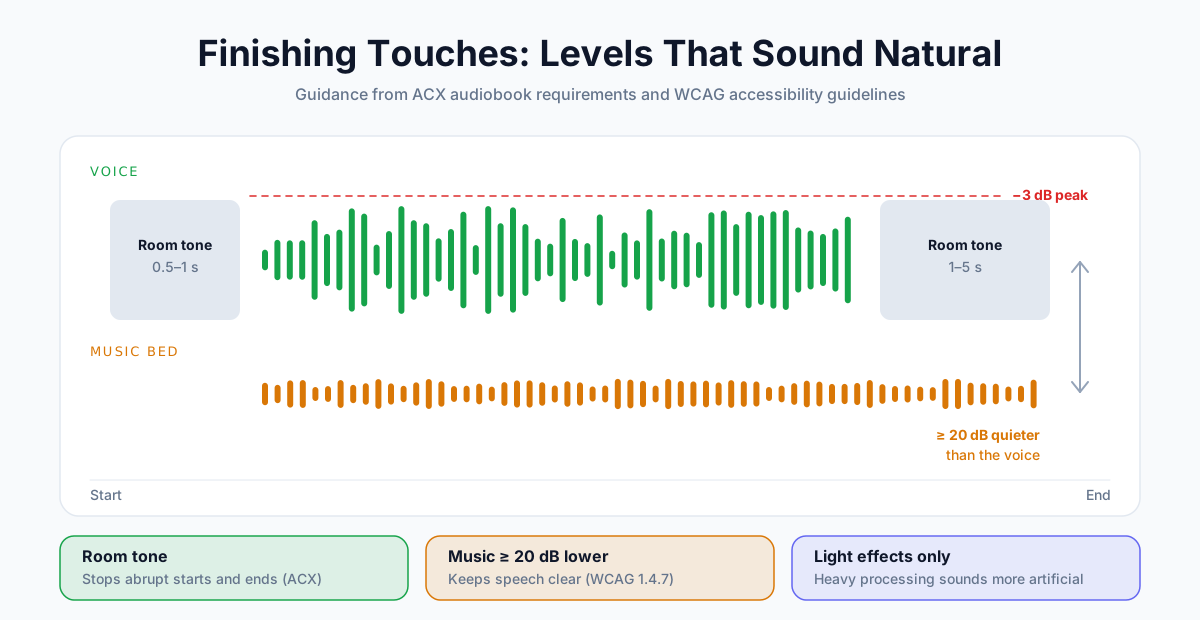
- 加底噪(room tone)。 ACX 要求每个文件开头有 0.5–1 秒的底噪,结尾有 1–5 秒。这样音频不会突然开始或戛然而止。
- 音乐要远低于人声。 无障碍指南(WCAG)建议背景音比语音至少低 20 分贝。
- 效果器少用。 过重的压缩、混响或均衡,只会让合成声音更假,而不是更真。
- 峰值保持在 −3 dB 以下,大音量播放时不会爆音(这也是 ACX 的要求)。
改写前后:一个完整示例
下面是一段按商业报告常见写法写成的文字,以及为声音改写后的版本(示例为英文)。
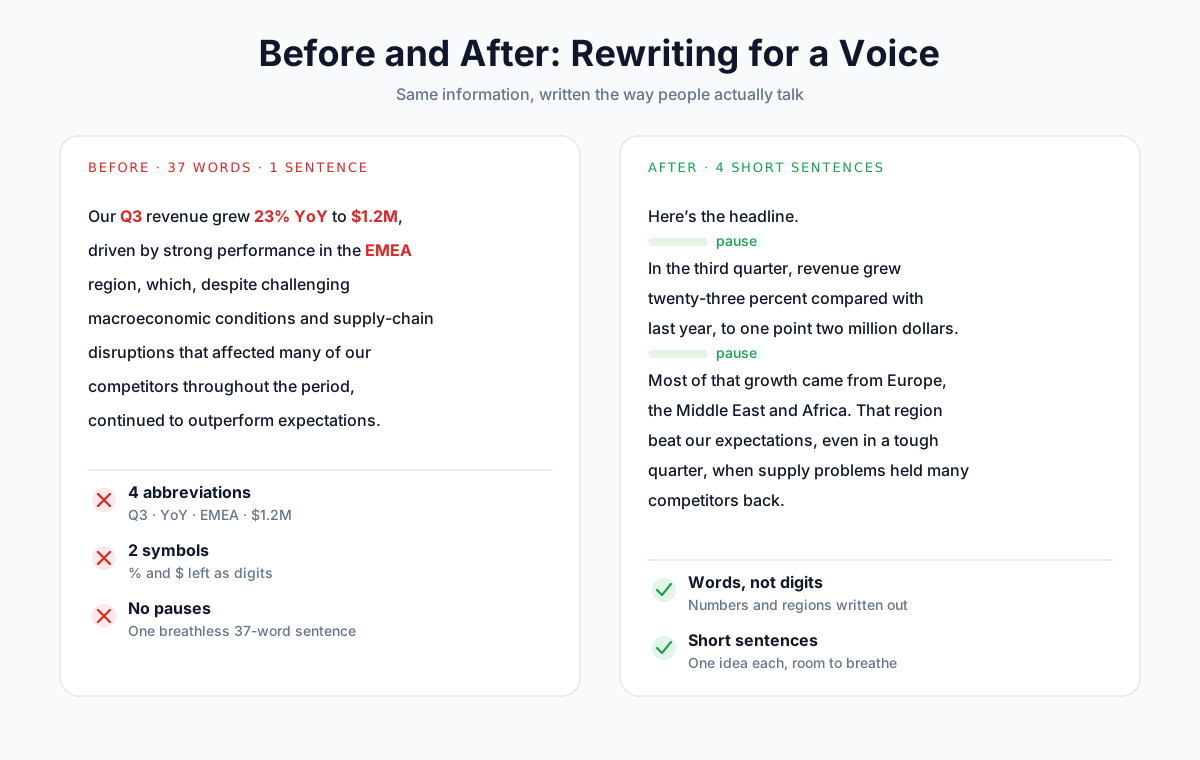
改写前(37 个词,一句话):
Our Q3 revenue grew 23% YoY to $1.2M, driven by strong performance in the EMEA region, which, despite challenging macroeconomic conditions and supply-chain disruptions that affected many of our competitors throughout the period, continued to outperform expectations.
改写后(四个短句):
Here's the headline. In the third quarter, revenue grew twenty-three percent compared with last year, to one point two million dollars.
Most of that growth came from Europe, the Middle East and Africa. That region beat our expectations, even in a tough quarter, when supply problems held many competitors back.
改了什么:
| 改动 | 用到的方法 |
|---|---|
| "Q3""YoY""EMEA" 展开成完整的词 | 5 |
| "23%" 和 "$1.2M" 写成文字 | 5 |
| 一个 37 个词的长句拆成四句 | 3 |
| 用一句简短的开场("Here's the headline.")先铺垫 | 7 |
| 在结果和背景之间分段 | 4 |
信息完全一样,也没用什么技巧。但几乎用任何声音念,第二版都像是一个人在说话。
那 SSML 呢?
SSML(语音合成标记语言)是一些文字转语音引擎支持的一套标签,比如插入一段精确时长的停顿,或者指定某个词的读音。
<speak>
  Welcome back. <break time="700ms"/> Let's get started.
</speak>
SSML 在很多传统云端语音上依然有效。但更新、更有表现力的模型越来越多地忽略它,或者只支持一部分。比如 ElevenLabs 表示,它最新的 v3 和 v4 模型不支持 SSML 的停顿标签;Google 的 Chirp 3 HD 声音也只支持其中一部分。
AnySpeech 处理的是纯文本,所以这篇指南里的每个方法用的都是写法、标点和设置,而不是标签。这些方法在每个声音、每个档位上都有效。
不同语言的注意事项
上面的方法大多适用于任何语言。处理非英语文本时,还有几个常见问题:
- 用母语声音。 中文稿子用专为中文打造的声音,会自然得多。在文字转语音语言页面按语言浏览,或者选一个口音,比如英式英语。
- 用目标语言把数字写出来。 在混合了多种语言的文本里,声音可能会用错误的语言读数字。
- 使用该语言自己的标点。 中文和日文用全角标点(。,?),声音会把它们当作停顿。
- 混合语言的文本先试听再定稿。 夹在其他语言里的品牌名和英文术语,是很常见的出错点。需要的话按读音重写(方法 6)。
自然 AI 语音检查清单
发布前把这份清单过一遍。哪一项没通过,就回到快速诊断表格找对应的方法。
- 声音适合内容(旁白型、对话型还是活力型)
- 句子短,一句只讲一件事
- 在人会用口语的地方用了口语
- 每次换话题都分了段
- 金额、日期、时间和百分比都写成了文字
- 容易读错的人名和品牌名已经重写,或加进了发音词典
- 重要句子里的关键词放在了句尾附近
- 语速和内容匹配(旁白从 0.9×–1.0× 开始)
- 稳定性按你想要的语气调好了
- 长稿在自然断点处分段,设置完全一致
- 音乐比人声低至少 20 分贝
- 你已经从头到尾完整听过一遍
常见问题
为什么我的 AI 配音听起来像机器人?
通常是文字的问题,而不是声音。长句、缺少标点、缩写和数字,都会让 AI 声音念得又平又赶。声音不适合内容、语速太快,或者稳定性调得太高,也会让它显得单调。
最自然的 AI 声音是哪个?
这取决于内容和语言,所以最好用同一份稿子试几个声音。在我们的产品里,高级和专业档位的表达最自然。真人声音的克隆往往更自然:在 2025 年的一项 PLOS One 研究里,克隆声音有 58–70% 的时候被判断为真人。
文字转语音怎么加停顿?
用标点。逗号是短停顿,句号是完整停顿,新起一段是最长的停顿。冒号和破折号会在揭晓前制造一次停顿。有些引擎也支持 SSML 停顿标签,但很多新模型会忽略它们。
怎么让文字转语音把一个词读对?
按读音重写这个词,比如把 "Nguyen" 写成 "Win",或者把过去式的 "read" 写成 "red"。在 AnySpeech 上,把这个写法存进发音词典,它就会自动应用到所有声音上。
AI 旁白的语速应该是多少?
英语旁白大多适合每分钟 150–155 个词。ACX 表示有声书旁白平均每小时约 9,300 个词,大约相当于每分钟 155 个词。从 0.9× 到 1.0× 的语速开始,技术性内容再稍微放慢一点。
AI 声音能表达情绪吗?
能。高端声音会从文字本身读出情绪,所以把感受写进稿子里("我简直不敢相信。")。调低稳定性能让情绪起伏更大。专业版克隆声音还自带情绪控制。
我还需要 SSML 吗?
大多数项目都不需要。SSML 适合在传统云端语音上精确控制停顿和读音,但新的高表现力模型经常会忽略部分标签。纯文本方法(标点、按读音重写、把数字写成文字)在所有引擎上都有效。
人们能分辨 AI 声音和真人声音吗?
很多时候分辨不出来。在 2025 年的一项 PLOS One 研究里,听众有 58–70% 的时候把克隆声音判断为真人,而真人录音是 62–81%。通用 AI 声音的得分更低,约为 40%。
让你的下一段配音听起来像真人
修好一段机械的配音,不需要换工具,也不需要音频工程师。先从稿子入手:句子更短、标点到位、数字写成文字。然后再微调声音、语速和稳定性。
现在就试试:把一段文字贴进 AnySpeech 文字转语音,先原样生成一次,再用方法 3 到方法 5 改完后生成一次。差别一听就能听出来。
作者

分类
更多文章
如何获取 YouTube 视频的字幕文稿:6 种方法(2026)
获取任意 YouTube 视频的转写稿:自带「显示转写稿」、手机端、可导出 TXT/SRT 的免费工具、YouTube Studio、无字幕视频,以及代码方法。

2026 年最佳音频分离工具(实测 10 款)
我们用同一批语音和音乐素材实测了 10 款音频分离工具,对比分离质量、伪影、价格与免费额度——并帮你判断,你要的到底是哪一类工具。

将文字转换为音频:文本转音频完整指南(2026)
几分钟内用 AI 语音将文字转换为音频。免费工具推荐、分步操作指南、语音质量对比,以及适合内容创作者、教育工作者和营销人的实用技巧。