Yapay Zeka Sesi Nasıl Daha Az Robotik Hale Getirilir: 12 Çözüm (2026)
Yapay zeka sesi neden robotik duyulur? Kulak için yazmak, noktalamayla duraklamak, sayıları yazıyla yazmak, telaffuz ve hız ayarı dahil işe yarayan 12 çözüm.
Metninizi yapıştırıyor, oluştur düğmesine basıyorsunuz ve ses… fena değil. Net ama düz. Listeleri aceleyle geçiyor, yanlış kelimeleri vurguluyor ve "$1.2M" ifadesini sanki bir hesap tablosundan okuyormuş gibi seslendiriyor.
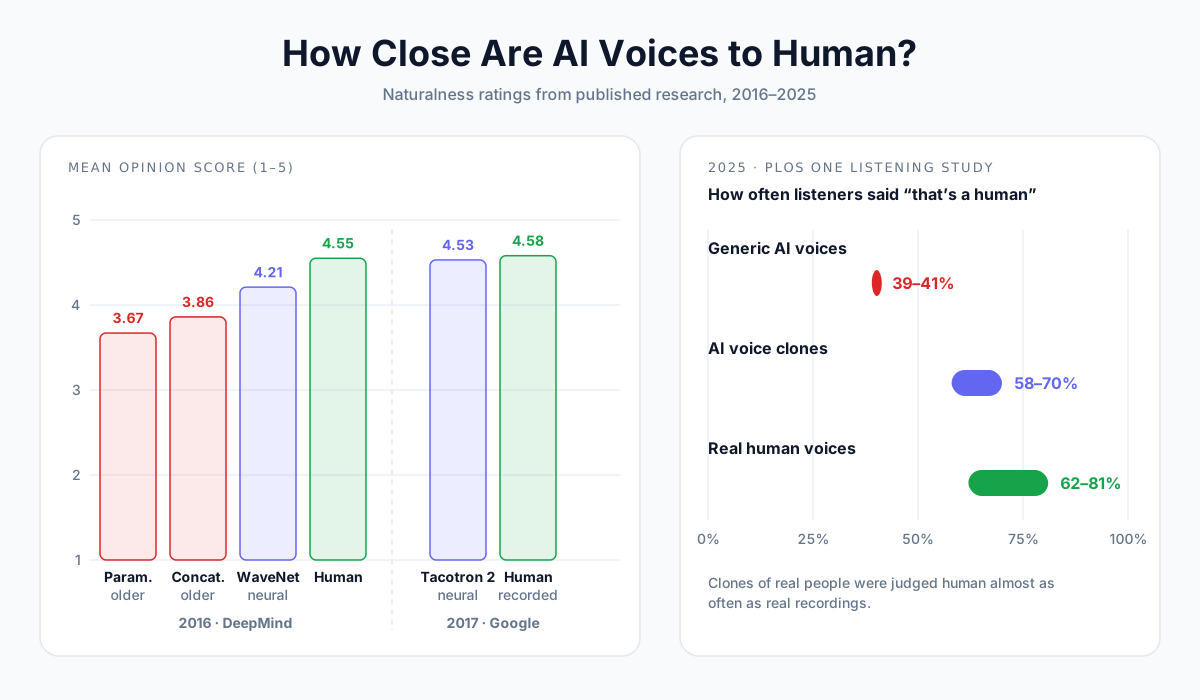
İşin şaşırtıcı yanı şu: Artık sorun nadiren teknolojide. PLOS One dergisinde 2025'te yayımlanan bir çalışmada dinleyiciler, yapay zeka ses klonlarını vakaların %58–70'inde insan sesi sandı. Bu oran, gerçek insan kayıtlarının aldığı %62–81'e oldukça yakın.
Yani bugün bir yapay zeka sesi robotik duyuluyorsa, sebep genellikle motorda değil, metinde ve ayarlarda. İkisini de dakikalar içinde düzeltebilirsiniz.
Bu rehber size bunu tam olarak nasıl yapacağınızı gösteriyor.
Bu yazıda öğrenecekleriniz:
- Yapay zeka konuşmasını robotik yapan beş etken
- Ses kaydınızdaki sorunu hızla teşhis etmenin bir yolu
- Metninizi yeniden yazmaktan ses ayarlarına ince ayar yapmaya kadar 12 çözüm
- Duraklamaları, sayıları ve telaffuzu hiç kod yazmadan nasıl kontrol edeceğiniz
- Yapay zeka anlatımının hangi hızda olması gerektiği, gerçek rakamlarla
- Olduğu gibi kopyalayabileceğiniz eksiksiz bir önce-sonra örneği
Kısa cevap: Yapay zeka sesini daha az robotik hale getirmek için insanların konuştuğu gibi kısa cümleler yazın; duraklama yaratmak için virgül, nokta ve paragraf aralarını kullanın; sayıları ve kısaltmaları yazıyla yazın; sesin yanlış telaffuz ettiği kelimeleri okunduğu gibi yazın ve içeriğe uyan bir ses seçin. Ardından hızı biraz yavaşlatın, daha fazla ifade için de stabiliteyi biraz düşürün. Bir yapay zeka metin okuma aracında bunların çoğu saniyeler sürer.
Yapay Zeka Sesi Neden Robotik Duyulur?
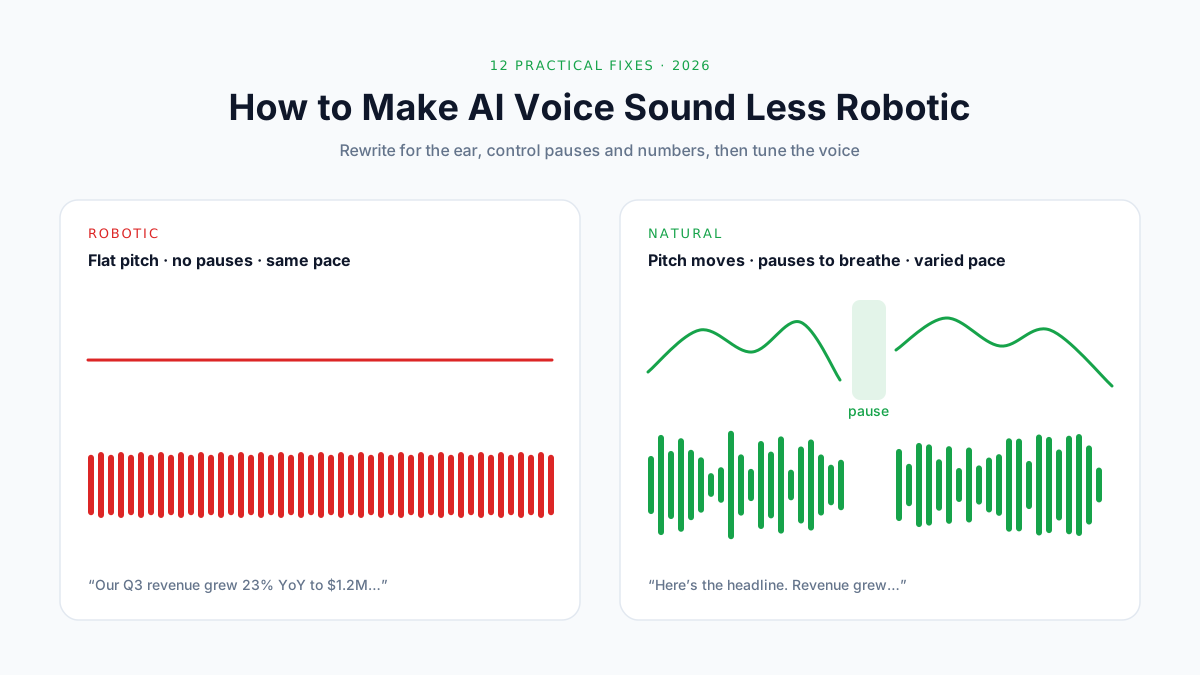
Ritmi, tonlaması ve duraklamaları insanların gerçekte konuşma biçimine uymadığında yapay zeka sesi robotik duyulur. İnsanlar konuşurken hızlarını değiştirir, ses perdelerini yükseltip alçaltır, nefes almak için durur ve önemli kelimeleri vurgular. Sentetik konuşma bunları yapmadığında kulağa robot gibi gelir.
5 Neden
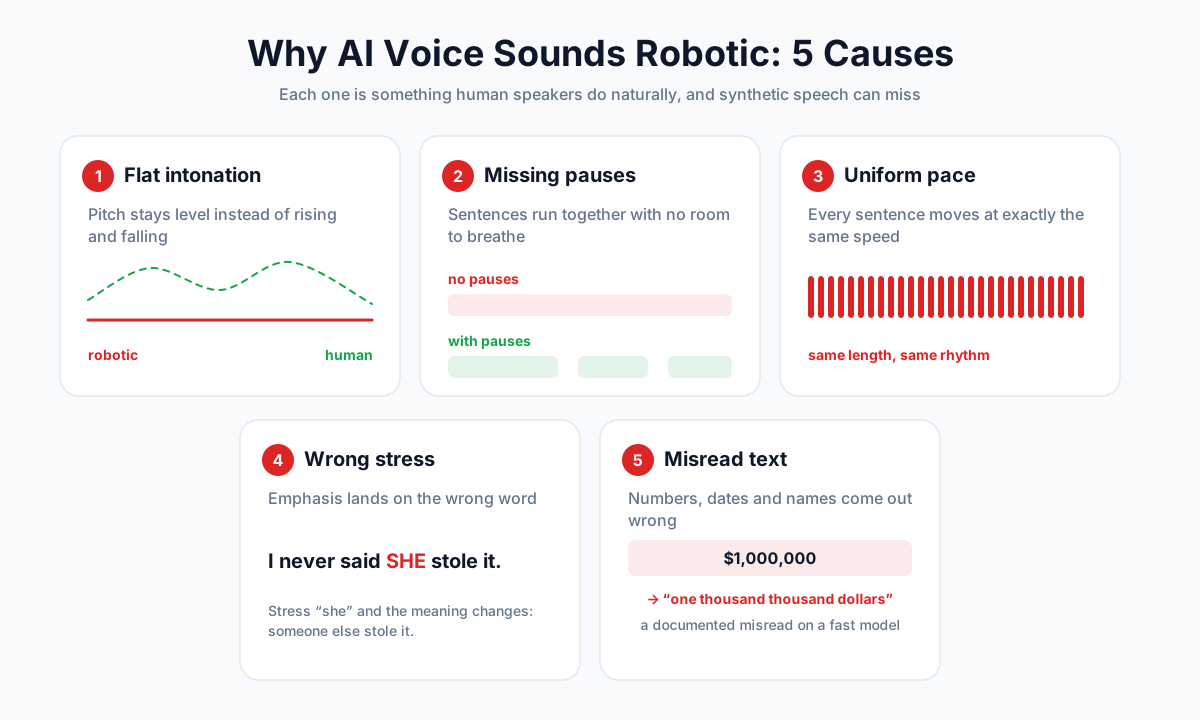
- Düz tonlama. Ses perdesi anlama göre yükselip alçalmak yerine hep aynı seviyede kalır.
- Eksik duraklamalar. Cümleler nefes alacak yer bırakmadan birbirine karışır.
- Tekdüze tempo. Her cümle tam olarak aynı hızda ilerler.
- Yanlış vurgu. Vurgu yanlış kelimeye düşer ve anlam kayar.
- Yanlış okunan metin. Sayılar, tarihler, kısaltmalar ve isimler yanlış çıkar.
Araştırmacılar sonuncusuna bir ad veriyor: metin normalizasyonu, yani yazılı metni bir sesin söyleyebileceği kelimelere dönüştürmek. Bu, modern sistemler için bile zordur; çünkü "1/2" bağlama göre "yarım", "2 Ocak" ya da "1 Şubat" anlamına gelebilir.
Yapay Zeka Seslerinin Kat Ettiği Yol
Konuşma bilimciler doğallığı Ortalama Görüş Puanı (Mean Opinion Score, MOS) ile ölçer: Dinleyiciler klipleri 1 (kötü) ile 5 (mükemmel) arasında puanlar.
| Yıl | Dönüm noktası | Puan |
|---|---|---|
| 2016 | Eski "parametrik" ve "birleştirmeli" sesler (robotik GPS dönemi) | 3,67 ve 3,86 MOS; insanlar 4,55 aldı |
| 2016 | DeepMind'ın WaveNet'i, ilk büyük sinirsel ses | 4,21 MOS |
| 2017 | Google'ın Tacotron 2'si | 4,53 MOS; kayıtlı konuşma 4,58 |
| 2022 | Microsoft'un NaturalSpeech'i | Kayıtlardan istatistiksel olarak anlamlı bir farkı yok |
| 2025 | PLOS One dinleme çalışması | Ses klonları vakaların %58–70'inde insan sanıldı; gerçek insanlar %62–81 |
Aynı çalışma, hazır yapay zeka seslerinin (gerçek bir kişiden klonlanmamış olanların) yalnızca yaklaşık %40 oranında insan sanıldığını ortaya koydu. Bu fark önemli; Çözüm 11'de ona geri döneceğiz.
Bugün "Robotik" Seslerin Çoğu Aslında Bir Metin Sorunu
Modern sesler insan gibi duyulabilir. Ama onlara ne verirseniz tam olarak onu okurlar.
Üç kısaltma ve bir dolar tutarı içeren 45 kelimelik bir cümle, neredeyse her seste robotik duyulur. Aynı fikir kulak için yeniden yazıldığında ise seslerin çoğunda doğal duyulur. Aşağıdaki çözümlerin çoğunun metinle ilgili olmasının nedeni bu.
Hızlı Teşhis
Herhangi bir şeyi değiştirmeden önce kaydı bir kez dinleyin ve sorunun adını koyun. Sonra doğrudan ilgili çözüme geçin.
| Duyduğunuz şey | Olası neden | Çözüm |
|---|---|---|
| Düz, monoton okuma | Ses içeriğe uymuyor ya da stabilite çok yüksek | 1, 2, 9 |
| Fikirler arasında nefes payı yok | Uzun cümleler, az virgül ya da paragraf arası | 3, 4 |
| Aceleci, nefes nefese okuma | Hız çok yüksek, listeler tek bir cümleye sıkıştırılmış | 3, 8 |
| Vurgu yanlış kelimede | Anahtar kelime cümlenin ortasında kaybolmuş | 7 |
| "$1,000,000" tuhaf okunuyor | Sayılar ve simgeler rakam olarak bırakılmış | 5 |
| İsimler ya da markalar yanlış telaffuz ediliyor | Yazılışından okunuşu kestirilemeyen alışılmadık kelimeler | 6 |
| Ses paragraftan paragrafa farklı duyuluyor | Uzun metin farklı ayarlarla bölünmüş | 10 |
| "Fazla temiz", laboratuvar kaydı gibi duyuluyor | Kuru ses; ortam sesi (room tone) ya da fon müziği yok | 12 |
12 Çözüm
Çözüm 1: Doğru Ses Katmanıyla Başlayın
Her yapay zeka sesi aynı değildir. Daha hızlı ve daha ucuz modeller taslaklar için harikadır. Premium modeller ise ritmi ve duyguyu daha iyi yakalar.
AnySpeech'te aynı metni beş farklı katmanda oluşturabilirsiniz:
| Katman | En uygun olduğu alan | Bilmeniz gerekenler |
|---|---|---|
| Temel | Taslaklar, uzun okumalar, erişilebilirlik | Ücretsiz; ücretsiz metin okuma sayfasında da kullanılabilir |
| Standart | Geniş dil ve aksan kapsamı | 300+ ses, 40+ dil |
| Flash | Kısa, canlı, sohbet havasında içerikler | Hızlı ve ifadeli; oluşturma başına en fazla 5.000 karakter |
| Gelişmiş | 70+ dilde doğal anlatım | Çoğu seslendirmede varsayılan tercihimiz |
| Pro | En incelikli, en doğal okuma | Karakter başına 2 kredi harcar; ücretli planlarda |
💡 İpucu: Bir satır düz duyuluyorsa hemen yeniden yazmaya girişmeyin. Önce aynı satırı daha üst bir katmanda oluşturun. Şimdi doğru duyuluyorsa sorun sesteymiş. Hâlâ kulağa tuhaf geliyorsa sorun metinde.
Çözüm 2: Sesi İçeriğe Göre Seçin
Bir reklamda harika duyulan bir ses, uyku öncesi masalı okurken tuhaf kaçabilir. Seçiminizi en hoş duyulan örneğe göre değil, kaydın ne için kullanılacağına göre yapın.
| İçerik | Aranacak özellik | Kaçınılacaklar |
|---|---|---|
| Sesli kitaplar, belgeseller | Sıcak, dengeli bir anlatıcı | Coşkulu, "spiker" tarzı sesler |
| Açıklayıcı videolar, e-öğrenme | Net, samimi, orta tempolu | Fazla nefesli ya da dramatik sesler |
| Reklamlar ve tanıtımlar | Enerjik, parlak | Yavaş, yumuşak sesler |
| YouTube ve sosyal medya | Sohbet havasında, doğal | Aşırı resmî sesler |
| Meditasyon, uyku | Sakin, kalın, yavaş | Hareketli her şey |
Ses kütüphanesine göz atın ve stile göre filtreleyin. YouTube senaryoları için YouTube seslendirme oluşturucu, anlatıma uygun sesleri listeliyor.
Çözüm 3: Göz İçin Değil, Kulak İçin Yazın
Yazı dili ile konuşma dili birbirinden farklıdır. Okurken uzun bir cümleye dönüp yeniden okuyabiliriz. Dinlerken bunu yapamayız.
- Cümleleri kısa tutun. 20 kelimenin altında kalmaya çalışın. Daha uzun olan her cümleyi bölün.
- Günlük konuşma kalıplarını kullanın. "Yapıyoruz", "göndereceğiz" ve "var" insan gibi duyulur; "yapılmaktadır", "gönderilecektir" ve "mevcuttur" ise kaskatı duyulur.
- Her cümleye tek bir fikir koyun. İki fikri "ve" ile ya da "-an", "-dığı" gibi eklerle kurulan uzun yan cümlelerle birbirine bağladığınızda ritim bozulur.
- Etken fiiller kullanın. "On aracı test ettik", "Ekibimiz tarafından on araç test edilmiştir" cümlesinden daha iyidir.
- Metni kendiniz yüksek sesle okuyun. Sizin nefesiniz yetmiyorsa sesin de yetmez.
| Göz için yazılmış | Kulak için yazılmış |
|---|---|
| Kayıt işleminin tamamlanmasının ardından kullanıcılara bir onay e-postası iletilecektir. | Kaydolduğunuzda size bir onay e-postası göndereceğiz. |
| 2024 yılında piyasaya sürülen ürün, 10.000'i aşkın ekip tarafından benimsenmiştir. | 2024'te çıktık. O günden bu yana on binden fazla ekip kaydoldu. |
Çözüm 4: Duraklama Yaratmak İçin Noktalamayı Kullanın
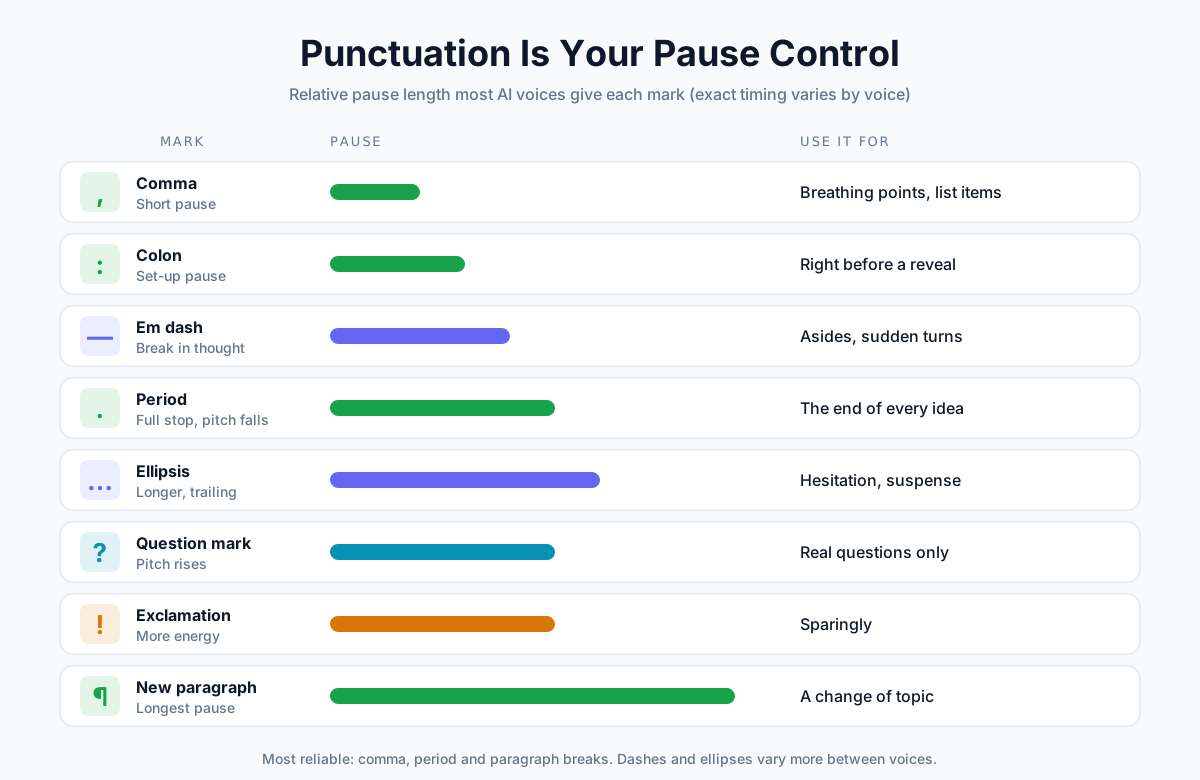
Modern yapay zeka sesleri noktalama işaretlerini birer sahne talimatı gibi algılar. Virgül kısa bir nefes aldırır. Nokta, ses perdesini alçaltır. Yeni bir paragraf ise en uzun duraklamayı sağlar.
| Noktalama işareti | Genellikle ne yapar? | Ne için kullanılır? |
|---|---|---|
| Virgül , | Kısa duraklama | Nefes alma noktaları, liste öğeleri |
| Nokta . | Tam duruş, ses perdesi alçalır | Her fikrin sonu |
| İki nokta : | Kısa bir hazırlık duraklaması | Önemli bir bilgiden ya da listeden hemen önce |
| Uzun tire — | Düşüncede bir kırılma | Ara sözler ve ani dönüşler |
| Üç nokta … | Daha uzun, uzayıp giden duraklama | Tereddüt, merak uyandırma |
| Soru işareti ? | Ses perdesi yükselir | Yalnızca gerçek sorular |
| Ünlem işareti ! | Daha fazla enerji | Ölçülü kullanın, yoksa bağırıyormuş gibi duyulur |
| Yeni paragraf | En uzun duraklama | Konu değişikliği |
📝 Not: Duraklamaların tam uzunluğu sese ve motora göre değişir. ElevenLabs kendi dokümantasyonunda, tirelerin ve üç noktaların diğer yöntemlere göre daha az tutarlı duraklamalar yarattığını belirtiyor. En güvenilir yöntemler virgüller, noktalar ve paragraf aralarıdır.
Çözüm 5: Sayıları, Tarihleri ve Simgeleri Yazıyla Yazın
Yapay zeka seslerinin en çok tökezlediği yer rakamlar ve simgelerdir; çünkü aynı karakterler birkaç farklı şekilde okunabilir.
ElevenLabs, dokümantasyonunda bunun açık bir örneğini veriyor: Hızlı modellerinden biri "$1,000,000" ifadesini "one thousand thousand dollars" ("bin bin dolar") diye okuyabiliyor. Sayıyı yazıyla yazmak, hangi ses olursa olsun tahmine yer bırakmaz.
| Bunun yerine | Şunu yazın | Neden? |
|---|---|---|
| $1,000,000 | bir milyon dolar | Tuhaf sayı gruplamalarını önler |
| $42.50 | kırk iki dolar elli sent | Sentler doğru okunur |
| 3:30 pm | öğleden sonra üç buçuk | Oran değil, saat olduğu anlaşılır |
| 2026-01-15 | on beş Ocak iki bin yirmi altı | Tarih biçimi ülkeden ülkeye değişir |
| 25% | yüzde yirmi beş | Bazı sesler simgeyi atlar |
| Dr. Smith | Doktor Smith | "Dr." İngilizcede "Drive" (cadde) diye de okunabilir |
| Q3 | üçüncü çeyrek | Kısaltmalar harf harf okunur |
| anyspeech.io/pricing | anyspeech nokta io eğik çizgi pricing | URL'lerin nasıl okunacağı kestirilemez |
| 1/2 | yarım | Tarih sanılabilir |
Bunu her sayı için yapmanız gerekmez. "3" ya da "10" gibi küçük ve basit sayılar genellikle sorun çıkarmaz. Para tutarlarına, tarihlere, saatlere, yüzdelere ve simge içeren her şeye odaklanın.
Çözüm 6: Telaffuzu Okunduğu Gibi Yazarak Düzeltin
Bir ses bir ismi ya da markayı yanlış telaffuz ediyorsa onu okunduğu gibi yazın. Derme çatma bir çözüm gibi görünebilir, ama her motorda işe yarayan tek yöntem bu.
| Kelime | Şöyle yazın | Çözdüğü sorun |
|---|---|---|
| Nguyen | Win | Yaygın bir soyadı, sık sık yanlış okunur |
| Worcestershire | Wuss-ter-sher | Okunmayan harfler |
| AnySpeech | Any Speech | Bitişik yazılmış kelimelerden oluşan marka adı |
| SQL | sequel (ya da S Q L) | Kısaltma mı, kelime mi? |
| read (geçmiş zaman) | red | Yazılışı aynı, okunuşu farklı |
| live (sıfat) | lyve | "a lyve show" ile "I live here" farkı |
| GIF | jif (ya da gif) | Birini seçin ve hep onu kullanın |
AnySpeech'te bunun için her metni tek tek düzenlemeniz gerekmez. Metin okuma sayfasında Pronunciation dictionary (Telaffuz sözlüğü) bölümünü açın, Written text (Yazılan metin) ve Say it like (Şöyle okunsun) alanlarını doldurun; kural her seste otomatik olarak uygulanır. Giriş yaptıktan sonra 50 kurala kadar kaydedebilirsiniz.
💡 İpucu: Harf harf okunmasını istediğiniz kısaltmalarda araya boşluk ya da nokta koyun: "F B I" veya "F.B.I." gibi. "NASA" gibi kelime olarak okunan kısaltmaları ise olduğu gibi bırakın.
Çözüm 7: Vurguyu Kelime Sırasıyla Yaratın
Düz metinle çalışan bir araçta bir kelimeyi "bunu vurgula" diye işaretleyemezsiniz. Ama vurguyu cümleyi nasıl kurduğunuzla kontrol edebilirsiniz.
- Anahtar kelimeyi yüklemin hemen önüne koyun. Türkçede vurgu doğal olarak yüklemden hemen önceki ögeye düşer. "Sonuçlar herkesi şaşırttı" cümlesinde vurgu "herkesi" kelimesinde, "Herkes sonuçlara şaşırdı" cümlesinde ise "sonuçlara" kelimesindedir.
- Anahtar kelimeye ayrı bir cümle ayırın. "Ücretsiz. Tamamen ücretsiz." Kısa cümleler güçlü bir etki bırakır.
- Önemli bilgiden önce iki nokta ya da tire kullanın. "Burada önemli olan tek bir şey var: zamanlama."
- Kelimeleri TAMAMEN BÜYÜK HARFLE yazmayın. Birçok ses büyük harfleri kısaltma sanar ve kelimeyi harf harf okur.
Çözüm 8: Doğru Hızı Ayarlayın
Anlatımın makine gibi duyulmasının en yaygın nedeni, sesin biraz fazla hızlı olmasıdır. Gerçek anlatıcıların temposu şöyle:
| İçerik | Tipik tempo | Başlangıç için hız ayarı |
|---|---|---|
| Sesli kitap anlatımı | Dakikada yaklaşık 155 kelime (ACX) | 0,9×–1,0× |
| Günlük konuşma | Dakikada yaklaşık 150 kelime | 1,0× |
| Eğitimler, teknik içerik | Konuşmadan biraz daha yavaş | 0,9× |
| Reklamlar ve tanıtımlar | Daha hızlı, enerjik | 1,05×–1,1× |
| Meditasyon, uyku | Yavaş ve ferah | 0,8× |
155 rakamı, Audible'ın sesli kitap platformu ACX'ten geliyor. ACX'e göre anlatıcıların çoğu saatte yaklaşık 9.300 kelime okuyor.
AnySpeech'te Standart, Gelişmiş ve Pro katmanlarındaki Hız kaydırıcısı 0,7× ile 1,2× arasında ayarlanabilir. Ayarı 0,1× gibi küçük adımlarla değiştirin. Daha büyük sıçramalar sesi gerilmiş ya da sıkıştırılmış gibi duyurabilir.
Çözüm 9: Stabilite ve Benzerliğe İnce Ayar Yapın
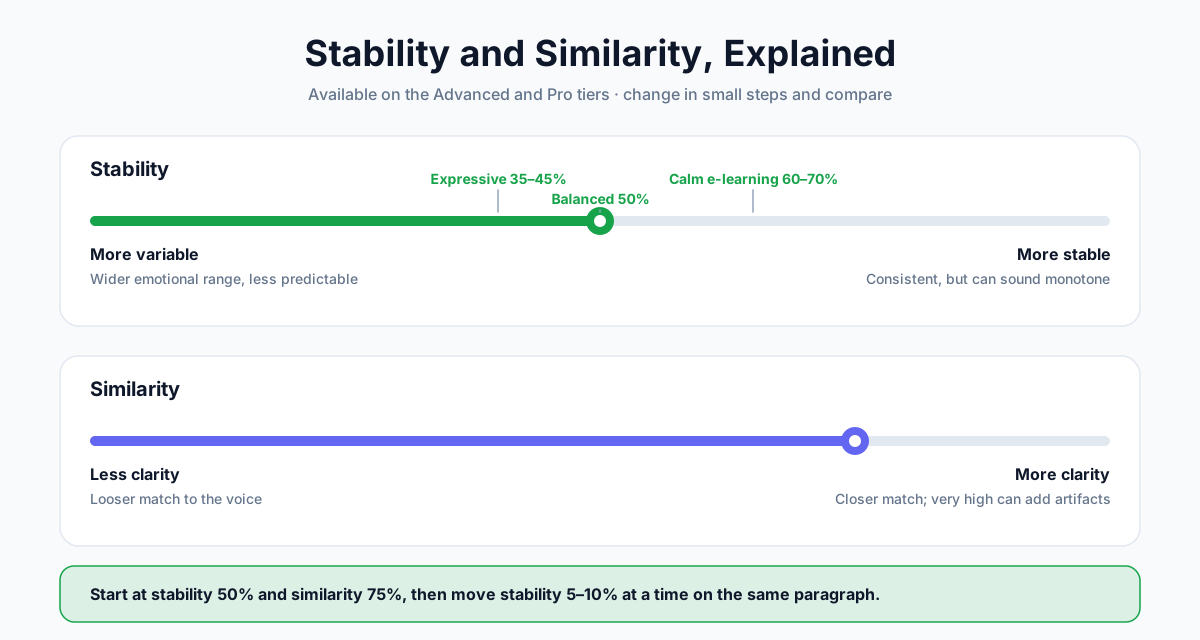
Gelişmiş ve Pro katmanlarında iki kaydırıcı, sesin ne kadar ifadeli olacağını belirler.
| Kaydırıcı | Düşük | Yüksek |
|---|---|---|
| Stabilite | Daha Değişken: daha geniş duygu yelpazesi, ama daha az öngörülebilir | Daha Stabil: tutarlı, ama monoton duyulabilir |
| Benzerlik | Daha Az Netlik: sesle daha gevşek bir eşleşme | Daha Fazla Netlik: sesle daha yakın bir eşleşme; çok yüksek değerler bozulmalara (artifact) yol açabilir |
Pratik bir başlangıç noktası:
| Hedef | Stabilite | Benzerlik |
|---|---|---|
| İfadeli hikâye anlatımı | %35–45 | %75 |
| Dengeli anlatım (varsayılan) | %50 | %75 |
| Tutarlı, sakin e-öğrenme | %60–70 | %75–80 |
Stabiliteyi yaklaşık %5–10'luk adımlarla değiştirin ve karşılaştırabilmek için her seferinde aynı paragrafı yeniden oluşturun.
Çözüm 10: Uzun Metinleri Bölüm Bölüm Oluşturun
Uzun metinler iki soruna yol açar. Tek bir cümle hatalı çıkarsa her şeyi yeniden oluşturmanız gerekir. Metni özensizce bölerseniz de her parça biraz farklı duyulabilir.
- Doğal kırılma noktalarından bölün: bölüm, sahne ya da konu değişikliklerinden; asla paragrafın ortasından değil.
- Ayarları her parça için aynı tutun: aynı ses, katman, hız ve stabilite.
- Dosyalarınızı sırayla adlandırın (01-giris, 02-kurulum…); böylece onları kolayca birleştirirsiniz.
AnySpeech'te ücretli planlarla tek seferde 50.000 karaktere kadar ses oluşturabilirsiniz (ücretsiz planda ve Flash katmanında bu sınır 5.000 karakter). Yine de bölüm bölüm oluşturmak, tek bir satırı düzeltmeyi çok daha kolaylaştırır.
Çözüm 11: Klonlanmış Bir İnsan Sesi Kullanın
PLOS One çalışmasını hatırlıyor musunuz? Gerçek insanların ses klonları, hazır yapay zeka seslerine göre çok daha sık insan sanıldı: Klonlarda bu oran kabaca %58–70, hazır seslerde ise yaklaşık %40'tı.
Bir klon, gerçek bir insanın ritmini, kendine has özelliklerini ve nefes alma alışkanlıklarını taşır. Düzenli olarak anlatım yapıyorsanız kısa bir kayıttan kendi sesinizi klonlayabilir ve bu sesi her metninizde kullanabilirsiniz.
- Sessiz bir odada kaydedin; müzik ya da yankı olmasın.
- Klonun nasıl duyulmasını istiyorsanız öyle konuşun: rahat ve doğal, "spiker" modunda değil.
- Yalnızca kendi sesinizi klonlayın ya da kullanmak için açıkça izin aldığınız bir sesi.
Ses klonlama rehberimiz, kayıt sürecini adım adım anlatıyor.
Çözüm 12: Son Dokunuşları Post Prodüksiyonda Yapın
Ham yapay zeka sesi, doğal olmayacak kadar "temiz" duyulabilir; sanki boşlukta süzülen bir ses gibi. Birkaç hafif dokunuş onu gerçek bir ortama yerleştirir.
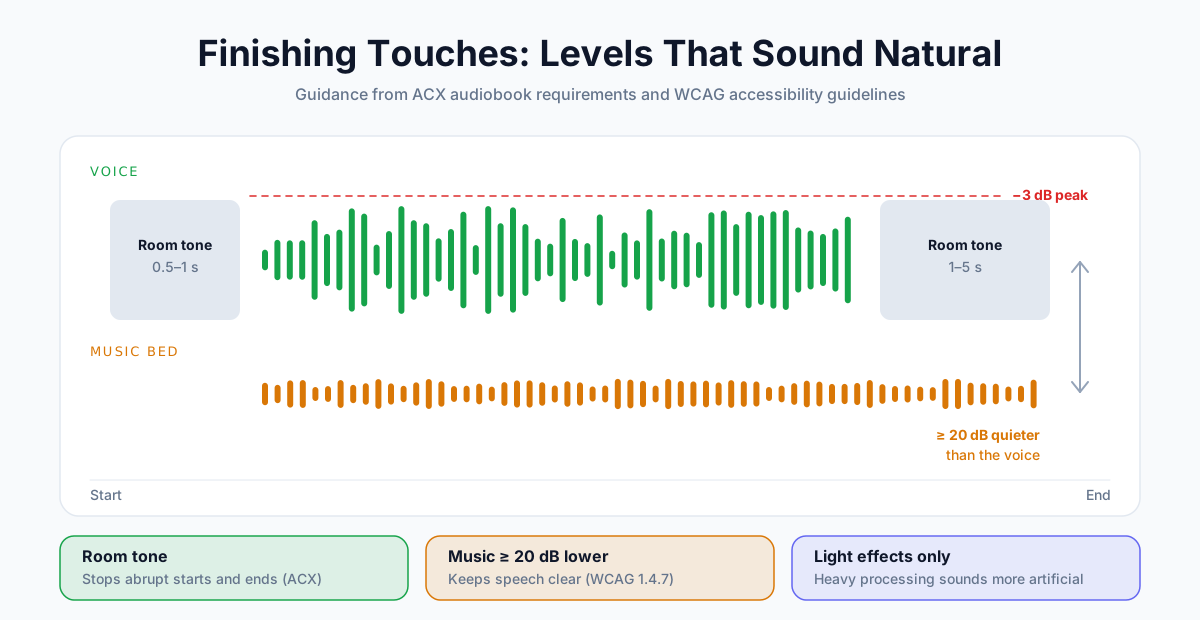
- Ortam sesi ekleyin. ACX, her dosyanın başında 0,5–1 saniye, sonunda ise 1–5 saniye ortam sesi istiyor. Bu, kaydın aniden başlamasını ya da bitmesini önler.
- Müziği sesin epey altında tutun. Erişilebilirlik yönergeleri (WCAG), arka plandaki sesin konuşmadan en az 20 desibel daha kısık olmasını öneriyor.
- Efektlerde ölçüyü kaçırmayın. Ağır sıkıştırma (compression), yankı (reverb) ya da EQ, sentetik bir sesin yapaylığını azaltmak yerine artırabilir.
- Tepe seviyelerini −3 dB'nin altında tutun; böylece ses yüksek seviyede çalındığında bozulmaz (clipping). Bu da bir ACX şartıdır.
Önce ve Sonra: Bir Paragrafı Baştan Yazmak
Aşağıda, iş raporlarında sık görülen üslupla yazılmış bir paragraf ve aynı paragrafın ses için yeniden yazılmış hâli var.
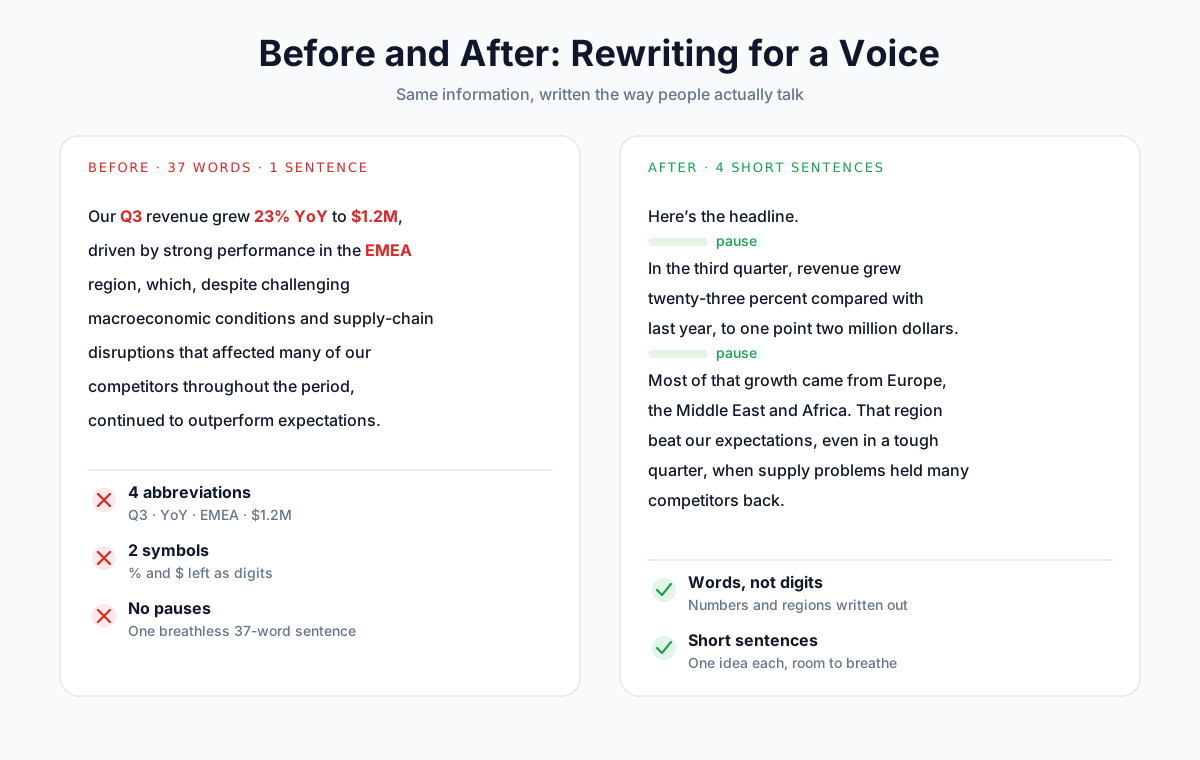
Önce (37 kelime, tek cümle):
Our Q3 revenue grew 23% YoY to $1.2M, driven by strong performance in the EMEA region, which, despite challenging macroeconomic conditions and supply-chain disruptions that affected many of our competitors throughout the period, continued to outperform expectations.
Sonra (dört kısa cümle):
Here's the headline. In the third quarter, revenue grew twenty-three percent compared with last year, to one point two million dollars.
Most of that growth came from Europe, the Middle East and Africa. That region beat our expectations, even in a tough quarter, when supply problems held many competitors back.
Neler değişti:
| Değişiklik | Kullanılan çözüm |
|---|---|
| "Q3", "YoY" (yıllık bazda) ve "EMEA" (Avrupa, Orta Doğu ve Afrika) kelimelere açıldı | 5 |
| "23%" ve "$1.2M" yazıyla yazıldı | 5 |
| 37 kelimelik tek cümle dörde bölündü | 3 |
| Haberden önce zemin hazırlayan kısa bir giriş cümlesi eklendi ("Here's the headline.") | 7 |
| Sonuçlar ile bağlam arasına paragraf arası kondu | 4 |
Bilgi aynı, ortada hiçbir numara yok. Ama neredeyse her seste ikinci sürüm konuşan bir insan gibi duyulur.
Peki Ya SSML?
SSML (Speech Synthesis Markup Language, yani Konuşma Sentezi İşaretleme Dili), bazı metin okuma motorlarının kabul ettiği bir etiket kümesidir. Örneğin belirli uzunlukta bir duraklama eklemek ya da bir kelimeyi belirli bir telaffuzla söyletmek için kullanılır.
<speak>
  Welcome back. <break time="700ms"/> Let's get started.
</speak>
SSML birçok klasik bulut sesinde hâlâ çalışıyor. Ama daha yeni ve daha ifadeli modeller onu giderek daha sık yok sayıyor ya da yalnızca bir kısmını destekliyor. Örneğin ElevenLabs, en yeni v3 ve v4 modellerinin SSML break etiketlerini desteklemediğini söylüyor. Google'ın Chirp 3 HD sesleri ise yalnızca bir alt kümesini destekliyor.
AnySpeech düz metinle çalışır; bu rehberdeki her çözümün etiketler yerine yazıma, noktalamaya ve ayarlara dayanmasının nedeni de bu. Bu yöntemler her seste ve her katmanda işe yarar.
Dile Özgü İpuçları
Yukarıdaki çözümlerin çoğu her dilde geçerli. Ancak bazı sorunlar özellikle İngilizce dışındaki metinlerde ortaya çıkıyor:
- O dil için geliştirilmiş bir ses seçin. Türkçe bir metin, Türkçe için geliştirilmiş bir seste çok daha doğal duyulur. Metin okuma dilleri sayfasında dile göre göz atın ya da İngiliz İngilizcesi gibi bir aksan seçin.
- Sayıları hedef dilde yazıyla yazın. Birden fazla dilin karıştığı metinlerde ses, rakamları yanlış dilde okuyabilir.
- Dilin kendi noktalama işaretlerini kullanın. Çince ve Japonca tam genişlikte işaretler (。,?) kullanır; sesler de bunları duraklama olarak algılar.
- Karışık dilli metinleri son hâline getirmeden önce test edin. Başka bir dilin içinde geçen marka adları ve İngilizce terimler sık rastlanan bir tuzaktır. Gerekirse bunları okunduğu gibi yazın (Çözüm 6).
Doğal Yapay Zeka Sesi Kontrol Listesi
Yayımlamadan önce bu listeyi gözden geçirin. Bir madde karşılanmıyorsa hangi çözümü kullanacağınızı hızlı teşhis tablosunda bulabilirsiniz.
- Ses içeriğe uyuyor (anlatıcı, sohbet havasında ya da enerjik)
- Cümleler kısa ve her birinde tek bir fikir var
- Resmî kalıplar yerine bir insanın konuşurken kullanacağı ifadeler seçilmiş ("mevcuttur" değil, "var")
- Her konu değişikliği bir paragraf arasıyla belirtilmiş
- Para tutarları, tarihler, saatler ve yüzdeler yazıyla yazılmış
- Zor isimler ve markalar okunduğu gibi yazılmış ya da telaffuz sözlüğünüze eklenmiş
- Önemli her cümlede anahtar kelime sona yakın, yüklemin hemen önünde duruyor
- Hız içeriğe uyuyor (anlatım için 0,9×–1,0× ile başlayın)
- Stabilite istediğiniz tona göre ayarlanmış
- Uzun metinler doğal kırılma noktalarından ve aynı ayarlarla bölünmüş
- Müzik, sesin en az 20 dB altında
- Kaydın tamamını baştan sona bir kez dinlediniz
Sıkça Sorulan Sorular
Yapay zeka sesim neden robotik duyuluyor?
Genellikle sesten değil, metinden. Uzun cümleler, eksik noktalama, kısaltmalar ve rakamlar yapay zeka seslerini düz ve aceleci bir okumaya iter. İçeriğe uymayan bir ses, fazla hızlı bir tempo ya da çok yüksek ayarlanmış stabilite de sesi monotonlaştırabilir.
En doğal duyulan yapay zeka sesi hangisi?
Bu içeriğe ve dile bağlı; o yüzden aynı metni birkaç seste deneyin. Bizim seçeneklerimiz arasında en doğal okumayı Gelişmiş ve Pro katmanları sunar. Gerçek bir insan sesinin klonu ise çoğu zaman daha da doğal duyulur: 2025'te yayımlanan bir PLOS One çalışmasında klonlar vakaların %58–70'inde insan sanıldı.
Metin okumada duraklama nasıl eklenir?
Noktalama işaretlerini kullanın. Virgüller kısa duraklamalar, noktalar tam duruşlar ekler; yeni bir paragraf ise en uzun duraklamayı sağlar. İki nokta ve uzun tire, önemli bir bilgiden önce kısa bir ara verdirir. Bazı motorlar SSML break etiketlerini de kabul eder, ama birçok yeni model bunları yok sayar.
Metin okumada bir kelimenin doğru telaffuz edilmesini nasıl sağlarım?
Kelimeyi okunduğu gibi yeniden yazın; örneğin "Nguyen" için "Win" ya da "read" fiilinin geçmiş zaman hâli için "red". AnySpeech'te bu yeni yazımı Pronunciation dictionary bölümüne kaydedin; böylece her seste otomatik olarak geçerli olur.
Yapay zeka anlatımı hangi hızda olmalı?
Çoğu anlatım için dakikada yaklaşık 150–155 kelime uygundur. ACX'e göre sesli kitap anlatıcıları saatte ortalama 9.300 kelime okuyor; bu da dakikada kabaca 155 kelime demek. 0,9× ile 1,0× arasında bir hızla başlayın, teknik içerikte biraz yavaşlatın.
Yapay zeka sesleri duygu ifade edebilir mi?
Evet. Premium sesler duyguyu kelimelerin kendisinden alır; bu yüzden duyguyu metne yazın ("Gözlerime inanamadım."). Stabiliteyi düşürmek daha geniş bir duygu yelpazesi sağlar. Pro ses klonlarında ayrıca duygu kontrolleri de bulunur.
Hâlâ SSML gerekiyor mu?
Çoğu proje için hayır. SSML, klasik bulut seslerinde tam uzunlukta duraklamalar ve kesin telaffuzlar için işe yarar; ama yeni, ifadeli modeller bazı etiketleri çoğu zaman yok sayar. Düz metin yöntemleri (noktalama, okunduğu gibi yazma ve sayıları yazıyla yazma) her motorda çalışır.
İnsanlar yapay zeka seslerini gerçek seslerden ayırt edebilir mi?
Çoğu zaman edemiyor. 2025'te yayımlanan bir PLOS One çalışmasında dinleyiciler ses klonlarını vakaların %58–70'inde insan sandı; gerçek insan kayıtlarında bu oran %62–81'di. Hazır yapay zeka sesleri ise yaklaşık %40 ile daha geride kaldı.
Bir Sonraki Seslendirmeniz İnsan Gibi Duyulsun
Robotik bir sesi düzeltmek için yeni bir araca ya da ses mühendisine ihtiyacınız yok. İşe metinden başlayın: daha kısa cümleler, gerçek noktalama ve yazıyla yazılmış sayılar. Ardından sese, hıza ve stabiliteye ince ayar yapın.
Hemen deneyin: Bir paragrafı AnySpeech metin okuma aracına yapıştırın, önce olduğu gibi bir kez oluşturun, ardından 3–5 numaralı çözümleri uygulayıp yeniden oluşturun. Farkı kolayca duyacaksınız.
Yazar

Kategoriler
Daha Fazla Yazı

Yapay Zeka Metin Okuma Nasıl Kullanılır: Yeni Başlayanlar İçin Kapsamlı Kılavuz (2025)
Yapay zeka metin okuma araçlarını adım adım nasıl kullanacağınızı öğrenin. Ücretsiz seçenekleri keşfedin, ses kalitesini karşılaştırın ve doğal sesli seslendirmeler oluşturmak için pratik ipuçları edinin.

TikTok'ta Metinden Sese Nasıl Kullanılır: Eksiksiz Rehber (2026)
iPhone ve Android'de TikTok metinden sese özelliğini adım adım nasıl kullanacağınızı öğrenin. Tüm sesler açıklandı, sorun giderme çözümleri ve profesyonel kalitede seslendirmeler için daha iyi AI alternatifleri.
Yapay Zeka Sesiyle Yüz Göstermeden YouTube Kanalı Nasıl Açılır? (2026)
Yapay zeka sesiyle yüz göstermeden YouTube kanalı açın: niş, senaryo, ses ve maliyet; YouTube'un 2026 yapay zeka, beyan ve para kazanma kuralları.