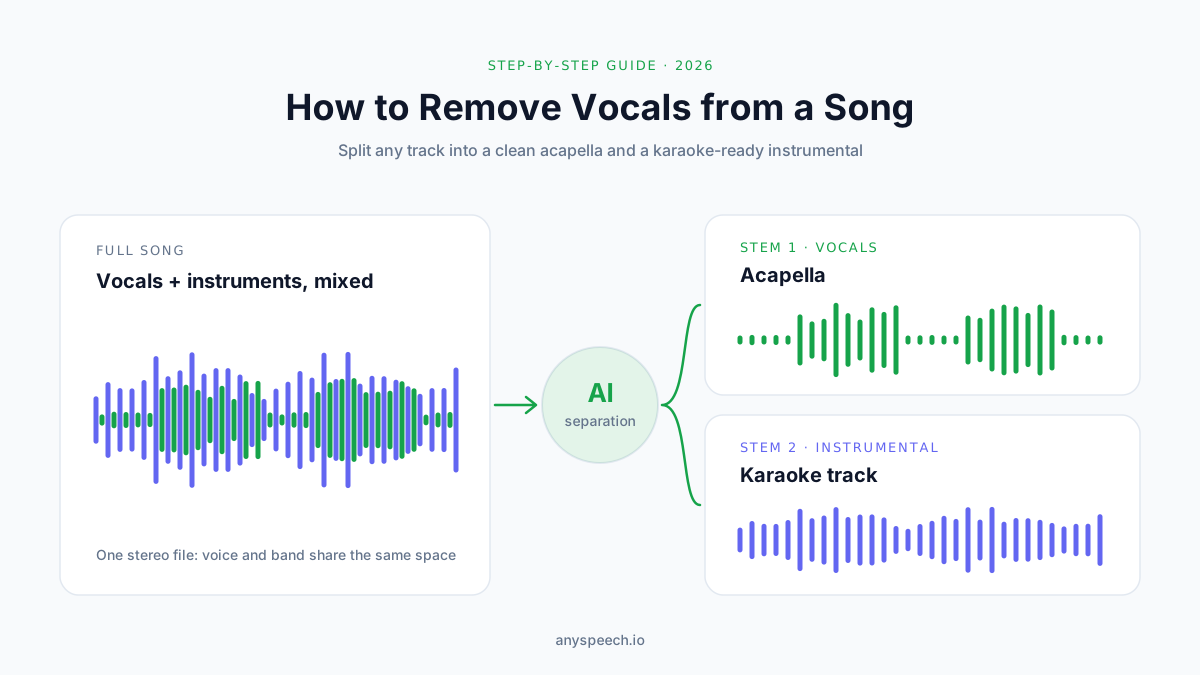
如何去除歌曲人声:5 种简单方法提取伴奏(2026)
用在线 AI 工具、Audacity、UVR、编曲软件或手机去除歌曲人声、提取伴奏。分步教程、效果不好时的修复方法,以及版权须知。
几年前,想把一首歌的人声去掉,基本就是把一个声道反相,然后听天由命。
结果通常是一段空洞的单声道音频:歌手的回声还在背景里飘,贝斯线却没了。
这招早就过时了。如今的 AI 分离模型用成千上万份多轨录音训练而成,能把人声从成品混音里干净地拎出来,干净到足以拿去唱 K、练琴、做 Remix,甚至做粗略的小样。
问题在于,现在的方法多达十几种,效果却参差不齐。
这篇教程会带你过一遍 5 种真正好用的方法:从一分钟出结果的网页工具,到免费的桌面软件。你还会看到公开评测数据怎么说、最常见的问题怎么修,以及法律边界在哪里。
这篇文章会告诉你:
- 最快的去人声方法,什么都不用装
- 如何在 Audacity 里免费去人声,包括大多数教程都没提到的 AI 插件
- 什么时候值得折腾 Ultimate Vocal Remover 这类桌面软件
- 如何使用 Logic Pro、Ableton Live 和 FL Studio 自带的分轨功能
- 如何修复残留和声、混响尾巴和「水声感」伴奏
- 分离出来的音轨,哪些用法合法、哪些不行
一句话答案: 想去除歌曲人声,把音频文件上传到 AI 去人声工具,让模型拆成两条分轨,然后下载伴奏即可。一首三分钟的歌大约一分钟完成。想要免费离线方案,可以用 Audacity 配合 Intel 的 OpenVINO Music Separation 插件,或者用 Ultimate Vocal Remover 桌面软件。
该用哪种方法?
下面每种方法都能得到伴奏,区别在于速度、成本、上手难度,以及你能掌控多少细节。
在逐步讲解之前,先看简版结论。
5 种方法一览
| 方法 | 成本 | 上手难度 | 速度(3 分钟歌曲) | 质量 | 最适合 |
|---|---|---|---|---|---|
| 1. 在线 AI 去人声工具 | 每天免费一首,之后付费 | 无需设置 | 约 1 分钟 | 高 | 大多数人、手机用户、偶尔用一次 |
| 2. Audacity + AI 插件 | 免费 | 中等 | 1–3 分钟 | 高 | 已在用 Audacity、需要离线处理 |
| 3. Ultimate Vocal Remover | 免费 | 中等到较高 | 几秒(GPU)到几分钟(CPU) | 很高,可调 | 进阶用户、批量处理 |
| 4. 编曲软件自带分轨 | 随软件附带 | 已有软件则很低 | 约 1 分钟 | 高 | 已在用 Logic、Ableton 或 FL 的制作人 |
| 5. 手机 App | 免费增值 | 需要安装 App | 约 1 分钟 | 高 | 随时随地练习的乐手 |
快速判断
拿不准从哪开始,就按下面的流程走。大多数人在第一个问题就能停下。
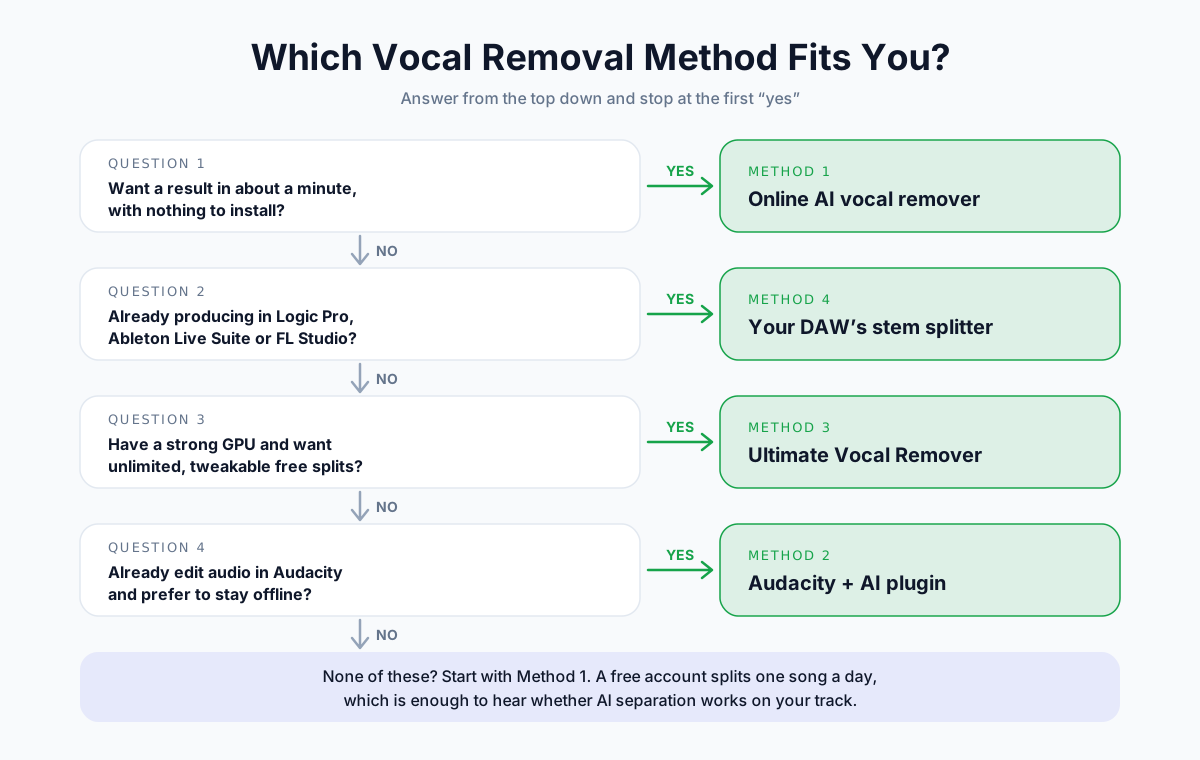
💡 小技巧: 动手分离之前,先搜一下有没有官方伴奏。很多专辑本身就附带伴奏版,热门歌曲的卡拉 OK 版也有大量正规授权。官方伴奏永远比分离出来的好。
开始之前:去人声到底是怎么实现的
不懂原理也能出结果。但懂一点能帮你避开最常见的坑,尤其是结果听起来不对、你想知道原因的时候。
「去人声」指的是什么?
去人声,就是把一首成品歌曲拆成若干独立的层(称为分轨),然后保留人声以外的所有部分。
大多数工具会输出两条分轨:
- 人声(干声 / Acapella): 主唱与和声,不含任何乐器
- 伴奏(卡拉 OK 伴奏): 鼓、贝斯、吉他、键盘以及其余一切
有些工具会拆得更细,分成四条或六条:人声、鼓、贝斯、钢琴、吉他和「其他」。如果只是去人声,两条分轨通常更干净,因为模型只需要做一个判断。
方法 A:相位抵消(老办法)
相位抵消利用的是一个混音习惯:主唱几乎总是放在正中间,所以左右声道里的人声完全相同。
原理
- 把立体声歌曲拆成左、右两个声道。
- 把其中一个声道的波形翻转(反相)。
- 再把两个声道叠加回去。
两边完全相同的内容会互相抵消成静音。人声消失了,但所有放在中间的其他声音也一起消失了。
为什么效果往往令人失望
问题就出在后半句。贝斯、底鼓和军鼓通常也混在正中间,所以它们也会一起被抹掉。
与此同时,人声里左右「不完全相同」的部分却会留下来:
- 人声上的立体声混响和延迟
- 左右声像摆开的和声与叠唱
- 混音时稍微偏离中间的人声
如果文件本身是单声道,左右声道本来就完全一样,抵消之后整首歌都没了。
方法 B:AI 音源分离(新办法)
AI 分离不关心人声放在哪个位置,它认的是人声「听起来是什么样」。
原理
一首歌可以画成一张频谱图:记录每一时刻有哪些频率在发声。
分离模型研究过成千上万首人声轨和伴奏轨分开保存的歌曲,学会了人声在这张图上长什么样。
遇到一首新歌,它会预测出一张「掩码」,标出属于人声的区域。用这张掩码得到干声,用它的反面得到伴奏。
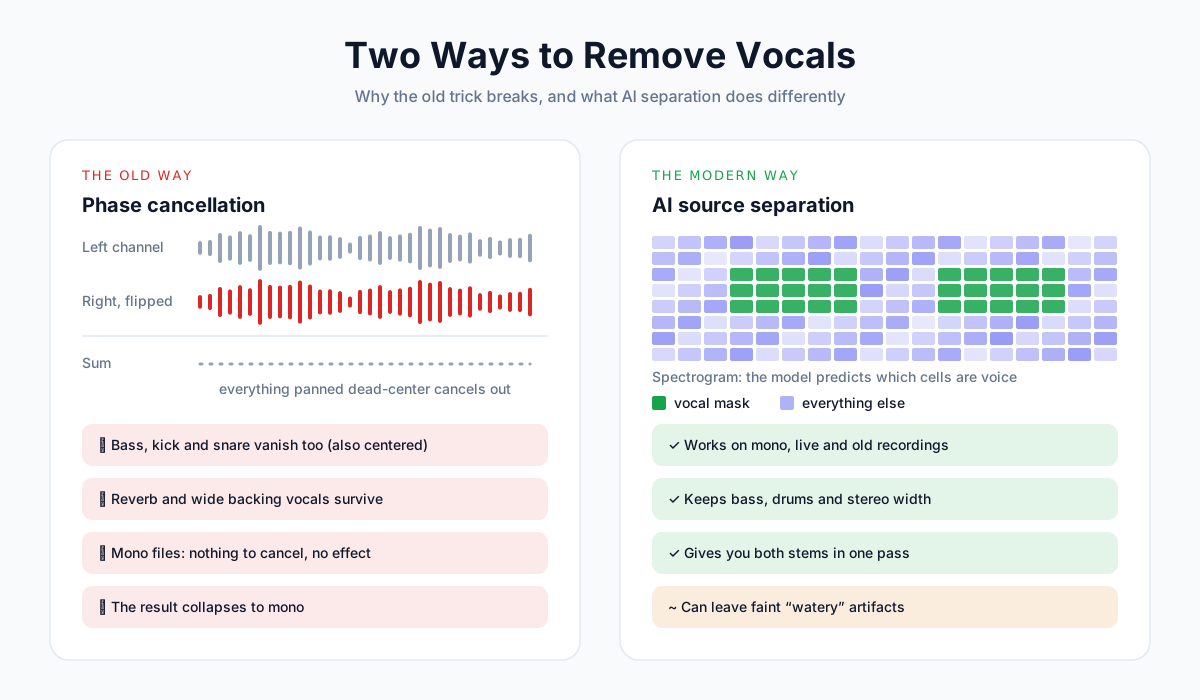
相位抵消 vs AI 分离对比
| 相位抵消 | AI 音源分离 | |
|---|---|---|
| 能处理单声道文件 | 不能 | 能 |
| 保留贝斯和底鼓 | 不能 | 能 |
| 处理立体声混响 | 不能 | 大部分可以 |
| 处理左右摆开的和声 | 不能 | 大部分可以 |
| 输出 | 只有单声道伴奏 | 立体声人声和伴奏 |
| 需要专门软件 | 不需要 | 需要(在线工具、插件或 App) |
| 典型效果 | 空洞,去除不彻底 | 干净,偶有轻微伪影 |
2026 年的 AI 去人声工具到底有多好?
研究人员用 SDR(信号失真比) 衡量分离质量,单位是分贝,测试集是包含 50 首歌的标准数据集 MUSDB18-HQ。数值越高越好,每提高 3 dB,残留误差大约减半。
下面是几个知名模型在人声分轨上的进步:
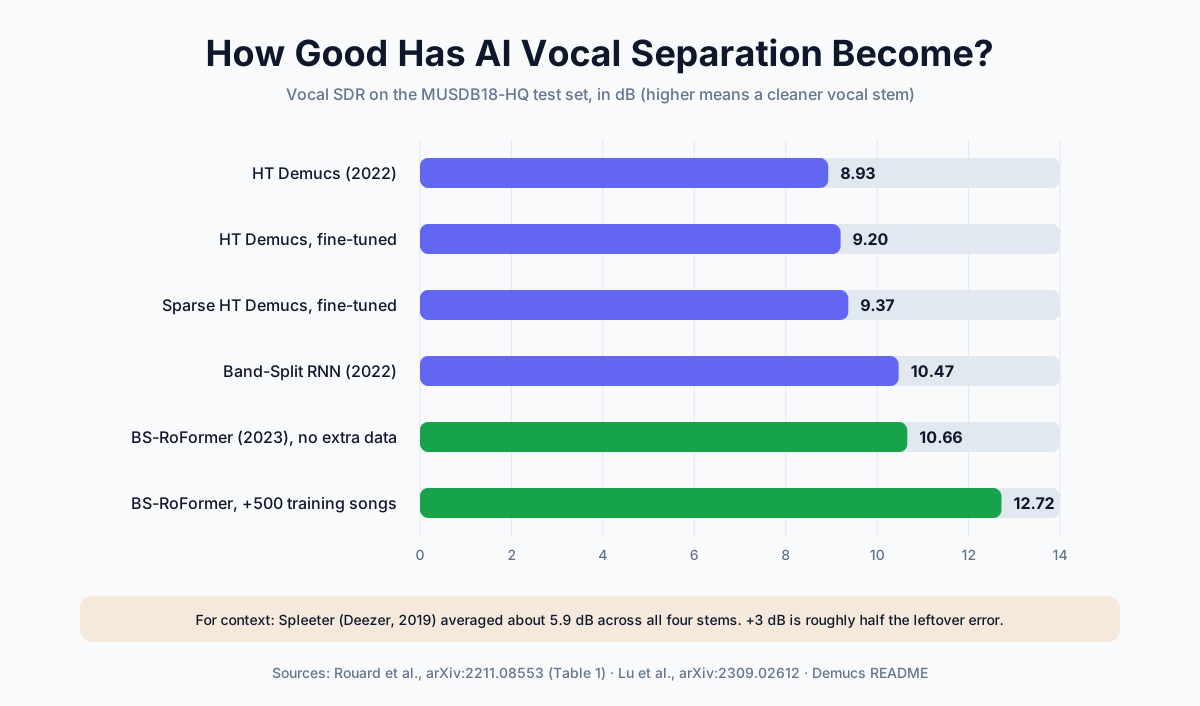
| 模型 | 发布方 | 年份 | 人声 SDR | 来源 |
|---|---|---|---|---|
| Spleeter | Deezer | 2019 | 约 5.9 dB(全部分轨平均值) | Demucs README 对比表 |
| Hybrid Transformer Demucs | Meta AI | 2022 | 8.93 dB | arXiv:2211.08553 |
| HT Demucs 微调版 | Meta AI | 2022 | 9.20 dB | arXiv:2211.08553 |
| Band-Split RNN | Luo & Yu | 2022 | 10.47 dB | 引自 arXiv:2211.08553 |
| BS-RoFormer(无额外数据) | ByteDance | 2023 | 10.66 dB | arXiv:2309.02612 |
| BS-RoFormer(+500 首歌) | ByteDance | 2023 | 12.72 dB | arXiv:2309.02612 |
结论: 仅仅一年的研究(2022 到 2023 年),公开的最佳人声分数就从大约 9–10.5 dB 提升到了 12.7 dB。如今的免费和低价工具,跑的正是这些模型或它们的近亲。
📝 注意: 评测分数是平均值。不管用哪个模型,编曲稀疏的原声歌曲都会比密集、重度压缩的摇滚母带分得更干净。
方法 1:用在线 AI 去人声工具
最适合: 想在一分钟左右拿到干净伴奏的人,电脑和手机都行。
我们建议先试这个方法。什么都不用装,也不需要显卡,花时间折腾别的方案之前,先听听结果够不够用。
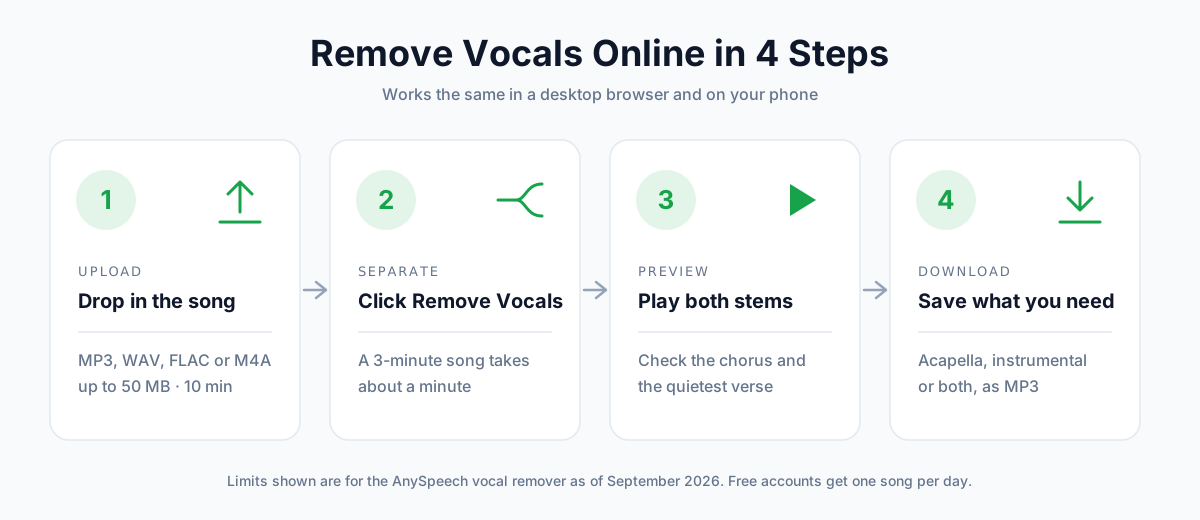
第 1 步:准备音频文件
输入质量决定输出质量。上传之前:
- 用你手上最好的音源。 WAV 或 FLAC 优于 MP3,320 kbps 的 MP3 优于 128 kbps。
- 避免录屏音频和外放翻录的音频。 房间回声和音箱音色会干扰模型。
- 剪掉静音或过长的前奏,如果文件接近时长上限的话。
支持的格式与限制
| 项目 | AnySpeech 去人声工具 |
|---|---|
| 支持格式 | MP3、WAV、FLAC、M4A(另支持 OGG 和 AAC) |
| 文件大小上限 | 50MB |
| 时长上限 | 每首 10 分钟 |
| 输出 | 人声与伴奏,均为 MP3 |
| 免费额度 | 免费账户每天 1 首 |
| 付费用量 | 每分钟音频 500 积分 |
暂不直接支持视频文件,请先把音轨导出为 MP3。
第 2 步:上传并开始分离
- 打开 AI 去人声工具。
- 把文件拖进上传区域,手机上点 Upload a File(上传文件)。
- 点击 Remove Vocals(一键去人声)。
一首三分钟的歌通常一分钟左右完成,更长的曲目耗时大致按比例增加。
第 3 步:试听两条分轨
别急着下载。先在页面上把两条音轨都放一遍,重点听最容易出问题的两个地方:
重点听哪里
- 最响的副歌。 编曲密集的段落,最容易在伴奏里藏着微弱的人声残留。
- 最安静的主歌。 编曲稀疏的段落,最容易暴露伴奏里的「水声感」伪影。
如果两处都干净,就大功告成了;如果不干净,跳到效果修复部分。
第 4 步:下载需要的音轨
唱 K 或练习就下载伴奏,做 Remix 或扒歌词就下载干声,也可以两条都下。免费账户可以完整下载两条分轨,不是 30 秒试听版。
其他热门在线去人声工具
大多数在线工具用的是相近的模型家族,实际差别主要在免费额度、时长上限和能拆几条分轨。
| 工具 | 免费额度(截至 2026 年 9 月) | 分轨数 | 备注 |
|---|---|---|---|
| AnySpeech | 每天 1 首,最长 10 分钟 | 2 | 同一账户还能用人声分离、语音转文字和文字转语音 |
| LALAL.AI | 少量免费分钟数 | 多种分轨类型 | 质量出色;付费按分钟购买 |
| Moises | 每月 5 次上传,每次 5 分钟 | 2–6(付费) | 另有 iOS 和 Android App |
| BandLab Splitter | 免费,文件最长 15 分钟 | 4 | 需要 BandLab 账户 |
| VocalRemover.org | 免费,带广告 | 2 | 适合偶尔快速分离一次 |
免费额度经常调整,依赖某个限制之前,请先去各工具的价格页确认。想看更全面的横向对比,可以读我们的音频分离工具实测排名。
方法 2:在 Audacity 里去人声(免费)
最适合: 已经在用 Audacity 剪音频、想要免费离线流程的人。
用 Audacity 去人声是搜索量最大的方法,也是被误解最多的方法。它其实有三种做法,而大多数老教程只讲了效果最差的那一种。
做法 A:AI Music Separation 插件(推荐)
Intel 免费发布了一套 Audacity 用 OpenVINO AI 插件,其中的 Music Separation 会在你自己的电脑上本地运行 Demucs v4 模型。
不用上传任何文件,就能得到 AI 级别的分轨。
如何安装
- 打开 Audacity 官方下载页,找到 OpenVINO AI plugins 部分。
- 下载与你的 Audacity 版本和操作系统匹配的版本。
- 运行安装程序,然后重启 Audacity。
- 打开 Effect › Plugin Manager(效果 › 插件管理器),确认 OpenVINO 相关效果已启用。
📝 注意: 这个插件针对特定的 Audacity 版本构建。如果安装后没有出现,请查看下载页上的兼容性说明。Audacity 刚发布新版本时,对应的插件版本有时会稍晚一些推出。
如何分离人声
- 在 Audacity 里打开歌曲(File › Open)。
- 按 Ctrl+A(Mac 上是 Cmd+A)选中整条音轨。
- 依次点击 Effect › OpenVINO AI Effects › OpenVINO Music Separation。
- 把 Separation Mode(分离模式)设为 (2 Stem) Instrumental, Vocals。
- 选择运行设备:有 GPU 或 NPU 就选它们,否则选 CPU。
- 点击 Apply(应用)并等待,通常需要一到三分钟。
- Audacity 会为每条分轨新增一条音轨。把人声轨静音或删除。
- 用 File › Export Audio 导出伴奏。
2 分轨模式 vs 4 分轨模式
| 模式 | 输出音轨 | 适用场景 |
|---|---|---|
| 2 分轨 | 伴奏、人声 | 只需要去掉人声。更干净,也更快。 |
| 4 分轨 | 鼓、贝斯、人声、其他 | 想重新调整各乐器比例,或者做练习用的混音。 |
做法 B:Vocal Reduction and Isolation 效果器
这就是大多数 Audacity 教程里讲的经典效果器。它基于中置声道抵消而不是 AI,所以前面提到的那些局限它都有。
重要: 从 Audacity 3.5 开始,这个效果器不再随默认安装包提供。你需要去 Audacity 的插件页面下载,再通过 Tools › Nyquist Plugin Installer 安装,并在插件管理器里启用。
如何使用
- 选中整首歌。
- 依次点击 Effect › Special › Vocal Reduction and Isolation。
- 把 Action(操作)设为 Remove Vocals。
- 按下表调整参数,点击 Preview(预览),再点 Apply。
参数说明
| 参数 | 默认值 | 作用 | 什么时候调整 |
|---|---|---|---|
| Strength(强度) | 1.0 | 去除中置声音的力度 | 人声残留就稍微调高;声音发空就调低 |
| Low Cut for Vocals(人声低切) | 120 Hz | 低于此频率的内容不做处理 | 保护贝斯和底鼓,不要调高太多 |
| High Cut for Vocals(人声高切) | 9,000 Hz | 高于此频率的内容不做处理 | 调低可以让镲片和踩镲保持明亮 |
做法 C:手动反相法
原理和上面一样,只是全部手动完成。主要适合用来理解原理,或者在没法安装插件的电脑上使用。
- 点击音轨名称菜单,选择 Split Stereo to Mono(分离立体声为单声道)。
- 只选中下方那条音轨。
- 依次点击 Effect › Special › Invert(反相)。
- 选中两条音轨,点击 Tracks › Mix › Mix and Render(混音并渲染)。
结果是一条单声道音轨,中置内容已被抵消。
Audacity 三种做法对比
| AI 插件 | Vocal Reduction 效果器 | 手动反相 | |
|---|---|---|---|
| 技术 | AI(Demucs v4) | 中置抵消 + 均衡频段 | 相位抵消 |
| 保留贝斯和鼓 | 能 | 部分保留 | 不能 |
| 能处理单声道文件 | 能 | 不能 | 不能 |
| 立体声输出 | 是 | 是 | 否 |
| 需要额外下载 | 需要 | 需要(3.5 起) | 不需要 |
方法 3:用 Ultimate Vocal Remover(免费桌面软件)
最适合: 想要最高免费质量、完全掌控模型选择、无限量批量处理的进阶用户。
Ultimate Vocal Remover(UVR) 是一款免费开源的桌面软件,支持 Windows、macOS 和 Linux。它是众多分离模型的图形界面,包括 Demucs、MDX-Net 以及较新的 Roformer 系列。
你需要什么
| 条件 | 建议 |
|---|---|
| 操作系统 | Windows 10/11、macOS 或 Linux |
| 显卡 | NVIDIA 显卡能让处理速度快得多;也支持 Apple 芯片的 Mac |
| 只有 CPU | 能用,但一首歌可能要好几分钟 |
| 磁盘空间 | 几 GB,每下载一个模型都会占用更多空间 |
| 技术门槛 | 能自如地选择模型和参数 |
如何用 UVR 去人声
- 从 UVR 的官方 GitHub 仓库下载并安装。
- 点击 Select Input,选择你的歌曲。
- 选择输出文件夹。
- 选择一种 Process Method(处理方式,见下表)。
- 从下拉菜单里选择模型。如果还没安装,就用下载中心获取。
- 有支持的显卡就勾选 GPU Conversion。
- 选择 Instrumental Only(仅伴奏)或 Vocals Only(仅人声)等输出选项,然后点击 Start Processing。
该选哪个模型家族
| 处理方式 | 优势 | 取舍 |
|---|---|---|
| Roformer 系列(如 BS-Roformer) | 目前人声/伴奏分离最干净的模型之一 | 更吃资源;没有 GPU 会很慢 |
| MDX-Net | 人声干净,综合表现好 | 编曲密集时可能留下轻微伪影 |
| Demucs v4 | 听感自然,支持多分轨 | 对和声的去除有时不够彻底 |
| VR Architecture | 速度快;带有去回声、去混响模型 | 作为主分离手段已经比较老 |
难搞歌曲的两遍处理流程
UVR 最大的优势是可以串联不同模型:
- 先用一个强力人声模型(Roformer 或 MDX-Net)分离歌曲。
- 再对伴奏跑一遍去混响或去回声模型,清除残留的人声混响。
这和用同一个模型重复分离两次不是一回事——后者通常只会越弄越糟,排障部分会详细讲。
方法 4:用编曲软件自带的分轨功能
最适合: 已经拥有 Logic Pro、Ableton Live Suite 或 FL Studio 的制作人。
分轨已经成了编曲软件(DAW)的标配功能。如果你本来就在付费使用其中一款,可能根本不需要别的工具。
各编曲软件分轨功能对比
| 编曲软件 | 功能名称 | 分轨 | 要求 |
|---|---|---|---|
| Logic Pro | Stem Splitter | 人声、鼓、贝斯、其他(新版本增加吉他和钢琴) | Apple 芯片 Mac 上的 Logic Pro 11 及以上,或 iPad 版 Logic Pro |
| Ableton Live | Separate Stems | 人声、鼓、贝斯、其他 | Live 12.3 及以上,仅限 Suite 版 |
| FL Studio | Extract stems from sample | 人声、鼓、贝斯、乐器 | FL Studio 21.2 及以上,Producer Edition 及更高版本 |
在 Logic Pro 里操作
- 把歌曲拖进一条音频轨。
- 选中这个片段。
- 按住 Control 点按片段,选择 Processing › Stem Splitter。
- 选一个预设,或者勾选需要的分轨,然后开始分离。
- 把人声轨静音,导出其余部分。
在 Ableton Live 12.3+ 里操作
- 把歌曲拖进一条音频轨。
- 右键点击片段,选择 Separate Stems to New Audio Tracks。
- 勾选需要的分轨,选择 High Quality(高质量;High Speed 只适合快速预览)。
- 分轨会放进一个按颜色区分的编组里。停用人声轨,导出其余部分。
在 FL Studio 里操作
- 把歌曲拖进 Playlist 或 Channel Rack。
- 在 Playlist 里右键点击音频片段,选择 Extract stems from sample。第一次使用时,FL Studio 会免费下载模型。
- 按需选择鼓、贝斯、乐器和人声,每条分轨都会放到单独的轨道上。
- 把人声静音,渲染其余部分。
💡 小技巧: 菜单名称会随版本更新而变化。找不到入口时,在软件帮助里搜索「stem separation」即可,各家的流程几乎一样。
方法 5:在 iPhone 或安卓手机上去人声
最适合: 随时随地练习的乐手,或者手边没有电脑的人。
做法 A:用网页工具(无需 App)
网页版去人声工具可以在手机 Safari 和 Chrome 里直接使用。
- 把歌曲保存到「文件」App(iPhone)或下载文件夹(安卓)。
- 在浏览器里打开去人声工具。
- 点 Upload a File,选择这首歌。
- 点 Remove Vocals,然后试听或下载分轨。
做法 B:用专门的 App
| App | 平台 | 免费额度 | 亮点功能 |
|---|---|---|---|
| Moises | iOS、Android、网页 | 每月 5 次上传,每次 5 分钟 | 变调、变速和和弦识别,方便练习 |
| BandLab | iOS、Android、网页 | 免费 | Splitter 分离结果可直接进入 BandLab 手机工作室 |
| iPad 版 Logic Pro | iPadOS | 订阅制 | 随身使用完整的 Stem Splitter |
做法 C:听歌时直接调低人声
如果你只是想跟着唱,可能根本不需要分离。
Apple Music Sing 可以让 Apple Music 订阅用户在支持的歌曲上实时调低人声音量,并同步显示歌词。它没法下载伴奏,但在家唱 K 的话,即开即用,而且完全正版。
附加技巧:用官方伴奏提取干声
有时候你要的正好相反:只要人声,不要音乐。
如果你同时有完整歌曲和它的官方伴奏,有个巧妙的办法。
原理
完整混音 =「伴奏 + 人声」。把伴奏减掉,剩下的就只有人声。
- 把两个文件上下排列,导入 Audacity。
- 对伴奏执行反相(Effect › Special › Invert)。
- 把两条音轨的起点精确对齐。
- 播放或导出混音,剩下的就只有人声。
什么时候会失败
| 问题 | 原因 |
|---|---|
| 仍然听得到音乐 | 两个文件来自不同的母带,或响度不同 |
| 出现奇怪的镶边(flanging)声 | 两条音轨错位了几个采样点 |
| 完全没效果 | 其中一个文件是有损 MP3,波形已经改变 |
这招失败时,直接用 AI 去人声工具处理完整歌曲,得到的干声反而更干净。
如何修复不理想的去人声结果
再好的模型,遇到某些歌也会失手。好消息是:大多数问题都有明确的原因和快速的解决办法。
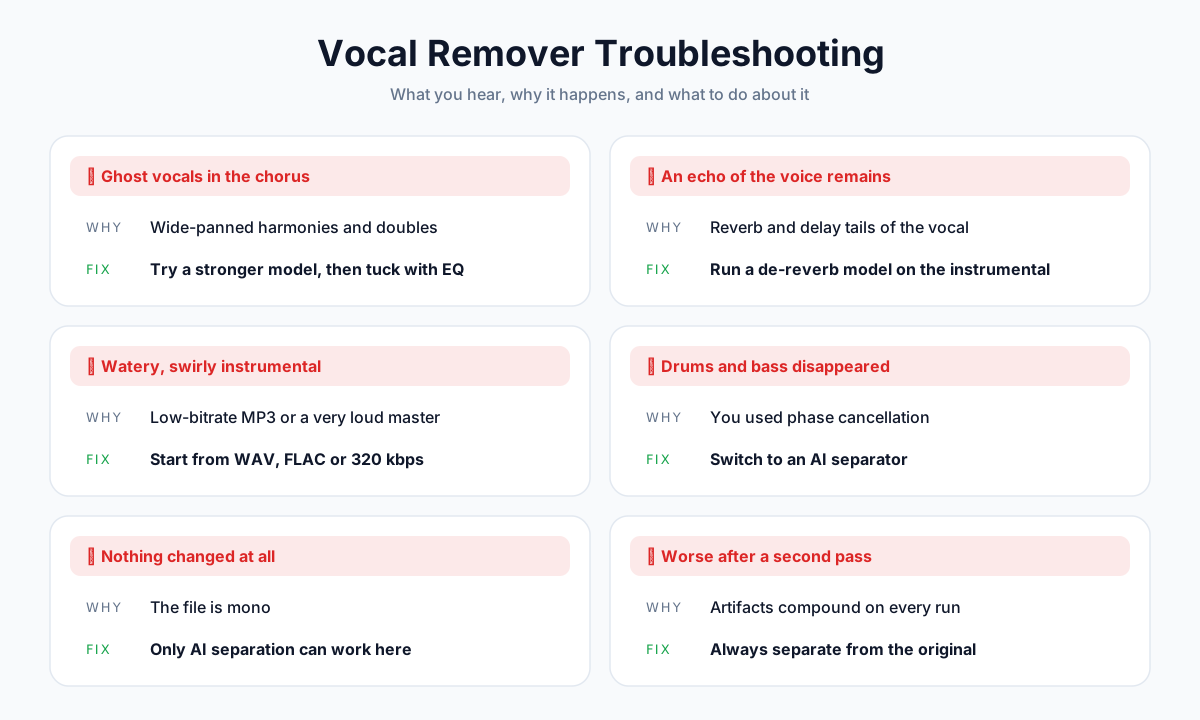
问题 1:副歌里有残留和声
听到什么: 最响的段落里有微弱的和声或叠唱。
原因: 和声往往左右摆得很开、处理得很重,在模型看来更像乐器。
怎么修:
- 换一个模型。Roformer 系列尤其擅长抓出和声层。
- 只在副歌段落,用均衡器在 1–4 kHz 附近做一个轻微衰减。
- 如果是唱 K 用,残留一点也可以接受,现场演唱会完全盖住它。
问题 2:留下了人声的回声
听到什么: 每句唱完后都拖着一条朦胧的尾巴。
原因: 混响和延迟把人声在时间和立体声空间上铺开了,其中一部分被归类成了「空间声」而不是「人声」。
怎么修:
- 对伴奏跑一遍去混响或去回声模型(UVR 里有好几个)。
- 如果空隙很短,噪声门或精细的音量自动化也能解决。
问题 3:伴奏有「水声感」
听到什么: 镲片、铺底音色或吉他上有一种旋转的、像在水下的质感。
原因: 人声和乐器共用频段的地方,模型拿不准。低码率 MP3 会让情况更糟,因为压缩早已把这些细节抹糊了。
怎么修:
- 换成 WAV、FLAC 或 320 kbps 文件重新分离。
- 用 2 分轨模式,而不是 4 或 6 分轨。
- 换一个模型家族试试。
为什么音源质量这么重要
| 音源文件 | 预期效果 |
|---|---|
| WAV / FLAC(无损) | 分离最干净 |
| MP3 320 kbps / AAC 256 kbps | 非常接近无损 |
| MP3 128 kbps | 镲片和混响上伪影明显 |
| 录屏音频、外放翻录 | 很差,房间声音会干扰模型 |
问题 4:鼓和贝斯不见了
原因: 你用的是相位抵消,它会去掉所有放在中间的声音。
解决: 换成上面任意一种 AI 方法。
问题 5:什么都没变
原因: 文件是单声道(老录音和一些从 YouTube 扒下来的音频很常见)。没有左右差异,抵消就无从下手。
解决: 单声道文件只能用 AI 分离。
问题 6:分离第二遍后反而更差
原因: 每次分离都会引入细微的伪影。把伴奏再喂回同一个模型,伪影会叠加。
解决: 始终从原始歌曲开始分离。如果需要额外清理,用另一类模型(比如去混响),而不是重复同一个。
分离出来的音轨能做什么?
拿到干净的分轨后,能做的事情一下子多了起来。
伴奏的用途
- 唱 K: 跟着原版编曲唱,而不是廉价的 MIDI 版本。
- 乐器练习: 和完整乐队合奏,只是少了你正在练的那一部分。
- 翻唱录音: 用真实的伴奏排练你自己的演唱。
- 私人项目的背景音乐: 不公开发布的幻灯片、家庭视频或课堂展示。
干声的用途
- Remix 和串烧: DJ 和制作人的原材料(发布任何作品之前,请先看下面的法律说明)。
- 研究演唱: 听清完整混音里被掩盖的咬字、换气和和声。
- 扒歌词: 单独的人声轨转写起来容易得多。把干声上传到语音转文字工具,就能得到一份带时间戳的歌词初稿。
不是歌曲?请用人声分离工具
如果你的音频是播客、访谈或带背景噪音的视频,而不是音乐,那去人声工具就用错了。人声分离工具专为语音调校,去掉的是嗡嗡声、车流声和房间底噪,而不是乐器。
如果你只是想让通话更清楚,手机可能本身就带这个功能。这里有 iPhone、Mac 和安卓上如何开启人声分离的教程。
去除歌曲人声合法吗?
对自己拥有的歌曲去人声、供个人使用,一般没有问题。但除非获得许可,公开发布或出售分离结果通常不行。
拆分文件这个动作本身很少出问题,关键在于你之后怎么用这些分轨。
为什么分轨比较敏感
一首已发行的歌曲包含两项独立的版权:
- 词曲作品: 旋律和歌词,归词曲作者和出版方所有。
- 录音制品: 那一版具体的录音演出,通常归唱片公司所有。
分离出来的伴奏仍然属于原始录音制品的一部分。所以,即使你拿到了翻唱词曲的授权,这个授权通常也不包括使用唱片公司的录音。
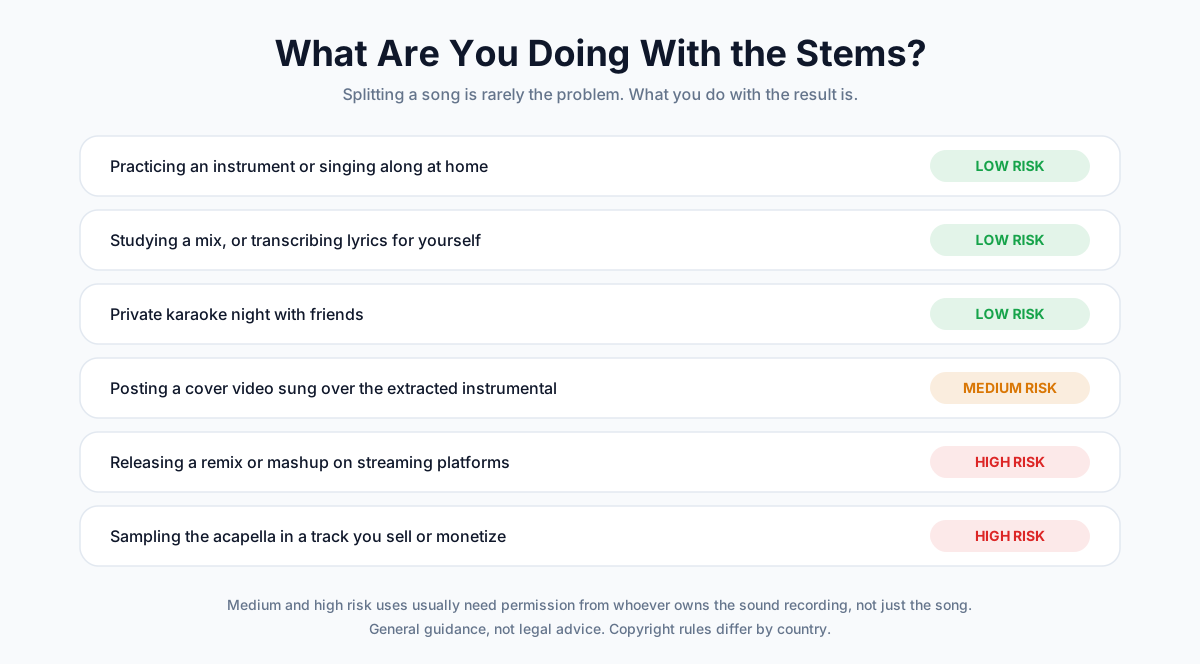
按风险等级划分的使用场景
| 你的用途 | 风险 | 原因 |
|---|---|---|
| 在家练习或跟唱 | 低 | 私人、非商业用途 |
| 研究混音或自己扒歌词 | 低 | 私人、非商业用途 |
| 和朋友私下唱 K | 低 | 没有公开传播 |
| 用分离出的伴奏发布翻唱视频 | 中 | 平台可能认领、静音或下架 |
| 在流媒体平台发布 Remix 或串烧 | 高 | 需要录音制品权利人的许可 |
| 在出售或变现的作品里采样干声 | 高 | 录音制品和词曲作品都需要清权 |
📝 注意: 以上仅为一般性说明,不构成法律建议。各国版权规则不同。如果你打算发布或变现基于他人录音的作品,请先咨询音乐律师或完成采样清权。
公开项目的安全替代方案
- 购买官方伴奏或卡拉 OK 版的授权。
- 使用免版税的伴奏。
- 自己重新编配录制,并按翻唱申请词曲授权。
常见问题
可以免费去除歌曲人声吗?
可以。免费方案包括:Audacity 配合 Intel 的 OpenVINO Music Separation 插件、Ultimate Vocal Remover 桌面软件,以及带免费额度的在线工具。AnySpeech 的去人声工具为免费账户每天提供一首,最长 10 分钟、50MB,两条分轨都可以完整下载。
去除歌曲人声最好的方法是什么?
对大多数人来说,在线 AI 去人声工具在质量和省事之间平衡得最好:上传,等一分钟左右,下载。已经拥有 Logic Pro、Ableton Live Suite 或 FL Studio 的制作人可以用自带的分轨功能。想要最大掌控度的进阶用户,可以试试 Ultimate Vocal Remover 搭配 Roformer 模型。
怎么用 Audacity 去除歌曲人声?
安装 Intel 免费的 OpenVINO AI 插件,选中歌曲,依次选择 Effect › OpenVINO AI Effects › OpenVINO Music Separation,使用 2 分轨模式。老的 Vocal Reduction and Isolation 效果器仍然能用,但它基于中置声道抵消,而且从 Audacity 3.5 起需要单独下载,不再内置。
为什么用了去人声工具还能听到人声?
通常是和声、叠唱或混响尾巴。它们左右摆得很开或在时间上被拉长,更难被正确归类。可以换一个模型、改用无损音源,并对伴奏跑一遍去混响模型。如果用的是相位抵消类方法,人声残留在意料之中,换成 AI 大多能解决。
单声道歌曲能去人声吗?
只能用 AI 分离。相位抵消依赖左右声道之间的差异,而单声道文件没有差异,所以抵消要么毫无作用,要么把整首歌都抹掉。AI 模型依据的是人声的声音特征而不是它在立体声里的位置,所以单声道录音也能正常分离。
去人声会降低音质吗?
会有一点。再好的模型也会留下轻微伪影,在镲片、混响和持续的铺底音色上最明显。用 WAV、FLAC 或 320 kbps MP3 作为音源能把影响降到最低。编曲密集、重度压缩的母带,伪影会比编曲稀疏的原声歌曲更明显。
怎么只提取歌曲里的人声(干声)?
用同样的工具,下载人声分轨而不是伴奏即可,本文的每种方法都会同时输出两者。如果你已经有官方伴奏,也可以把它反相后与完整歌曲叠加来抵消音乐,但前提是两个文件来自同一版母带。
能在 iPhone 上去除歌曲人声吗?
能。在 Safari 里打开网页版去人声工具,从「文件」App 上传歌曲;或者安装 Moises、BandLab 这类 App。如果只是想跟着唱,Apple Music Sing 可以在支持的歌曲上调低人声,无需生成文件。
能去除 YouTube 视频里的人声吗?
前提是你拥有这段音频的使用权。先合法下载或导出音轨(比如从 YouTube Studio 导出你自己上传的视频),保存为 MP3 或 WAV,再交给去人声工具处理。大多数在线去人声工具接受的是音频文件,而不是视频链接或视频文件。
去除一首歌的人声需要多久?
用在线 AI 工具,一首三分钟的歌大约一分钟。Audacity 的 AI 插件在较新的电脑上通常需要一到三分钟。Ultimate Vocal Remover 在性能强的 NVIDIA 显卡上几秒就能完成,只用 CPU 则可能要好几分钟。
总结
去除歌曲人声,过去是个只灵一半的小把戏,AI 分离把它变成了一件一分钟就能靠谱搞定的事。
最简单的路线是:
- 先用在线工具。 把一首歌上传到 AI 去人声工具,听听副歌。
- 需要时再转本地。 离线或批量处理,用 Audacity 的 AI 插件或 Ultimate Vocal Remover。
- 用你的编曲软件,如果你本来就在 Logic、Ableton 或 FL Studio 里做音乐。
- 喂给它好的音频。 换一个无损音源,解决的问题比换工具还多。
- 只做个人使用,除非你拿到了录音的授权。
准备试试了吗?把一首歌上传到免费的 AI 去人声工具,大约一分钟就能拿到干声和伴奏,无需信用卡。
如果你处理的不只是音乐,还可以看看我们的音频转文字教程,或者在音频分离工具实测排名里比较更多选择。
作者

分类
更多文章

如何在 TikTok 上使用文字转语音:完整指南(2026)
逐步了解如何在 iPhone 和 Android 上使用 TikTok 文字转语音。详解所有语音选项、故障排除方法,以及更好的 AI 替代工具,助你制作专业级配音。

2026年文字转语音完整指南:手机、电脑、视频工具全平台实操
详解如何在 iPhone、Android、谷歌文档、TikTok、Discord 等平台开启和使用文字转语音功能,附各设备操作步骤、关闭方法和提升效果的实用技巧。
如何用 AI 克隆你的声音:约 30 秒搞定(2026 步骤+工具对比)
约 30 秒就能用 AI 克隆出你自己的声音。手把手教你声音克隆、如何拿到最佳音质、加入情感、用其他语言开口说话,以及背后的伦理与安全。