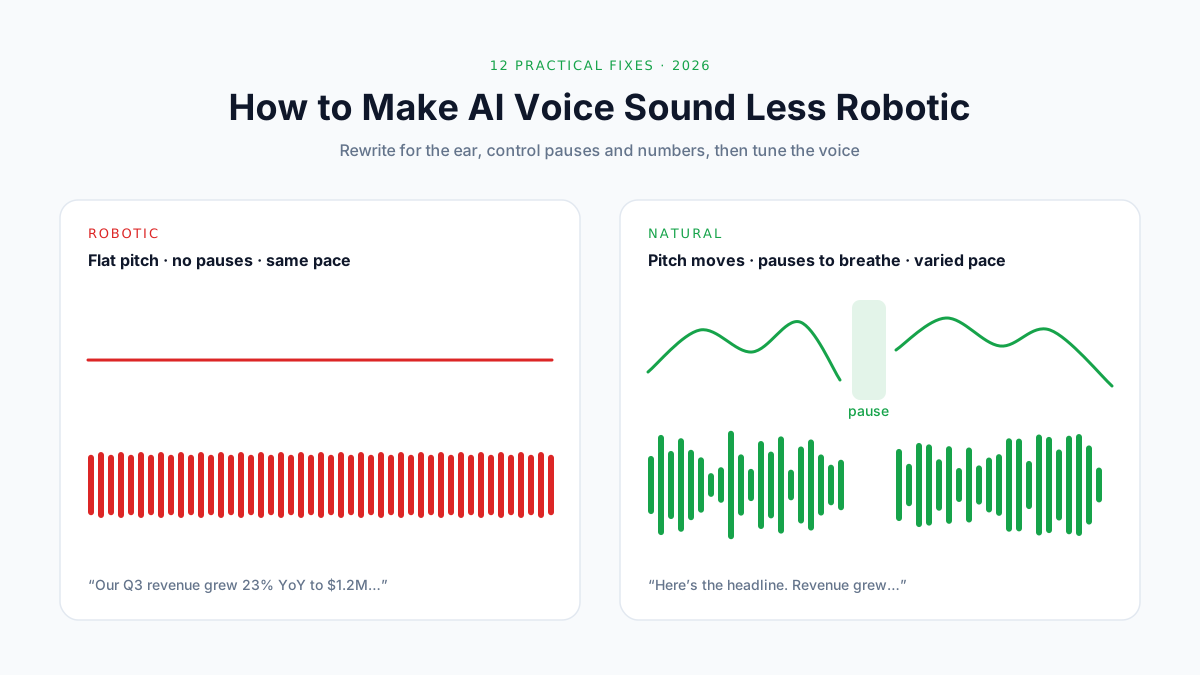
KI-Stimme natürlicher klingen lassen: 12 Tipps gegen den Roboterklang (2026)
Warum KI-Stimmen roboterhaft klingen und 12 Tipps, die helfen: fürs Ohr schreiben, Pausen setzen, Zahlen ausschreiben, Aussprache korrigieren, Tempo anpassen.
Sie fügen Ihr Skript ein, klicken auf Generieren, und die Stimme klingt … na ja, okay. Verständlich, aber flach. Sie hetzt durch Aufzählungen, betont die falschen Wörter und liest „$1.2M“ vor wie aus einer Excel-Tabelle.
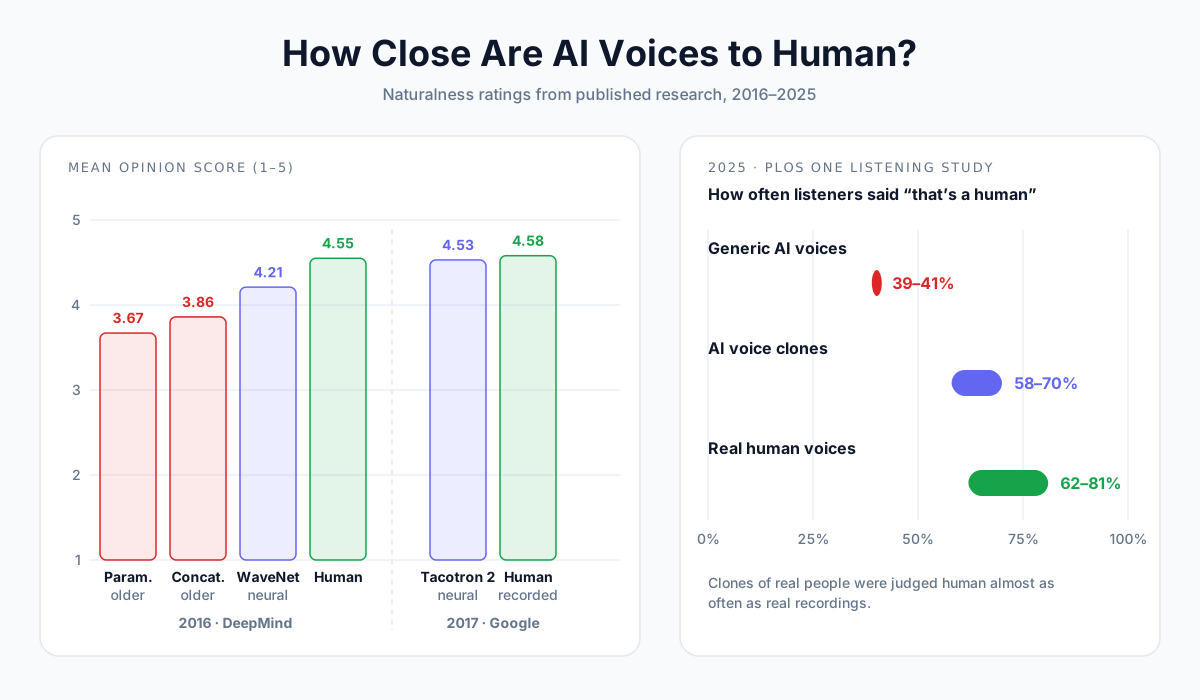
Das Überraschende daran: An der Technik liegt es heute nur noch selten. In einer 2025 in PLOS One veröffentlichten Studie hielten Hörer KI-Stimmklone in 58–70 % der Fälle für menschlich. Aufnahmen echter Menschen lagen mit 62–81 % nur knapp darüber.
Klingt eine KI-Stimme heute roboterhaft, liegt das meist am Skript und an den Einstellungen, nicht an der Engine. Beides lässt sich in wenigen Minuten beheben.
Wie das geht, zeigt Ihnen dieser Leitfaden.
Das erfahren Sie hier:
- Die fünf Gründe, warum KI-Sprache roboterhaft klingt
- Wie Sie schnell herausfinden, was mit Ihrem Audio nicht stimmt
- 12 Tipps, vom Umschreiben des Skripts bis zum Feinjustieren der Stimmeinstellungen
- Wie Sie Pausen, Zahlen und Aussprache ganz ohne Code steuern
- Wie schnell eine KI-Erzählstimme sprechen sollte, belegt mit echten Zahlen
- Eine komplette Vorher-nachher-Überarbeitung als Vorlage
Kurze Antwort: Damit eine KI-Stimme weniger roboterhaft klingt, formulieren Sie kurze Sätze wie im Gespräch, setzen Pausen mit Kommas, Punkten und Absätzen, schreiben Zahlen und Abkürzungen aus, schreiben falsch ausgesprochene Wörter so, wie sie klingen sollen, und wählen eine Stimme, die zum Inhalt passt. Drosseln Sie anschließend das Tempo leicht und senken Sie die Stabilität ein wenig, damit die Stimme mehr Ausdruck bekommt. In einem KI-Text-to-Speech-Tool dauert das meiste davon nur Sekunden.
Warum klingen KI-Stimmen roboterhaft?
Eine KI-Stimme klingt roboterhaft, wenn Rhythmus, Tonhöhe und Pausen nicht dazu passen, wie Menschen tatsächlich sprechen. Menschen variieren ihr Tempo, heben und senken die Stimme, holen zwischendurch Luft und betonen die Wörter, auf die es ankommt. Synthetische Sprache, die das nicht tut, klingt nach Roboter.
Die 5 Ursachen
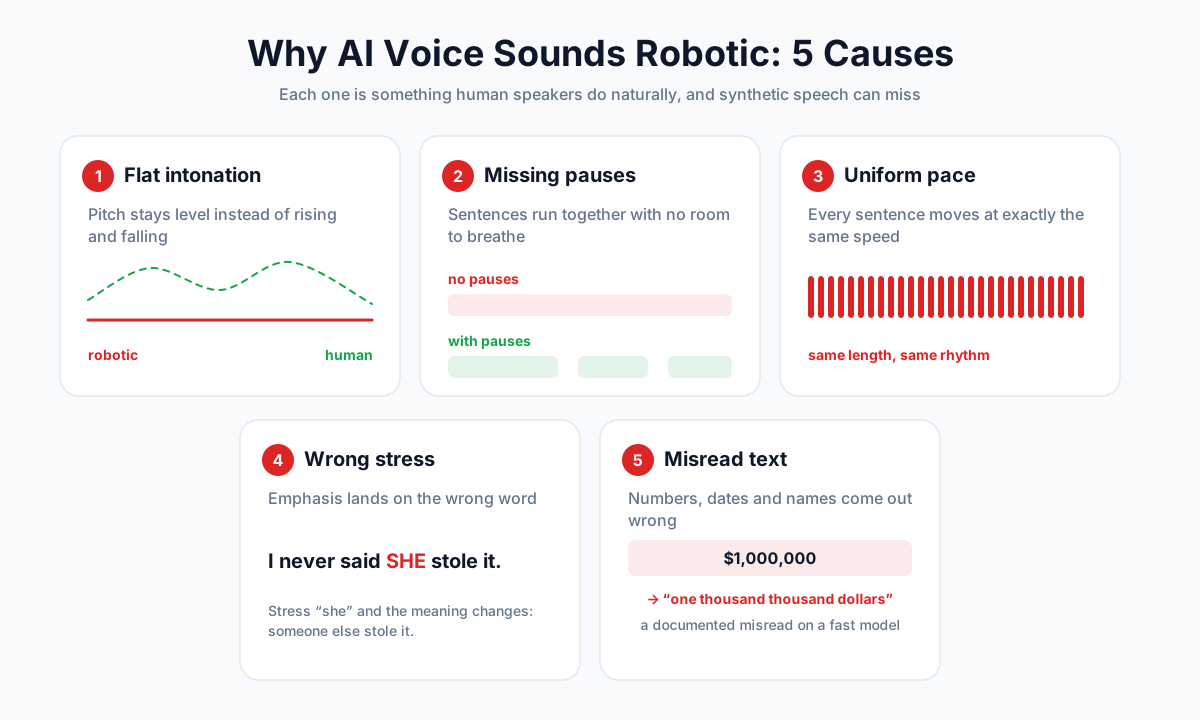
- Flache Intonation. Die Stimme bleibt auf einer Tonhöhe, statt mit dem Sinn zu steigen und zu fallen.
- Fehlende Pausen. Die Sätze gehen ineinander über, ohne Raum zum Atmen.
- Gleichförmiges Tempo. Jeder Satz läuft exakt gleich schnell ab.
- Falsche Betonung. Der Akzent liegt auf dem falschen Wort, und der Sinn verschiebt sich.
- Falsch gelesener Text. Bei Zahlen, Datumsangaben, Abkürzungen und Namen geht etwas schief.
Für den letzten Punkt gibt es in der Forschung einen eigenen Begriff: Textnormalisierung, also das Übertragen von geschriebenem Text in Wörter, die eine Stimme aussprechen kann. Das ist selbst für moderne Systeme schwierig, denn „1/2“ kann je nach Kontext „ein halb“, „zweiter Januar“ oder „erster Februar“ bedeuten.
Wie weit KI-Stimmen inzwischen sind
In der Sprachforschung misst man Natürlichkeit mit dem Mean Opinion Score (MOS): Hörer bewerten Clips auf einer Skala von 1 (schlecht) bis 5 (ausgezeichnet).
| Jahr | Meilenstein | Wert |
|---|---|---|
| 2016 | Ältere „parametrische“ und „konkatenative“ Stimmen (die Ära der blechernen Navi-Ansagen) | 3,67 und 3,86 MOS; Menschen kamen auf 4,55 |
| 2016 | WaveNet von DeepMind, die erste große neuronale Stimme | 4,21 MOS |
| 2017 | Tacotron 2 von Google | 4,53 MOS gegenüber 4,58 für aufgenommene Sprache |
| 2022 | NaturalSpeech von Microsoft | Kein statistisch signifikanter Unterschied zu Aufnahmen |
| 2025 | Hörstudie in PLOS One | Stimmklone in 58–70 % der Fälle für menschlich gehalten; echte Menschen in 62–81 % |
Dieselbe Studie ergab, dass generische KI-Stimmen (also nicht von einer realen Person geklont) nur in etwa 40 % der Fälle für menschlich gehalten wurden. Dieser Unterschied ist wichtig; wir kommen in Tipp 11 darauf zurück.
Roboterklang ist heute meist ein Skriptproblem
Moderne Stimmen können menschlich klingen. Aber sie lesen genau das vor, was Sie ihnen geben.
Ein Satz mit 45 Wörtern, drei Abkürzungen und einem Dollarbetrag klingt mit fast jeder Stimme roboterhaft. Derselbe Gedanke, fürs Ohr umgeschrieben, klingt mit den meisten natürlich. Deshalb drehen sich die meisten Tipps weiter unten um den Text.
Schnelldiagnose
Bevor Sie etwas ändern, hören Sie sich das Ergebnis einmal an und benennen Sie das Problem. Springen Sie dann zum passenden Tipp.
| Was Sie hören | Wahrscheinliche Ursache | Lösung |
|---|---|---|
| Flacher, monotoner Vortrag | Stimme passt nicht zum Inhalt oder Stabilität zu hoch eingestellt | Tipp 1, 2, 9 |
| Kein Raum zum Atmen zwischen den Gedanken | Lange Sätze, wenige Kommas oder Absätze | Tipp 3, 4 |
| Gehetzter, atemloser Vortrag | Tempo zu hoch, Aufzählungen in einen Satz gequetscht | Tipp 3, 8 |
| Betonung auf dem falschen Wort | Schlüsselwort mitten im Satz versteckt | Tipp 7 |
| „$1,000,000“ wird seltsam vorgelesen | Zahlen und Symbole als Ziffern stehen gelassen | Tipp 5 |
| Namen oder Marken falsch ausgesprochen | Ungewöhnliche Wörter, bei denen die Schreibung nicht verrät, wie man sie ausspricht | Tipp 6 |
| Klingt von Absatz zu Absatz anders | Langes Skript mit unterschiedlichen Einstellungen aufgeteilt | Tipp 10 |
| Klingt „zu sauber“, wie im Labor aufgenommen | Trockenes Audio, kein Raumton, keine Musik darunter | Tipp 12 |
Die 12 Tipps
Tipp 1: Mit der passenden Qualitätsstufe starten
KI-Stimme ist nicht gleich KI-Stimme. Schnellere, günstigere Modelle eignen sich hervorragend für Entwürfe. Premium-Modelle bekommen Rhythmus und Emotion besser hin.
Bei AnySpeech lässt sich derselbe Text in fünf Stufen generieren:
| Stufe | Am besten für | Gut zu wissen |
|---|---|---|
| Basic | Entwürfe, lange Texte, Barrierefreiheit | Gratis, nutzbar über unser kostenloses Text-to-Speech |
| Standard | Große Auswahl an Sprachen und Akzenten | 300+ Stimmen, 40+ Sprachen |
| Flash | Kurze, lebendige Texte im Gesprächston | Schnell und ausdrucksstark; bis zu 5.000 Zeichen pro Generierung |
| Advanced | Natürliche Erzählstimme in 70+ Sprachen | Unsere Voreinstellung für die meisten Vertonungen |
| Pro | Der nuancierteste, natürlichste Vortrag | Kostet 2 Credits pro Zeichen; nur in kostenpflichtigen Tarifen |
💡 Profi-Tipp: Wenn eine Zeile flach klingt, schreiben Sie sie nicht gleich um. Generieren Sie dieselbe Zeile zuerst in einer höheren Stufe. Klingt sie dann richtig, lag es an der Stimme. Klingt sie immer noch schief, liegt es am Skript.
Tipp 2: Eine Stimme wählen, die zum Inhalt passt
Eine Stimme, die in einem Werbespot großartig klingt, kann bei einer Gutenachtgeschichte seltsam wirken. Entscheiden Sie danach, wofür das Audio gedacht ist, nicht danach, welche Hörprobe am schönsten klingt.
| Inhalt | Worauf Sie achten sollten | Besser vermeiden |
|---|---|---|
| Hörbücher, Dokumentationen | Warme, ruhige Erzählstimme | Aufgedrehte „Ansager“-Stimmen |
| Erklärvideos, E-Learning | Klar, freundlich, mittleres Tempo | Sehr hauchige oder dramatische Stimmen |
| Werbung und Promos | Energiegeladen, hell | Langsame, sanfte Stimmen |
| YouTube und Social Media | Locker, natürlich | Übertrieben förmliche Stimmen |
| Meditation, Einschlafen | Ruhig, tief, langsam | Alles, was munter klingt |
Stöbern Sie in der Stimmbibliothek und filtern Sie nach Stil. Für YouTube-Skripte finden Sie im YouTube-Voiceover-Generator Stimmen, die sich zum Erzählen eignen.
Tipp 3: Fürs Ohr schreiben, nicht fürs Auge
Geschriebener und gesprochener Text sind zwei verschiedene Dinge. Stolpern wir beim Lesen über einen langen Satz, lesen wir ihn einfach noch einmal. Beim Zuhören geht das nicht.
- Halten Sie Sätze kurz. Peilen Sie weniger als 20 Wörter an. Teilen Sie alles, was länger ist.
- Nutzen Sie Kurzformen. „Ins“, „zum“ und „gibt’s“ klingen menschlich; „in das“, „zu dem“ und „gibt es“ wirken oft steif.
- Packen Sie einen Gedanken in jeden Satz. Wo zwei Gedanken per Relativsatz oder „und“ verknüpft sind, gerät der Rhythmus ins Stolpern.
- Schreiben Sie aktiv. „Wir haben zehn Tools getestet“ schlägt „Zehn Tools wurden von unserem Team getestet“.
- Lesen Sie den Text selbst laut vor. Wenn Ihnen die Luft ausgeht, geht sie auch der Stimme aus.
| Fürs Auge geschrieben | Fürs Ohr geschrieben |
|---|---|
| Nach Abschluss des Registrierungsvorgangs erhalten Nutzer eine Bestätigungs-E-Mail. | Sobald Sie sich registriert haben, schicken wir Ihnen eine Bestätigung per E-Mail. |
| Das Produkt, welches im Jahr 2024 eingeführt wurde, wird mittlerweile von über 10.000 Teams genutzt. | Wir sind 2024 gestartet. Seitdem haben sich mehr als zehntausend Teams angemeldet. |
Tipp 4: Mit Satzzeichen Pausen setzen
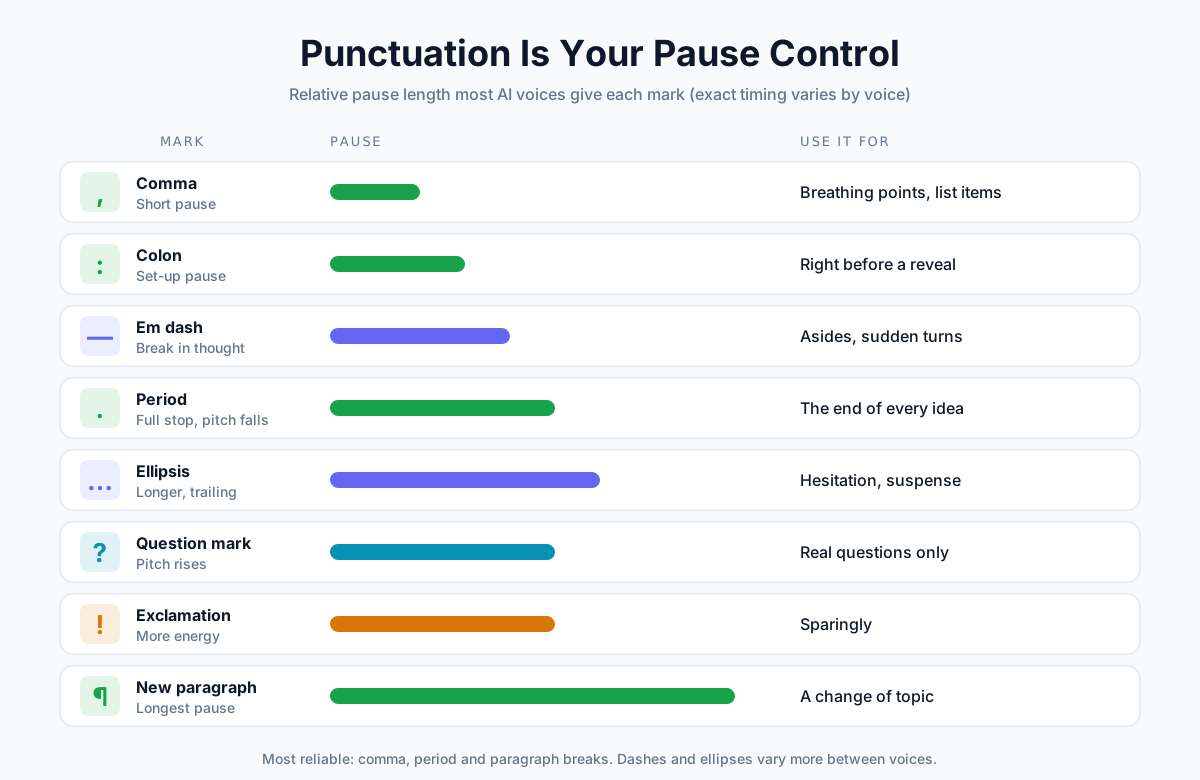
Moderne KI-Stimmen behandeln Satzzeichen wie Regieanweisungen. Ein Komma sorgt für ein kurzes Luftholen. Beim Punkt sinkt die Stimme ab. Ein neuer Absatz bringt die längste Pause von allen.
| Satzzeichen | Was es meist bewirkt | Wofür Sie es nutzen |
|---|---|---|
| Komma , | Kurze Pause | Atempausen, Aufzählungen |
| Punkt . | Satzende, die Tonhöhe sinkt | Das Ende jedes Gedankens |
| Doppelpunkt : | Kurze Pause, die etwas ankündigt | Direkt vor einer Auflösung oder Aufzählung |
| Gedankenstrich – | Ein Bruch im Gedankengang | Einschübe und plötzliche Wendungen |
| Auslassungspunkte … | Längere, ausklingende Pause | Zögern, Spannung |
| Fragezeichen ? | Die Tonhöhe steigt | Nur für echte Fragen |
| Ausrufezeichen ! | Mehr Energie | Sparsam, sonst klingt es schnell nach Geschrei |
| Neuer Absatz | Die längste Pause | Ein Themenwechsel |
📝 Hinweis: Wie lang die Pausen genau ausfallen, hängt von Stimme und Engine ab. Laut der Dokumentation von ElevenLabs erzeugen Gedankenstriche und Auslassungspunkte Pausen weniger zuverlässig als andere Methoden. Kommas, Punkte und Absätze sind am verlässlichsten.
Tipp 5: Zahlen, Datumsangaben und Symbole ausschreiben
Bei Ziffern und Symbolen stolpern KI-Stimmen am häufigsten, weil sich dieselben Zeichen auf mehrere Arten lesen lassen.
In der Dokumentation von ElevenLabs findet sich ein anschauliches Beispiel: Eines der schnellen Modelle des Anbieters kann „$1,000,000“ als „one thousand thousand dollars“ vorlesen, also sinngemäß „eintausend tausend Dollar“. Wer die Zahl ausschreibt, erspart jeder Stimme das Rätselraten.
| Statt | Schreiben Sie | Warum |
|---|---|---|
| $1,000,000 | eine Million Dollar | Vermeidet seltsam gruppierte Ziffern |
| $42.50 | zweiundvierzig Dollar und fünfzig Cent | Der Centbetrag wird richtig gelesen |
| 3:30 pm | fünfzehn Uhr dreißig | Eine Uhrzeit, kein Verhältnis |
| 2026-01-15 | fünfzehnter Januar zweitausendsechsundzwanzig | Datumsformate sind von Land zu Land verschieden |
| 25% | fünfundzwanzig Prozent | Manche Stimmen überspringen das Zeichen |
| Dr. Smith | Doktor Smith | Abkürzungen sind mehrdeutig (im Englischen kann „Dr.“ auch „Drive“ heißen) |
| Q3 | drittes Quartal | Abkürzungen werden buchstabiert |
| anyspeech.io/pricing | anyspeech Punkt io Schrägstrich pricing | URLs werden unberechenbar vorgelesen |
| 1/2 | ein halb | Könnte ein Datum sein |
Das müssen Sie nicht bei jeder Zahl tun. Kleine, einfache Zahlen wie „3“ oder „10“ sind meist kein Problem. Konzentrieren Sie sich auf Geldbeträge, Datumsangaben, Uhrzeiten, Prozentwerte und alles mit Symbolen.
Tipp 6: Aussprache mit phonetischer Schreibweise korrigieren
Spricht eine Stimme einen Namen oder eine Marke falsch aus, schreiben Sie das Wort so, wie es klingen soll. Das wirkt wie eine Notlösung, ist aber die einzige Methode, die mit jeder Engine funktioniert.
| Wort | Schreiben als | Welches Problem es löst |
|---|---|---|
| Nguyen | Win | Häufiger Nachname, oft falsch gelesen |
| Worcestershire | Wuss-ter-sher | Stumme Buchstaben |
| AnySpeech | Any Speech | Markenname aus zusammengeschriebenen Wörtern |
| SQL | sequel (oder S Q L) | Akronym oder Wort? |
| read (Vergangenheitsform) | red | Gleiche Schreibung, anderer Klang |
| live (Adjektiv) | lyve | „a lyve show“ im Gegensatz zu „I live here“ |
| GIF | jif (oder gif) | Entscheiden Sie sich für eine Variante und bleiben Sie dabei |
Bei AnySpeech müssen Sie dafür nicht jedes Skript bearbeiten. Öffnen Sie auf der Text-to-Speech-Seite das Pronunciation dictionary (Aussprachewörterbuch), füllen Sie Written text (geschriebener Text) und Say it like (ausgesprochen wie) aus, und die Regel gilt automatisch für jede Stimme. Wenn Sie angemeldet sind, können Sie bis zu 50 Regeln speichern.
💡 Profi-Tipp: Soll ein Akronym Buchstabe für Buchstabe gesprochen werden, fügen Sie Leerzeichen oder Punkte ein: „F B I“ oder „F.B.I.“. Akronyme, die als Wort gelesen werden, etwa „NASA“, lassen Sie einfach so stehen.
Tipp 7: Betonung über den Satzbau steuern
In einem Tool, das nur reinen Text verarbeitet, können Sie kein Wort mit „hier betonen“ markieren. Aber Sie können die Betonung darüber steuern, wie Sie den Satz bauen.
- Stellen Sie das Schlüsselwort nach hinten. Im Deutschen wie im Englischen liegt die natürliche Betonung meist gegen Ende des Satzes. Vergleichen Sie „Das Ergebnis hat alle überrascht“ mit „Alle waren von dem Ergebnis überrascht“.
- Geben Sie dem wichtigen Wort einen eigenen Satz. „Es ist kostenlos. Komplett kostenlos.“ Kurze Sätze haben Wucht.
- Nutzen Sie Doppelpunkt oder Gedankenstrich für die Auflösung. „Eines zählt hier wirklich: das Timing.“
- Verzichten Sie auf GROSSBUCHSTABEN. Viele Stimmen halten Großbuchstaben für ein Akronym und buchstabieren das Wort.
Tipp 8: Das richtige Tempo einstellen
Eine etwas zu schnelle Stimme ist der häufigste Grund, warum eine Erzählung maschinell klingt. So machen es echte Sprecher:
| Inhalt | Typisches Tempo | Startwert für die Geschwindigkeit |
|---|---|---|
| Hörbuch-Erzählung | Etwa 155 Wörter pro Minute (ACX) | 0,9×–1,0× |
| Alltagsgespräch | Etwa 150 Wörter pro Minute | 1,0× |
| Tutorials, technische Inhalte | Etwas langsamer als im Gespräch | 0,9× |
| Werbung und Promos | Schneller, energiegeladen | 1,05×–1,1× |
| Meditation, Einschlafen | Langsam, mit viel Raum | 0,8× |
Die Zahl 155 stammt von ACX, der Hörbuchplattform von Audible. Laut ACX lesen die meisten Sprecher etwa 9.300 Wörter pro Stunde.
Bei AnySpeech reicht der Regler Geschwindigkeit in den Stufen Standard, Advanced und Pro von 0,7× bis 1,2×. Verstellen Sie ihn in kleinen Schritten von 0,1×. Größere Sprünge können eine Stimme gedehnt oder gestaucht klingen lassen.
Tipp 9: Stabilität und Ähnlichkeit feinjustieren
In den Stufen Advanced und Pro bestimmen zwei Regler, wie ausdrucksstark die Stimme ist.
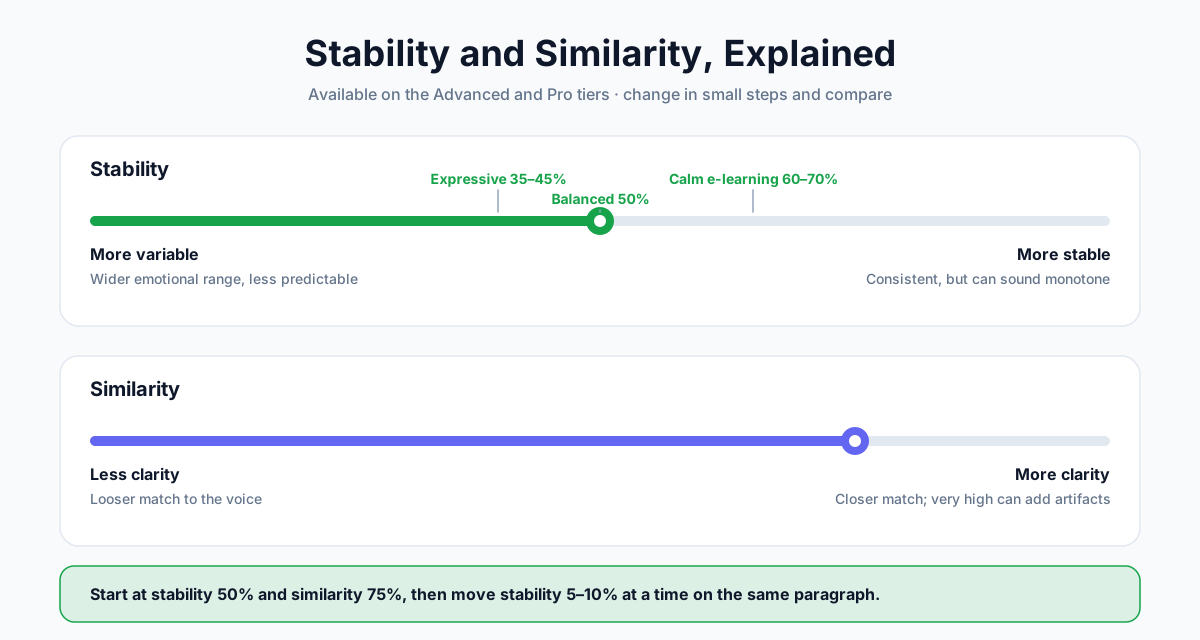
| Regler | Niedriger | Höher |
|---|---|---|
| Stabilität | Variabler: größere emotionale Bandbreite, aber weniger vorhersehbar | Stabiler: gleichmäßig, kann aber monoton klingen |
| Ähnlichkeit | Weniger Klarheit, weniger genaue Übereinstimmung mit der Stimme | Mehr Klarheit, genauere Übereinstimmung; sehr hohe Werte können Artefakte erzeugen |
Ein praxistauglicher Ausgangspunkt:
| Ziel | Stabilität | Ähnlichkeit |
|---|---|---|
| Ausdrucksstarkes Storytelling | 35–45 % | 75 % |
| Ausgewogene Erzählung (Voreinstellung) | 50 % | 75 % |
| Gleichmäßiges, ruhiges E-Learning | 60–70 % | 75–80 % |
Verändern Sie die Stabilität in Schritten von etwa 5–10 % und generieren Sie jedes Mal denselben Absatz neu, damit Sie vergleichen können.
Tipp 10: Lange Skripte abschnittsweise generieren
Lange Skripte bringen zwei Probleme mit sich. Geht ein Satz schief, müssen Sie alles neu generieren. Und wenn Sie das Skript unbedacht aufteilen, kann jeder Teil etwas anders klingen.
- Teilen Sie das Skript an natürlichen Übergängen: bei Kapiteln, Szenen oder Themenwechseln, niemals mitten im Absatz.
- Behalten Sie für jeden Teil identische Einstellungen bei: dieselbe Stimme, Stufe, Geschwindigkeit und Stabilität.
- Benennen Sie Ihre Dateien fortlaufend (01-einleitung, 02-einrichtung …), damit sie sich leicht zusammenfügen lassen.
Bei AnySpeech lassen sich in kostenpflichtigen Tarifen bis zu 50.000 Zeichen auf einmal generieren (5.000 im kostenlosen Tarif und in der Stufe Flash). Trotzdem ist eine einzelne Zeile viel leichter zu korrigieren, wenn Sie Kapitel für Kapitel generieren.
Tipp 11: Eine geklonte menschliche Stimme verwenden
Erinnern Sie sich an die Studie in PLOS One? Stimmklone echter Menschen wurden deutlich häufiger für menschlich gehalten als generische KI-Stimmen: in rund 58–70 % der Fälle gegenüber etwa 40 %.
Ein Klon übernimmt Rhythmus, Eigenheiten und Atemgewohnheiten eines echten Menschen. Wenn Sie regelmäßig Texte einsprechen, können Sie aus einer kurzen Aufnahme Ihre eigene Stimme klonen und sie für jedes Skript verwenden.
- Nehmen Sie in einem ruhigen Raum auf, ohne Musik und ohne Hall.
- Sprechen Sie so, wie der Klon klingen soll: entspannt und natürlich, nicht im „Ansager“-Modus.
- Klonen Sie nur Ihre eigene Stimme oder eine Stimme, für die Sie eine eindeutige Erlaubnis haben.
Unser Leitfaden zum Stimmenklonen führt Sie Schritt für Schritt durch die Aufnahme.
Tipp 12: In der Postproduktion den letzten Schliff geben
Unbearbeitetes KI-Audio kann unnatürlich „sauber“ klingen, wie eine Stimme, die im leeren Raum schwebt. Mit ein paar behutsamen Handgriffen kommt sie in der echten Welt an.
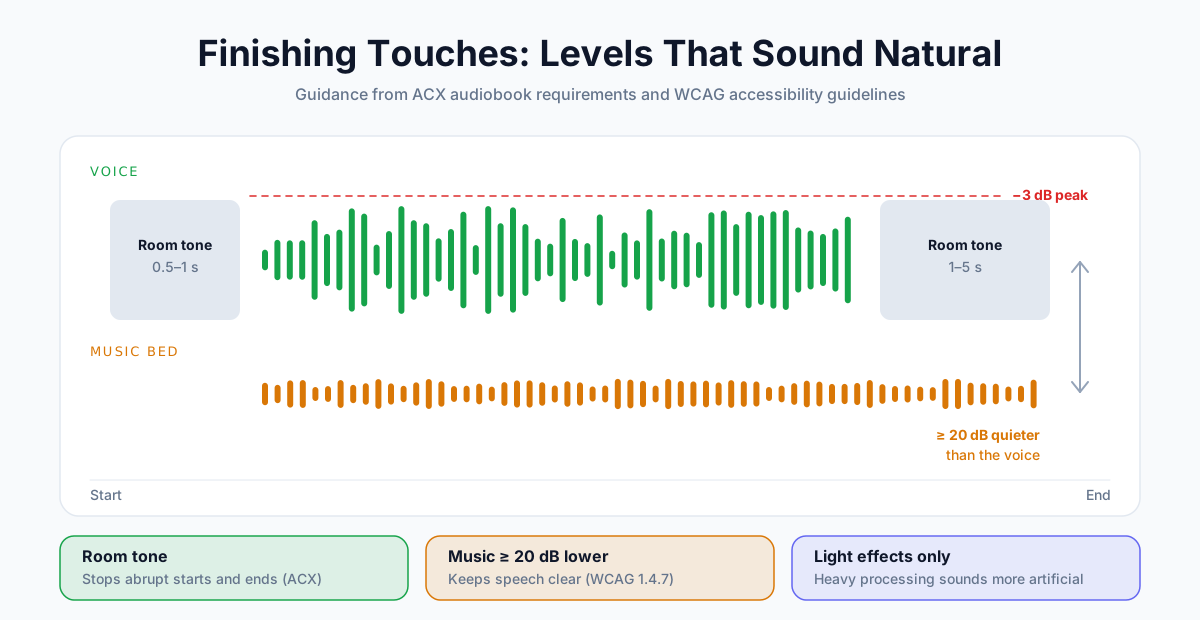
- Fügen Sie Raumton hinzu. ACX verlangt 0,5–1 Sekunde Raumton am Anfang jeder Datei und 1–5 Sekunden am Ende. So beginnt und endet das Audio nicht abrupt.
- Halten Sie die Musik deutlich unter der Stimme. Die Barrierefreiheitsrichtlinien WCAG empfehlen, Hintergrundaudio mindestens 20 Dezibel leiser zu halten als die Sprache.
- Gehen Sie sparsam mit Effekten um. Starke Kompression, viel Hall oder ein kräftiger EQ können eine synthetische Stimme noch künstlicher klingen lassen statt natürlicher.
- Halten Sie die Pegelspitzen unter −3 dB, damit das Audio bei lauter Wiedergabe nicht übersteuert (ebenfalls eine Vorgabe von ACX).
Vorher und nachher: eine komplette Überarbeitung
Hier ein Absatz im typischen Stil eines Geschäftsberichts und darunter dieselbe Passage, umgeschrieben für eine Stimme.
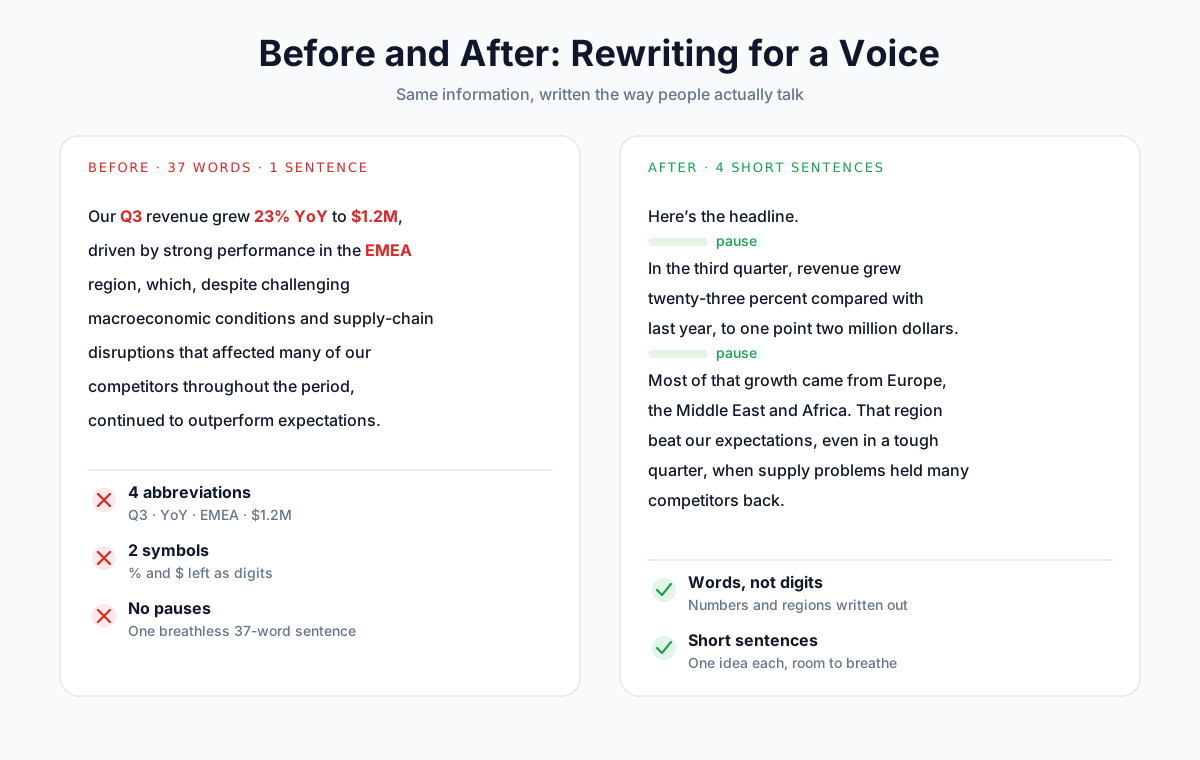
Vorher (37 Wörter, ein Satz):
Our Q3 revenue grew 23% YoY to $1.2M, driven by strong performance in the EMEA region, which, despite challenging macroeconomic conditions and supply-chain disruptions that affected many of our competitors throughout the period, continued to outperform expectations.
Nachher (vier kurze Sätze):
Here's the headline. In the third quarter, revenue grew twenty-three percent compared with last year, to one point two million dollars.
Most of that growth came from Europe, the Middle East and Africa. That region beat our expectations, even in a tough quarter, when supply problems held many competitors back.
Was sich geändert hat:
| Änderung | Angewandter Tipp |
|---|---|
| „Q3“, „YoY“ und „EMEA“ in Wörter aufgelöst | Nr. 5 |
| „23%“ und „$1.2M“ ausgeschrieben | Nr. 5 |
| Ein Satz mit 37 Wörtern in vier aufgeteilt | Nr. 3 |
| Ein kurzer Einstieg („Here's the headline.“), der die Neuigkeit ankündigt | Nr. 7 |
| Ein Absatzwechsel zwischen Ergebnis und Hintergrund | Nr. 4 |
Dieselben Informationen. Keine Zauberei. Aber mit fast jeder Stimme klingt die zweite Fassung so, als würde ein Mensch sprechen.
Und was ist mit SSML?
SSML (Speech Synthesis Markup Language) ist eine Sammlung von Tags, die manche Text-to-Speech-Engines verstehen, etwa um eine Pause mit exakter Länge einzufügen oder ein Wort in einer bestimmten Aussprache zu sprechen.
<speak>
  Welcome back. <break time="700ms"/> Let's get started.
</speak>
Bei vielen klassischen Cloud-Stimmen funktioniert SSML nach wie vor. Neuere, ausdrucksstärkere Modelle ignorieren es aber zunehmend oder unterstützen nur einen Teil davon. ElevenLabs etwa gibt an, dass seine neuesten Modelle v3 und v4 keine SSML-Break-Tags unterstützen. Die Google-Stimmen der Reihe Chirp 3 HD unterstützen nur eine Teilmenge.
AnySpeech arbeitet mit reinem Text. Deshalb setzen alle Tipps in diesem Leitfaden auf Formulierung, Satzzeichen und Einstellungen statt auf Tags. Diese Methoden funktionieren mit jeder Stimme und in jeder Stufe.
Sprachspezifische Tipps
Die meisten Tipps oben gelten für jede Sprache. Ein paar Probleme treten aber speziell bei nicht-englischen Texten auf:
- Nutzen Sie eine muttersprachliche Stimme. Ein deutsches Skript klingt mit einer Stimme, die für Deutsch entwickelt wurde, deutlich natürlicher. Stöbern Sie auf der Seite Text-to-Speech-Sprachen nach Sprache oder wählen Sie einen Akzent, etwa britisches Englisch.
- Schreiben Sie Zahlen in der Zielsprache aus. In gemischtsprachigen Texten liest eine Stimme Ziffern womöglich in der falschen Sprache vor.
- Verwenden Sie die Satzzeichen der jeweiligen Sprache. Chinesisch und Japanisch nutzen Satzzeichen in voller Zeichenbreite (。,?), die Stimmen als Pausen behandeln.
- Testen Sie gemischtsprachige Texte, bevor Sie sich festlegen. Markennamen und englische Begriffe mitten in einer anderen Sprache sind eine häufige Stolperfalle. Schreiben Sie sie bei Bedarf so, wie sie klingen sollen (Tipp 6).
Checkliste für eine natürliche KI-Stimme
Gehen Sie diese Liste durch, bevor Sie veröffentlichen. Ist ein Punkt nicht erfüllt, zeigt Ihnen die Tabelle zur Schnelldiagnose, welcher Tipp hilft.
- Die Stimme passt zum Inhalt (Erzählstimme, locker oder energiegeladen)
- Die Sätze sind kurz und enthalten je einen Gedanken
- Kurzformen wie „ins“ oder „gibt’s“ stehen dort, wo auch ein Mensch sie verwenden würde
- Absätze markieren jeden Themenwechsel
- Geldbeträge, Datumsangaben, Uhrzeiten und Prozentwerte sind ausgeschrieben
- Schwierige Namen und Marken sind phonetisch umgeschrieben oder stehen in Ihrem Aussprachewörterbuch
- Das Schlüsselwort jedes wichtigen Satzes steht gegen Ende
- Die Geschwindigkeit passt zum Inhalt (für Erzählungen mit 0,9×–1,0× beginnen)
- Die Stabilität ist auf den gewünschten Ton eingestellt
- Lange Skripte sind an natürlichen Übergängen aufgeteilt, mit identischen Einstellungen
- Die Musik liegt mindestens 20 dB unter der Stimme
- Sie haben sich das Ganze einmal komplett angehört, von Anfang bis Ende
Häufig gestellte Fragen
Warum klingt meine KI-Stimme roboterhaft?
Meist liegt es am Text, nicht an der Stimme. Lange Sätze, fehlende Satzzeichen, Abkürzungen und Ziffern drängen KI-Stimmen zu einem flachen, gehetzten Vortrag. Auch eine Stimme, die nicht zum Inhalt passt, ein zu hohes Tempo oder eine zu hoch eingestellte Stabilität können sie monoton klingen lassen.
Welche KI-Stimme klingt am natürlichsten?
Das hängt von Inhalt und Sprache ab. Testen Sie deshalb dasselbe Skript mit mehreren Stimmen. In unserem Angebot liefern die Stufen Advanced und Pro den natürlichsten Vortrag. Der Klon einer echten menschlichen Stimme klingt oft noch natürlicher: In einer 2025 in PLOS One veröffentlichten Studie wurden Klone in 58–70 % der Fälle für menschlich gehalten.
Wie füge ich bei Text-to-Speech Pausen ein?
Mit Satzzeichen. Kommas sorgen für kurze Pausen, Punkte schließen einen Satz ab, und ein neuer Absatz erzeugt die längste Pause. Doppelpunkte und Gedankenstriche schaffen eine kurze Zäsur vor einer Auflösung. Manche Engines verstehen außerdem SSML-Break-Tags, viele neuere Modelle ignorieren sie aber.
Wie bringe ich Text-to-Speech dazu, ein Wort richtig auszusprechen?
Schreiben Sie das Wort so, wie es klingt, etwa „Win“ für „Nguyen“ oder „red“ für die Vergangenheitsform von „read“. Bei AnySpeech speichern Sie die phonetische Schreibweise im Pronunciation dictionary, damit sie automatisch für jede Stimme gilt.
Wie schnell sollte eine KI-Erzählstimme sprechen?
Für die meisten Erzählungen passen etwa 150–155 Wörter pro Minute. Laut ACX lesen Hörbuchsprecher im Schnitt etwa 9.300 Wörter pro Stunde, also rund 155 Wörter pro Minute. Starten Sie mit einer Geschwindigkeit von 0,9× bis 1,0× und drosseln Sie das Tempo bei technischen Inhalten etwas.
Können KI-Stimmen Emotionen ausdrücken?
Ja. Premium-Stimmen lesen die Emotion aus den Wörtern selbst heraus. Schreiben Sie das Gefühl also direkt ins Skript („Ich konnte es einfach nicht glauben.“). Eine niedrigere Stabilität sorgt für eine größere emotionale Bandbreite. Pro-Stimmklone bringen außerdem eine eigene Emotionssteuerung mit.
Brauche ich SSML noch?
Für die meisten Projekte nicht. SSML ist praktisch für exakte Pausen und Aussprachen bei klassischen Cloud-Stimmen, aber neuere, ausdrucksstarke Modelle ignorieren manche Tags. Methoden, die mit reinem Text auskommen (Satzzeichen, phonetische Schreibweise und ausgeschriebene Zahlen), funktionieren mit jeder Engine.
Können Menschen KI-Stimmen von echten unterscheiden?
Oft nicht. In einer 2025 in PLOS One veröffentlichten Studie hielten Hörer Stimmklone in 58–70 % der Fälle für menschlich, Aufnahmen echter Menschen in 62–81 %. Generische KI-Stimmen schnitten mit etwa 40 % schlechter ab.
Damit Ihre nächste Vertonung menschlich klingt
Gegen eine roboterhafte Stimme brauchen Sie weder ein neues Tool noch einen Tontechniker. Beginnen Sie beim Skript: kürzere Sätze, echte Satzzeichen, ausgeschriebene Zahlen. Justieren Sie dann Stimme, Geschwindigkeit und Stabilität.
Probieren Sie es gleich aus: Fügen Sie einen Absatz in Text-to-Speech von AnySpeech ein, generieren Sie ihn einmal unverändert und dann noch einmal, nachdem Sie die Tipps 3 bis 5 angewendet haben. Den Unterschied hört man sofort.
Autor

Kategorien
Weitere Beiträge
KI-Podcast erstellen: Von einer Idee zur Show mit mehreren Stimmen (2026)
So erstellen Sie in wenigen Minuten einen KI-Podcast. Verwandeln Sie ein einziges Thema oder Skript in ein natürliches Gespräch zweier Moderatoren mit KI-Stimmen — ganz ohne Mikrofon und Schnitt.
YouTube-Kanal ohne Gesicht mit KI-Stimme starten (2026)
YouTube-Kanal ohne Gesicht mit KI-Stimme starten: Nischen, Skripte, Stimmen, Kosten und YouTubes Regeln 2026 zu KI-Inhalten, Offenlegung und Monetarisierung.

Text-to-Speech für Barrierefreiheit: Ein Leitfaden bei Legasthenie, ADHS & Sehschwäche (2026)
Wie Text-to-Speech bei Legasthenie, ADHS und Sehschwäche hilft – wem es nützt, was die Forschung sagt, worauf du bei einem Tool achten solltest und wie du kostenlos mit dem Lesen per Ohr beginnst.