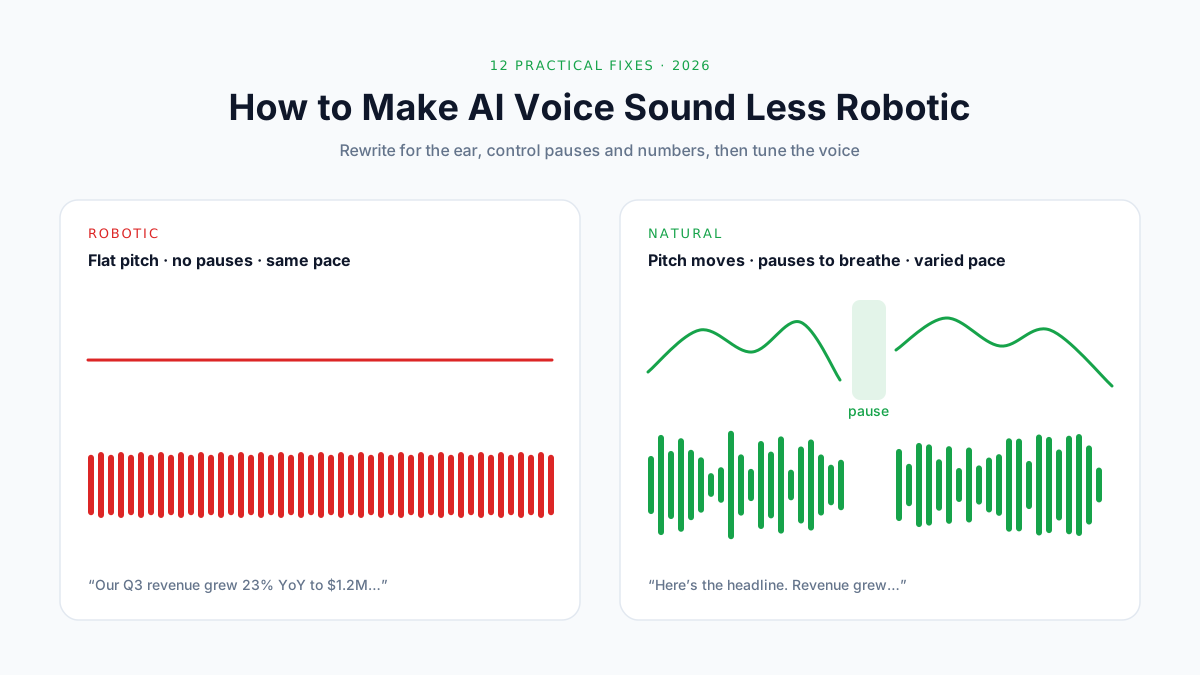
كيف تجعل صوت الذكاء الاصطناعي أقل آلية: 12 حلاً (2026)
لماذا تبدو أصوات الذكاء الاصطناعي آلية، و12 حلاً فعالاً: اكتب للأذن، واصنع الوقفات بعلامات الترقيم، واكتب الأرقام بالحروف، وصحّح النطق، واضبط السرعة، وغيرها.
تلصق النص، وتضغط زر التوليد، فيأتي الصوت… مقبولاً. واضحاً، لكنه باهت. يمرّ على القوائم مسرعاً، ويشدّد على الكلمات الخطأ، ويقرأ "$1.2M" كأنه يتلو جدول بيانات.
والمفاجأة أن التقنية نادراً ما تكون المشكلة اليوم. ففي دراسة نُشرت عام 2025 في مجلة PLOS One، حكم المستمعون بأن الأصوات المستنسَخة بالذكاء الاصطناعي بشرية في 58–70% من الحالات، وهي نسبة قريبة من 62–81% التي نالتها تسجيلات بشرية حقيقية.
لذلك، حين يبدو صوت الذكاء الاصطناعي آلياً اليوم، يكون السبب في الغالب هو النص والإعدادات، لا المحرك. وكلاهما يمكنك إصلاحه في دقائق.
ويشرح لك هذا الدليل كيف تفعل ذلك بالضبط.
ما ستتعلمه:
- العوامل الخمسة التي تجعل الكلام المولَّد بالذكاء الاصطناعي يبدو آلياً
- طريقة سريعة لتحديد موضع الخلل في ملفك الصوتي
- 12 حلاً، من إعادة كتابة النص إلى ضبط إعدادات الصوت
- كيف تتحكم في الوقفات والأرقام والنطق دون كتابة أي كود
- ما السرعة المناسبة للسرد بالذكاء الاصطناعي، بأرقام حقيقية
- مثال كامل لإعادة الكتابة (قبل وبعد) يمكنك نسخه
إجابة سريعة: لتجعل صوت الذكاء الاصطناعي أقل آلية، اكتب جملاً قصيرة كما يتحدث الناس، واستخدم الفواصل والنقاط والفقرات الجديدة لصنع الوقفات، واكتب الأرقام والاختصارات بالحروف كاملة، وأعد كتابة الكلمات التي يخطئ الصوت في نطقها بحسب لفظها، واختر صوتاً يناسب المحتوى. ثم خفّض السرعة قليلاً، وقلّل الثبات بعض الشيء لتحصل على تعبير أكبر. وفي أداة تحويل النص إلى كلام بالذكاء الاصطناعي، لا يستغرق معظم ذلك سوى ثوانٍ.
لماذا يبدو صوت الذكاء الاصطناعي آلياً؟
يبدو صوت الذكاء الاصطناعي آلياً حين لا يتطابق إيقاعه وطبقته ووقفاته مع طريقة كلام الناس الفعلية. فالبشر يغيّرون سرعة كلامهم، ويرفعون طبقة الصوت ويخفضونها، ويتوقفون لالتقاط أنفاسهم، ويشدّدون على الكلمات المهمة. وحين لا يفعل الكلام المُصنَّع ذلك، يبدو آلياً.
الأسباب الخمسة
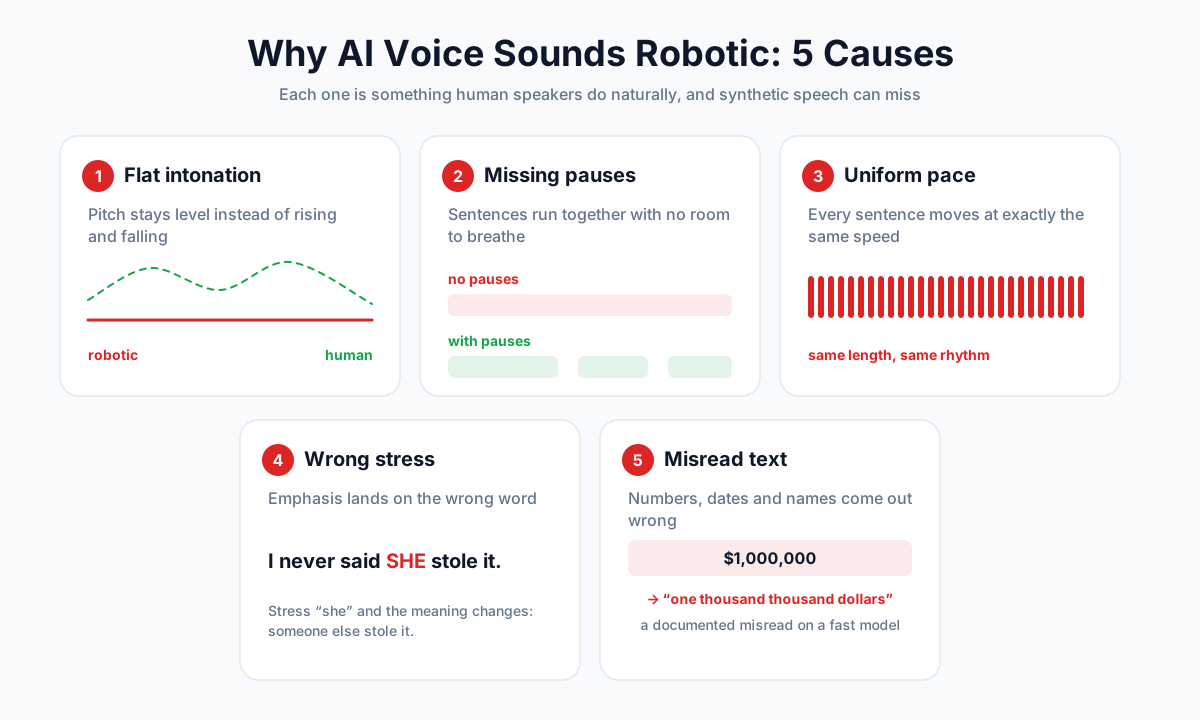
- تنغيم رتيب. تبقى طبقة الصوت على مستوى واحد بدلاً من أن ترتفع وتنخفض مع المعنى.
- غياب الوقفات. تتلاحق الجمل دون فسحة لالتقاط النفَس.
- سرعة موحّدة. كل جملة تمضي بالسرعة نفسها تماماً.
- نبر في غير موضعه. يقع التشديد على الكلمة الخطأ، فيتغيّر المعنى.
- سوء قراءة النص. تخرج الأرقام والتواريخ والاختصارات والأسماء بشكل خاطئ.
وللسبب الأخير اسم عند الباحثين: تطبيع النص (text normalization)، أي تحويل النص المكتوب إلى كلمات يستطيع الصوت نطقها. وهي مهمة صعبة حتى على الأنظمة الحديثة، لأن "1/2" قد تعني "نصف" أو "الثاني من يناير" أو "الأول من فبراير"، بحسب السياق.
المسافة التي قطعتها أصوات الذكاء الاصطناعي
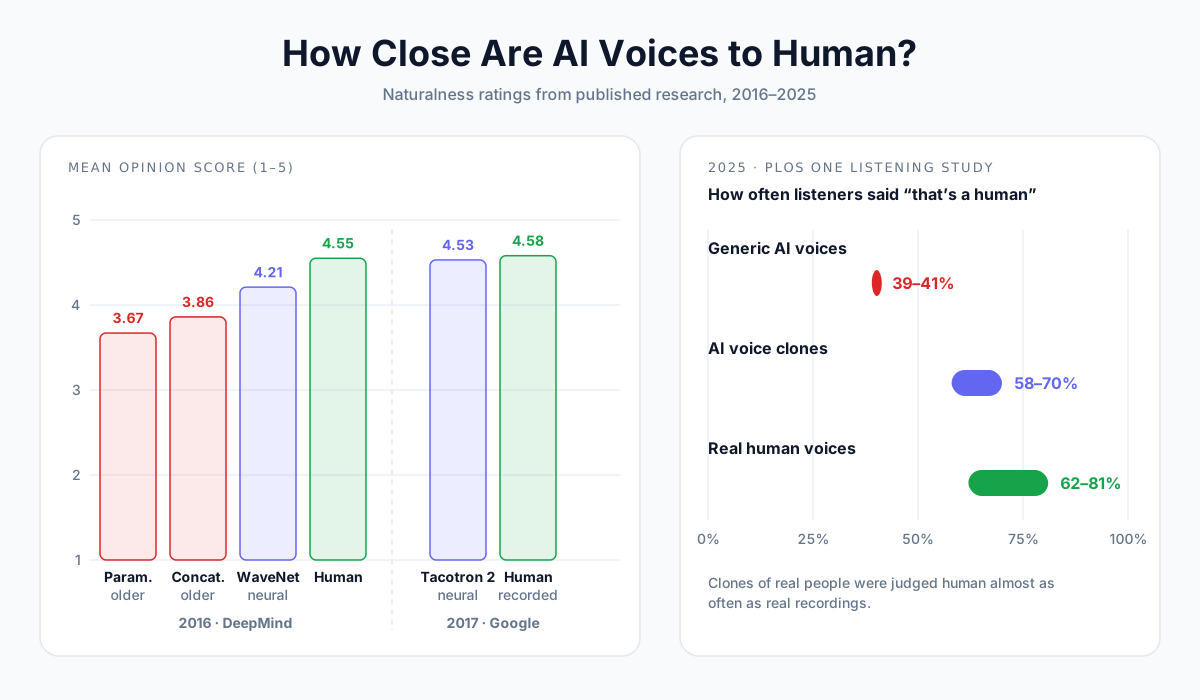
يقيس باحثو علوم الكلام مدى طبيعية الصوت بمؤشر يُسمى متوسط درجة الرأي (MOS): يقيّم المستمعون المقاطع من 1 (سيئ) إلى 5 (ممتاز).
| العام | المحطة | الدرجة |
|---|---|---|
| 2016 | الأصوات "البارامترية" و"التجميعية" القديمة (حقبة الصوت الآلي في أجهزة الملاحة GPS) | 3.67 و3.86 MOS، بينما سجّل البشر 4.55 |
| 2016 | WaveNet من DeepMind، أول صوت عصبي كبير | 4.21 MOS |
| 2017 | Tacotron 2 من Google | 4.53 MOS مقابل 4.58 للكلام المسجَّل |
| 2022 | NaturalSpeech من Microsoft | لا فرق ذا دلالة إحصائية بينه وبين التسجيلات |
| 2025 | دراسة استماع منشورة في PLOS One | حُكم على الأصوات المستنسَخة بأنها بشرية في 58–70% من الحالات، وعلى البشر الحقيقيين في 62–81% |
ووجدت الدراسة نفسها أن أصوات الذكاء الاصطناعي العامة (غير المستنسَخة من شخص حقيقي) لم يُحكم عليها بأنها بشرية إلا في نحو 40% من الحالات. هذه الفجوة مهمة، وسنعود إليها في الحل رقم 11.
معظم الصوت "الآلي" اليوم مشكلته في النص
الأصوات الحديثة قادرة على أن تبدو بشرية. لكنها تقرأ حرفياً ما تعطيها إياه.
جملة من 45 كلمة فيها ثلاثة اختصارات ومبلغ بالدولار ستبدو آلية بأي صوت تقريباً. أما الفكرة نفسها بعد إعادة كتابتها للأذن، فستبدو طبيعية بمعظم الأصوات. ولهذا تتعلق معظم الحلول التالية بالنص.
تشخيص سريع
قبل أن تغيّر أي شيء، استمع إلى الملف مرة واحدة وحدّد المشكلة. ثم انتقل مباشرة إلى الحل.
| ما تسمعه | السبب المرجّح | الحل |
|---|---|---|
| إلقاء باهت ورتيب | الصوت لا يناسب المحتوى، أو الثبات مضبوط على قيمة عالية جداً | #1، #2، #9 |
| لا مساحة للتنفس بين الأفكار | جمل طويلة، وفواصل أو فقرات قليلة | #3، #4 |
| قراءة متعجلة لاهثة | السرعة عالية جداً، والقوائم محشورة في جملة واحدة | #3، #8 |
| التشديد على الكلمة الخطأ | الكلمة المفتاحية مدفونة في منتصف الجملة | #7 |
| قراءة غريبة لـ "$1,000,000" | الأرقام والرموز متروكة بصيغتها الرقمية | #5 |
| نطق خاطئ للأسماء أو العلامات التجارية | كلمات غير مألوفة لا تتبع قاعدة واضحة بين الكتابة والنطق | #6 |
| يختلف الصوت من فقرة إلى أخرى | نص طويل قُسِّم وولِّدت أجزاؤه بإعدادات مختلفة | #10 |
| يبدو "نظيفاً أكثر من اللازم"، كأنه مسجَّل في مختبر | صوت جاف، بلا صوت غرفة ولا موسيقى خلفية | #12 |
الحلول الاثنا عشر
الحل رقم 1: ابدأ بمستوى الصوت المناسب
ليست كل أصوات الذكاء الاصطناعي مبنية بالطريقة نفسها. فالنماذج الأسرع والأرخص ممتازة للمسودات، أما النماذج المتميزة فتتعامل مع الإيقاع والمشاعر بشكل أفضل.
على AnySpeech، يمكن توليد النص نفسه على خمسة مستويات:
| المستوى | الأفضل لـ | ما يجدر معرفته |
|---|---|---|
| أساسي | المسودات، والنصوص الطويلة، وإمكانية الوصول | مجاني، ومتاح في تحويل النص إلى كلام مجاناً |
| قياسي | تغطية واسعة للغات واللكنات | أكثر من 300 صوت، وأكثر من 40 لغة |
| Flash | المقاطع القصيرة والحيوية والحوارية | سريع ومعبّر، وحتى 5,000 حرف في كل عملية توليد |
| متقدم | سرد طبيعي بأكثر من 70 لغة | خيارنا الافتراضي لمعظم التعليقات الصوتية |
| احترافي | أدق إلقاء وأكثره طبيعية | يستهلك رصيدين لكل حرف، ومتاح في الخطط المدفوعة |
💡 نصيحة احترافية: إذا بدا سطر ما باهتاً، فلا تُعِد كتابته فوراً. ولّد السطر نفسه أولاً على مستوى أعلى. فإن بدا صحيحاً الآن، فالمشكلة كانت في الصوت. وإن ظلّ غير مقنع، فالمشكلة في النص.
الحل رقم 2: طابق الصوت مع المحتوى
الصوت الرائع في إعلان قد يبدو غريباً وهو يقرأ قصة قبل النوم. اختر الصوت بحسب الغرض من الملف الصوتي، لا بحسب العينة التي أعجبتك أكثر.
| المحتوى | ابحث عن | تجنّب |
|---|---|---|
| الكتب الصوتية، والأفلام الوثائقية | راوٍ دافئ ومتزن | الأصوات الحماسية بأسلوب "المذيع" |
| الشروحات، والتعليم الإلكتروني | صوت واضح وودود ومتوسط السرعة | الأصوات المثقلة بالأنفاس أو المسرحية جداً |
| الإعلانات والعروض الترويجية | صوت نشيط ومشرق | الأصوات البطيئة والناعمة |
| YouTube ووسائل التواصل الاجتماعي | صوت حواري طبيعي | الأصوات الرسمية أكثر من اللازم |
| التأمل والنوم | صوت هادئ ومنخفض وبطيء | أي صوت مفعم بالحماس |
تصفّح مكتبة الأصوات وصفِّها حسب الأسلوب. ولنصوص YouTube، يعرض مولّد التعليق الصوتي لـ YouTube أصواتاً تناسب السرد.
الحل رقم 3: اكتب للأذن لا للعين
النص المكتوب يختلف عن النص المنطوق. حين نقرأ، يمكننا أن نعود إلى جملة طويلة ونقرأها مجدداً. وحين نستمع، لا نستطيع.
- اجعل الجمل قصيرة. استهدف أقل من 20 كلمة، وقسّم كل ما هو أطول من ذلك.
- استخدم الصيغ المختصرة التي يستعملها الناس في الكلام. "سنرسل" و"لا تقلق" تبدو بشرية، أما "سوف نقوم بإرسال" و"لا يوجد داعٍ للقلق" فتبدو متكلفة.
- ضع فكرة واحدة في كل جملة. حين تربط فكرتين بـ"الذي" أو بـ"و"، ينكسر الإيقاع عندها.
- استخدم المبني للمعلوم. "اختبرنا عشر أدوات" أفضل من "تم اختبار عشر أدوات من قِبل فريقنا".
- اقرأ النص بصوت عالٍ بنفسك. إن انقطع نفَسك، فسينقطع نفَس الصوت أيضاً.
| مكتوب للعين | مكتوب للأذن |
|---|---|
| عند إتمام عملية التسجيل، سيتم إرسال رسالة تأكيد عبر البريد الإلكتروني إلى المستخدمين. | بعد أن تسجّل، سنرسل لك رسالة تأكيد على بريدك. |
| المنتج، الذي تم إطلاقه في عام 2024، قد تم اعتماده من قِبل ما يزيد على 10,000 فريق. | أطلقنا المنتج في 2024. ومنذ ذلك الحين، اشترك فيه أكثر من عشرة آلاف فريق. |
الحل رقم 4: استخدم علامات الترقيم لصنع الوقفات
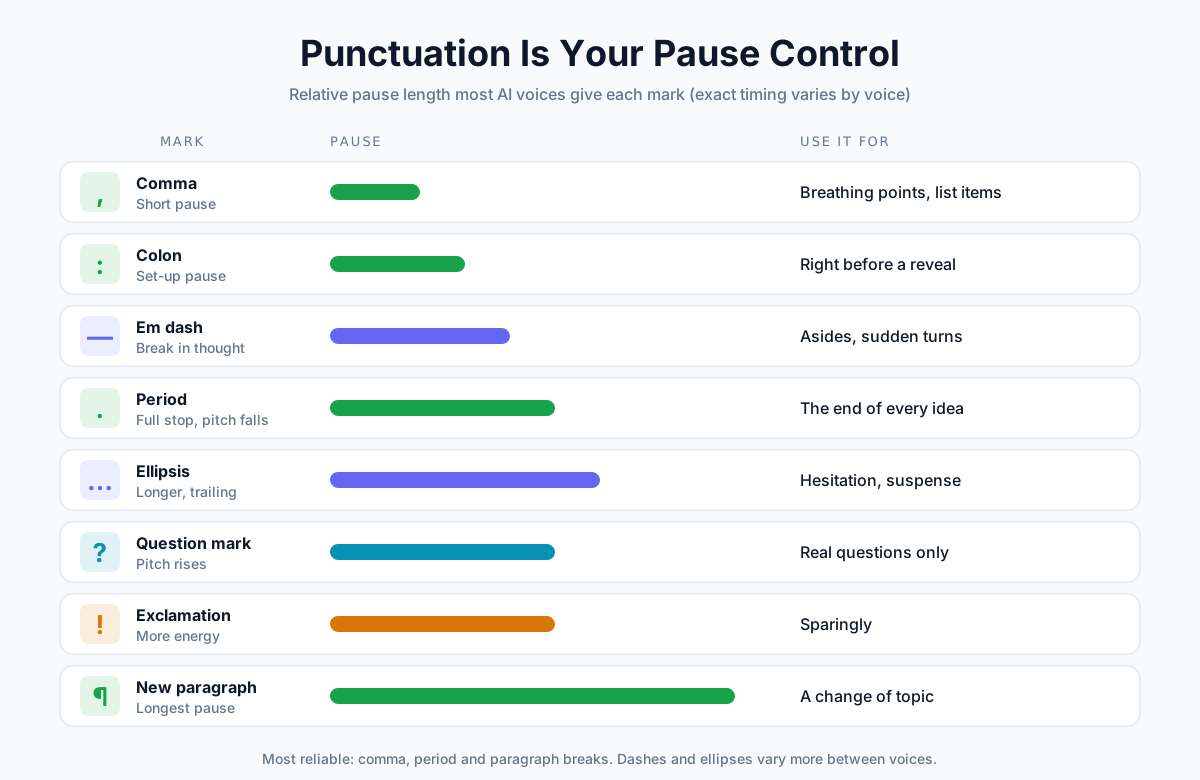
تتعامل أصوات الذكاء الاصطناعي الحديثة مع علامات الترقيم كأنها تعليمات إخراج مسرحي. فالفاصلة تمنح نفَساً قصيراً. والنقطة تترك طبقة الصوت تنخفض. أما الفقرة الجديدة فتمنح أطول وقفة على الإطلاق.
| علامة الترقيم | ما تفعله عادةً | استخدمها لـ |
|---|---|---|
| الفاصلة ، أو , | وقفة قصيرة | مواضع التنفس، وعناصر القوائم |
| النقطة . | وقفة تامة، وتنخفض طبقة الصوت | نهاية كل فكرة |
| النقطتان : | وقفة تمهيدية قصيرة | قبل الكشف عن معلومة أو قبل قائمة مباشرة |
| الشرطة الطويلة — | انقطاع في سياق الفكرة | الجمل الاعتراضية والانعطافات المفاجئة |
| علامة الحذف … | وقفة أطول ممتدة | التردد، والتشويق |
| علامة الاستفهام ؟ أو ? | ترتفع طبقة الصوت | الأسئلة الحقيقية فقط |
| علامة التعجب ! | طاقة أكبر | باعتدال، وإلا بدا الصوت صارخاً |
| فقرة جديدة | أطول وقفة | الانتقال إلى موضوع جديد |
📝 ملاحظة: تختلف مدة الوقفة بدقة من صوت إلى آخر ومن محرك إلى آخر. وتشير وثائق ElevenLabs نفسها إلى أن الشرطات وعلامات الحذف تصنع وقفات أقل انتظاماً من الطرق الأخرى. أما الفواصل والنقاط والانتقال إلى فقرة جديدة فهي الأكثر موثوقية.
الحل رقم 5: اكتب الأرقام والتواريخ والرموز بالحروف
الأرقام والرموز هي أكثر ما تتعثر فيه أصوات الذكاء الاصطناعي، لأن الرموز نفسها يمكن قراءتها بعدة طرق.
وتضرب وثائق ElevenLabs مثالاً واضحاً: أحد نماذجها السريعة قد يقرأ "$1,000,000" على أنه "one thousand thousand dollars" (أي "ألف ألف دولار"). وكتابة الرقم بالحروف تُلغي التخمين مع أي صوت.
| بدلاً من | اكتب | السبب |
|---|---|---|
| $1,000,000 | مليون دولار | لتفادي تجميع الأرقام بطريقة غريبة |
| $42.50 | اثنان وأربعون دولاراً وخمسون سنتاً | تُقرأ السنتات بشكل صحيح |
| 3:30 pm | الثالثة والنصف عصراً | وقت، لا نسبة |
| 2026-01-15 | الخامس عشر من يناير، عام ألفين وستة وعشرين | صيغ التواريخ تختلف من بلد إلى آخر |
| 25% | خمسة وعشرون بالمئة | بعض الأصوات تتجاهل الرمز |
| Dr. Smith | الدكتور سميث | قد تُقرأ "Dr." على أنها "Drive" |
| Q3 | الربع الثالث | الاختصارات تُقرأ حرفاً حرفاً |
| anyspeech.io/pricing | إني سبيتش دوت آي أو سلاش برايسنغ | الروابط تُقرأ بطريقة لا يمكن توقعها |
| 1/2 | نصف | قد تُفهم على أنها تاريخ |
لست مضطراً إلى فعل ذلك مع كل رقم. فالأرقام الصغيرة البسيطة مثل "3" أو "10" لا تسبب مشكلة عادةً. ركّز على المبالغ المالية والتواريخ والأوقات والنسب المئوية وكل ما يحتوي على رموز.
الحل رقم 6: صحّح النطق بإعادة التهجئة
حين يخطئ الصوت في نطق اسم أو علامة تجارية، اكتبه كما يُلفظ. قد يبدو ذلك حيلة، لكنه الأسلوب الوحيد الذي ينجح مع كل المحركات.
| الكلمة | أعد تهجئتها هكذا | المشكلة التي تحلها |
|---|---|---|
| Nguyen | Win | اسم عائلة شائع يُقرأ خطأً في أحيان كثيرة |
| Worcestershire | Wuss-ter-sher | حروف صامتة لا تُنطق |
| AnySpeech | Any Speech | علامة تجارية مكوّنة من كلمات ملتصقة |
| SQL | sequel (أو S Q L) | اختصار: حروف منفصلة أم كلمة واحدة؟ |
| read (بصيغة الماضي) | red | التهجئة نفسها بنطق مختلف |
| live (صفة) | lyve | "a lyve show" مقابل "I live here" |
| GIF | jif (أو gif) | اختر نطقاً واحداً والتزم به |
وعلى AnySpeech، لا تحتاج إلى تعديل كل نص. في صفحة تحويل النص إلى كلام، افتح Pronunciation dictionary (قاموس النطق)، واملأ حقلَي Written text (النص المكتوب) وSay it like (انطقها هكذا)، فتُطبَّق القاعدة تلقائياً على كل الأصوات. ويمكنك حفظ ما يصل إلى 50 قاعدة بعد تسجيل الدخول.
💡 نصيحة احترافية: للاختصارات التي تريدها أن تُقرأ حرفاً حرفاً، أضف مسافات أو نقاطاً: "F B I" أو "F.B.I.". أما الاختصارات التي تُقرأ ككلمة واحدة، مثل "NASA"، فاتركها كما هي.
الحل رقم 7: تحكّم في التشديد عبر ترتيب الكلمات
في أداة تعتمد على النص العادي، لا يمكنك أن تضع على كلمة علامة تقول "شدّد على هذه". لكن يمكنك التحكم في التشديد من خلال طريقة بناء الجملة.
- ضع الكلمة المفتاحية في آخر الجملة. نهاية الجملة هي موضع النبر الطبيعي في الإنجليزية، والقاعدة نفسها تستحق التجربة في النص العربي. قارن: "النتائج فاجأت الجميع" مقابل "الجميع تفاجؤوا بالنتائج".
- أفرِد لها جملة خاصة. "إنه مجاني. مجاني تماماً." الجمل القصيرة تترك أثراً قوياً.
- استخدم النقطتين أو الشرطة قبل الكشف عن المعلومة. "هناك شيء واحد مهم هنا: التوقيت."
- تجنّب الأحرف الكبيرة بالكامل (ALL CAPS). إن احتوى نصك على كلمة إنجليزية، فلا تكتبها بالأحرف الكبيرة لتأكيدها، لأن كثيراً من الأصوات تقرأ الأحرف الكبيرة على أنها اختصار وتتهجّى الكلمة حرفاً حرفاً.
الحل رقم 8: اختر السرعة المناسبة
الصوت الأسرع قليلاً مما ينبغي هو السبب الأكثر شيوعاً في أن يبدو السرد آلياً. وإليك ما يفعله الرواة الحقيقيون:
| المحتوى | الوتيرة المعتادة | إعداد السرعة المقترح للبدء |
|---|---|---|
| سرد الكتب الصوتية | نحو 155 كلمة في الدقيقة (ACX) | 0.9×–1.0× |
| المحادثة اليومية | نحو 150 كلمة في الدقيقة | 1.0× |
| الدروس والمحتوى التقني | أبطأ قليلاً من المحادثة | 0.9× |
| الإعلانات والعروض الترويجية | أسرع ونشيطة | 1.05×–1.1× |
| التأمل والنوم | بطيئة ومتمهلة | 0.8× |
ويأتي رقم 155 من ACX، منصة الكتب الصوتية التابعة لـ Audible، التي تذكر أن معظم الرواة يقرؤون نحو 9,300 كلمة في الساعة.
وعلى AnySpeech، يتراوح شريط السرعة في المستوى القياسي والمتقدم والاحترافي بين 0.7× و1.2×. غيّره بخطوات صغيرة مقدارها 0.1×، فالقفزات الأكبر قد تجعل الصوت يبدو ممطوطاً أو مضغوطاً.
الحل رقم 9: اضبط الثبات والتشابه
في المستويين المتقدم والاحترافي، يتحكم شريطان في مدى تعبيرية الصوت.
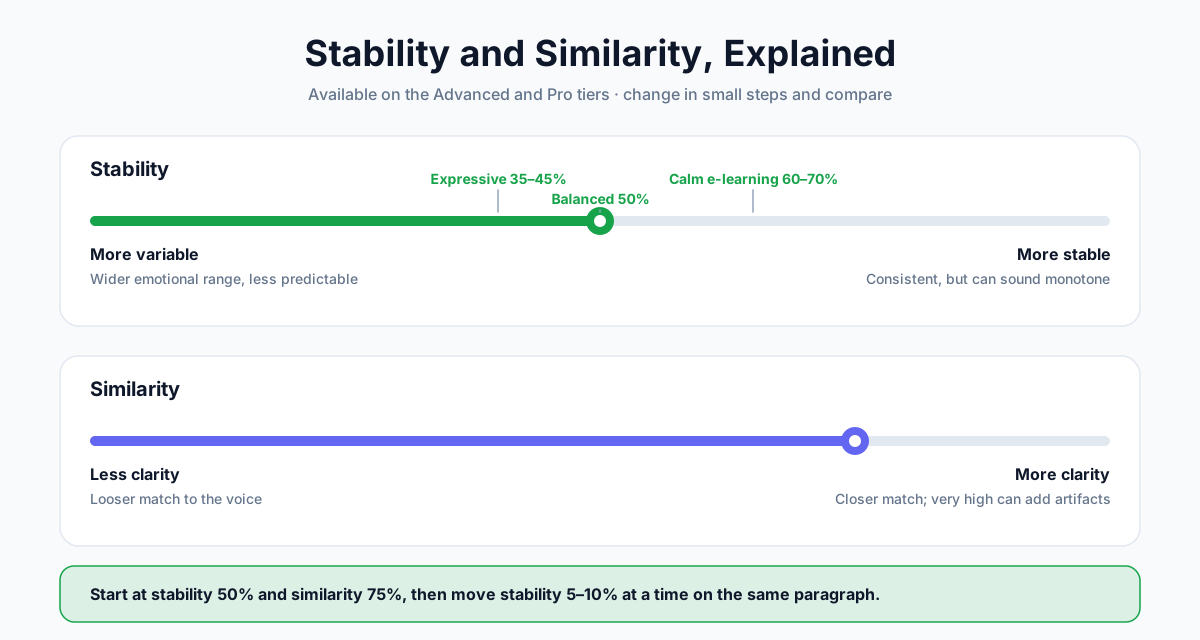
| الشريط | قيمة أقل | قيمة أعلى |
|---|---|---|
| الثبات | أكثر تنوعاً: مدى عاطفي أوسع، لكنه أقل قابلية للتنبؤ | أكثر ثباتاً: أداء متسق، لكنه قد يبدو رتيباً |
| التشابه | وضوح أقل، وتطابق أضعف مع الصوت | وضوح أكثر، وتطابق أقرب، لكن القيم العالية جداً قد تضيف تشوهات صوتية |
نقطة انطلاق عملية:
| الهدف | الثبات | التشابه |
|---|---|---|
| سرد قصصي معبّر | 35–45% | 75% |
| سرد متوازن (الإعداد الافتراضي) | 50% | 75% |
| تعليم إلكتروني هادئ ومتسق | 60–70% | 75–80% |
اضبط الثبات بخطوات تبلغ نحو 5–10%، وأعد توليد الفقرة نفسها في كل مرة لتتمكن من المقارنة.
الحل رقم 10: ولّد النصوص الطويلة على أقسام
النصوص الطويلة تسبب مشكلتين. إن أخطأ الصوت في جملة واحدة، فعليك إعادة توليد كل شيء. وإن قسّمت النص دون عناية، فقد يبدو كل جزء مختلفاً قليلاً عن غيره.
- قسّم النص عند مفاصله الطبيعية: الفصول أو المشاهد أو تغيّر الموضوع، ولا تقسّمه أبداً في منتصف فقرة.
- اجعل الإعدادات متطابقة في كل الأجزاء: الصوت والمستوى والسرعة والثبات، دون أي تغيير.
- سمِّ ملفاتك بالترتيب (01-مقدمة، 02-إعداد…) ليسهل دمجها.
وعلى AnySpeech، تتيح الخطط المدفوعة توليد ما يصل إلى 50,000 حرف دفعة واحدة (و5,000 في الخطة المجانية وفي مستوى Flash). ومع ذلك، فإن التوليد فصلاً بفصل يجعل إصلاح سطر واحد أسهل بكثير.
الحل رقم 11: استخدم صوتاً بشرياً مستنسَخاً
هل تذكر دراسة PLOS One؟ الأصوات المستنسَخة من أشخاص حقيقيين حُكم عليها بأنها بشرية أكثر بكثير من أصوات الذكاء الاصطناعي العامة: في نحو 58–70% من الحالات، مقابل نحو 40%.
فالصوت المستنسَخ يحمل إيقاع شخص حقيقي وخصوصيات كلامه وعاداته في التنفس. وإن كنت تقدّم السرد بصوتك بانتظام، يمكنك استنساخ صوتك من تسجيل قصير واستخدامه في كل نص.
- سجّل في غرفة هادئة، بلا موسيقى أو صدى.
- تحدّث بالطريقة التي تريد أن تبدو بها النسخة: مسترخياً وطبيعياً، لا بأسلوب "المذيع".
- لا تستنسخ إلا صوتك، أو صوتاً لديك إذن واضح باستخدامه.
ويشرح دليلنا لاستنساخ الصوت عملية التسجيل خطوة بخطوة.
الحل رقم 12: أكمل العمل في مرحلة ما بعد الإنتاج
قد يبدو صوت الذكاء الاصطناعي الخام "نظيفاً" على نحو غير طبيعي، كأنه صوت يطفو في فراغ. وبضع لمسات خفيفة تجعله يستقر في العالم الحقيقي.
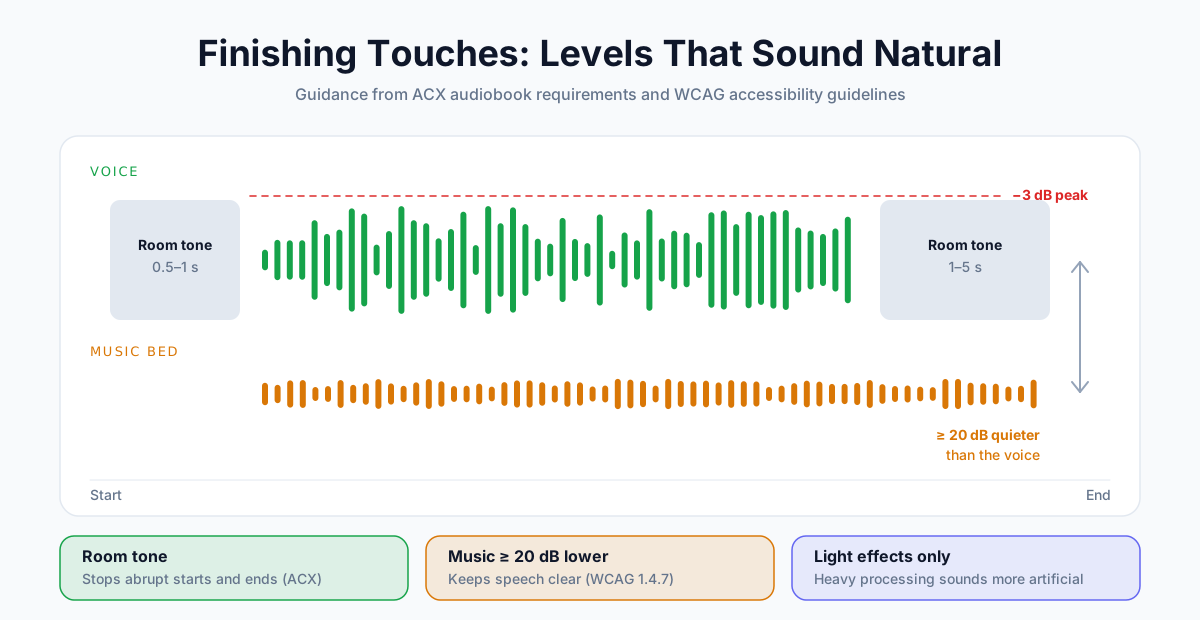
- أضف صوت الغرفة (room tone)، أي الأجواء الخافتة لغرفة هادئة. تطلب ACX وجود 0.5–1 ثانية منه في بداية كل ملف، و1–5 ثوانٍ في نهايته. فهذا يمنع الصوت من أن يبدأ أو ينتهي بشكل مفاجئ.
- أبقِ الموسيقى أخفض بكثير من الصوت. توصي إرشادات إمكانية الوصول (WCAG) بأن تكون الأصوات الخلفية أهدأ من الكلام بما لا يقل عن 20 ديسيبل.
- لا تُفرط في المؤثرات. الضغط الديناميكي الشديد أو الصدى (reverb) أو معادلة الترددات (EQ) قد تجعل الصوت المُصنَّع أكثر اصطناعية، لا أقل.
- أبقِ ذروات الصوت دون سالب 3 ديسيبل كي لا يتشوه عند تشغيله بصوت مرتفع (وهذا أيضاً من متطلبات ACX).
قبل وبعد: إعادة كتابة كاملة
إليك فقرة واحدة مكتوبة بالأسلوب المعتاد في تقارير الأعمال، ثم الفقرة نفسها بعد إعادة كتابتها لتُقرأ بصوت.
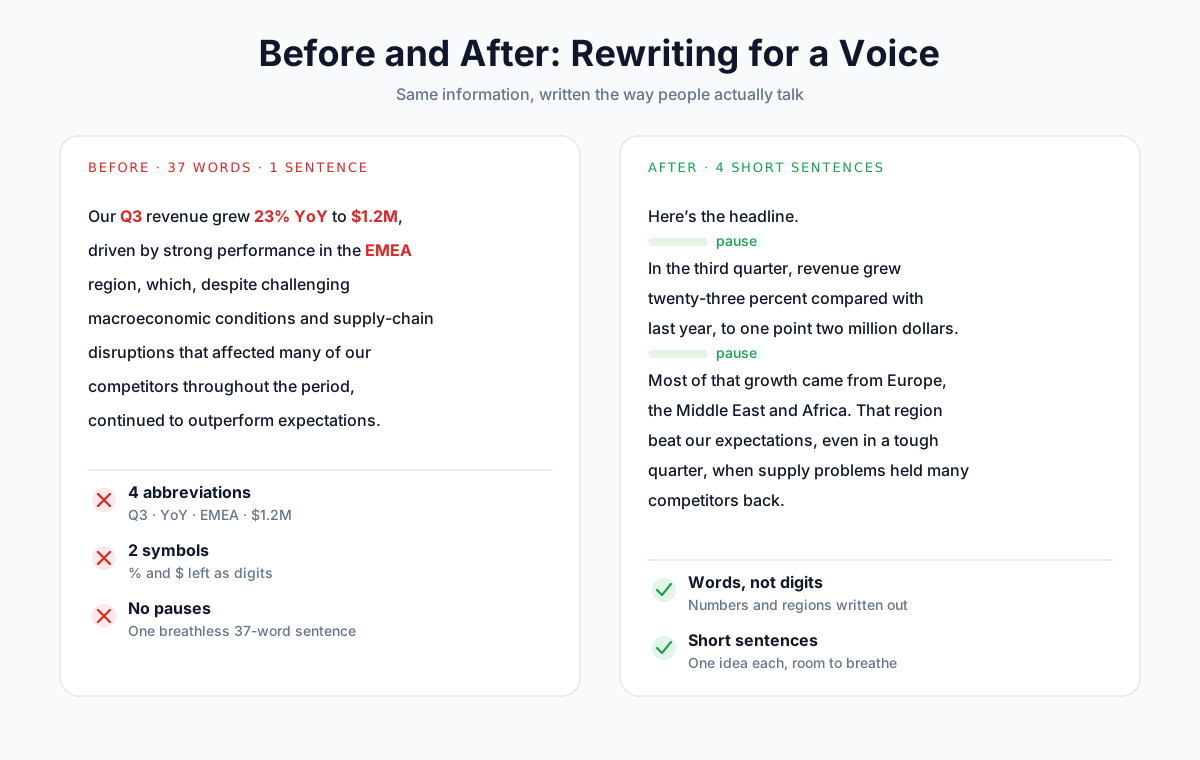
قبل (37 كلمة، جملة واحدة):
Our Q3 revenue grew 23% YoY to $1.2M, driven by strong performance in the EMEA region, which, despite challenging macroeconomic conditions and supply-chain disruptions that affected many of our competitors throughout the period, continued to outperform expectations.
بعد (أربع جمل قصيرة):
Here's the headline. In the third quarter, revenue grew twenty-three percent compared with last year, to one point two million dollars.
Most of that growth came from Europe, the Middle East and Africa. That region beat our expectations, even in a tough quarter, when supply problems held many competitors back.
ما الذي تغيّر:
| التغيير | الحل المستخدم |
|---|---|
| تحويل "Q3" و"YoY" و"EMEA" إلى كلمات كاملة | #5 |
| كتابة "23%" و"$1.2M" بالحروف | #5 |
| تقسيم جملة واحدة من 37 كلمة إلى أربع جمل | #3 |
| افتتاحية قصيرة ("Here's the headline.") تمهّد للخبر | #7 |
| الانتقال إلى فقرة جديدة بين النتائج وسياقها | #4 |
المعلومات نفسها، ولا حِيَل فيها. لكن بأي صوت تقريباً، تبدو النسخة الثانية كأن شخصاً يتحدث.
ماذا عن SSML؟
SSML (لغة ترميز تركيب الكلام) مجموعة من الوسوم تقبلها بعض محركات تحويل النص إلى كلام، لإدراج وقفة بطول محدد مثلاً، أو لنطق كلمة بطريقة معينة.
<speak>
  Welcome back. <break time="700ms"/> Let's get started.
</speak>
لا تزال SSML تعمل مع كثير من الأصوات السحابية الكلاسيكية. لكن النماذج الأحدث والأكثر تعبيراً باتت تتجاهلها أكثر فأكثر، أو لا تدعم منها إلا جزءاً. فشركة ElevenLabs، مثلاً، تقول إن أحدث نماذجها v3 وv4 لا تدعم وسوم الوقفة (break) في SSML. وأصوات Chirp 3 HD من Google لا تدعم سوى جزء منها.
أما AnySpeech فتعمل بالنص العادي، ولهذا يعتمد كل حل في هذا الدليل على الكتابة وعلامات الترقيم والإعدادات بدلاً من الوسوم. وهذه الطرق تعمل مع كل صوت وكل مستوى.
نصائح خاصة باللغات
تنطبق معظم الحلول السابقة على أي لغة. لكن بعض المشكلات تظهر تحديداً مع النصوص غير الإنجليزية:
- استخدم صوتاً مصمماً للغة نصك. يبدو النص العربي أكثر طبيعية بكثير بصوت مبني للعربية. تصفّح الأصوات حسب اللغة في صفحة لغات تحويل النص إلى كلام، أو اختر لكنة بعينها، مثل الإنجليزية البريطانية.
- اكتب الأرقام بالحروف في اللغة المستهدفة. في النصوص التي تمزج بين لغتين، قد يقرأ الصوت الأرقام باللغة الخطأ.
- استخدم علامات الترقيم الخاصة باللغة. تستخدم الصينية واليابانية علامات كاملة العرض (。,?)، وتتعامل معها الأصوات على أنها وقفات.
- اختبر النص المختلط اللغات قبل اعتماده. أسماء العلامات التجارية والمصطلحات الإنجليزية داخل لغة أخرى من أكثر ما يُربك الأصوات. أعد تهجئتها عند الحاجة (الحل رقم 6).
قائمة التحقق لصوت ذكاء اصطناعي طبيعي
راجع هذه القائمة قبل النشر. وإن أخفق أي بند، فسيدلّك جدول التشخيص السريع على الحل المناسب.
- الصوت يناسب المحتوى (راوٍ، أو حواري، أو نشيط)
- الجمل قصيرة، وفي كل منها فكرة واحدة
- استُخدمت الصيغ المختصرة حيث يستخدمها المتحدث عادةً
- كل انتقال إلى موضوع جديد يبدأ بفقرة جديدة
- المبالغ المالية والتواريخ والأوقات والنسب المئوية مكتوبة بالحروف
- الأسماء والعلامات التجارية الصعبة أُعيدت تهجئتها أو أُضيفت إلى قاموس النطق
- الكلمة المفتاحية في كل جملة مهمة تقع قرب نهايتها
- السرعة تناسب المحتوى (ابدأ من 0.9×–1.0× للسرد)
- الثبات مضبوط على النبرة التي تريدها
- النصوص الطويلة مقسّمة عند مفاصلها الطبيعية، بإعدادات متطابقة
- الموسيقى أخفض من الصوت بما لا يقل عن 20 ديسيبل
- استمعت إلى الملف كاملاً مرة واحدة، من أوله إلى آخره
الأسئلة الشائعة
لماذا يبدو صوت الذكاء الاصطناعي لديّ آلياً؟
في الغالب بسبب النص، لا الصوت. فالجمل الطويلة وغياب علامات الترقيم والاختصارات والأرقام كلها تدفع أصوات الذكاء الاصطناعي نحو إلقاء باهت ومتعجل. وقد يصبح الإلقاء رتيباً أيضاً إذا كان الصوت لا يناسب المحتوى، أو كانت السرعة عالية جداً، أو كان الثبات مضبوطاً على قيمة مرتفعة جداً.
ما أكثر أصوات الذكاء الاصطناعي طبيعية؟
يعتمد ذلك على المحتوى واللغة، لذا جرّب النص نفسه على عدة أصوات. ومن بين ما نقدّمه، يمنح المستويان المتقدم والاحترافي الإلقاء الأكثر طبيعية. وكثيراً ما يبدو الصوت المستنسَخ من إنسان حقيقي أكثر طبيعية من ذلك: ففي دراسة نُشرت عام 2025 في PLOS One، حُكم على الأصوات المستنسَخة بأنها بشرية في 58–70% من الحالات.
كيف أضيف وقفات في تحويل النص إلى كلام؟
استخدم علامات الترقيم. فالفواصل تضيف وقفات قصيرة، والنقاط وقفات تامة، والفقرة الجديدة أطول وقفة. أما النقطتان والشرطة الطويلة فتضيفان انقطاعاً قبل الكشف عن معلومة. وتقبل بعض المحركات أيضاً وسوم الوقفة في SSML، لكن كثيراً من النماذج الأحدث يتجاهلها.
كيف أجعل تحويل النص إلى كلام ينطق كلمة بشكل صحيح؟
أعد تهجئة الكلمة كما تُلفظ، مثل "Win" بدلاً من "Nguyen"، أو "red" لصيغة الماضي من "read". وعلى AnySpeech، احفظ التهجئة الجديدة في Pronunciation dictionary (قاموس النطق) لتُطبَّق على كل الأصوات تلقائياً.
ما السرعة المناسبة للسرد بالذكاء الاصطناعي؟
السرعة المناسبة لمعظم أنواع السرد نحو 150–155 كلمة في الدقيقة. وتذكر ACX أن رواة الكتب الصوتية يقرؤون في المتوسط نحو 9,300 كلمة في الساعة، أي قرابة 155 كلمة في الدقيقة. ابدأ بسرعة بين 0.9× و1.0×، وأبطئ قليلاً للمحتوى التقني.
هل تستطيع أصوات الذكاء الاصطناعي التعبير عن المشاعر؟
نعم. فالأصوات المتميزة تلتقط المشاعر من الكلمات نفسها، لذا اجعل الشعور حاضراً في كلمات النص نفسها ("لم أصدّق ما حدث."). وخفض الثبات يمنح مدى عاطفياً أوسع. كما تأتي الأصوات المستنسَخة من مستوى Pro مع أدوات للتحكم في المشاعر.
هل ما زلت بحاجة إلى SSML؟
ليس في معظم المشاريع. تفيد SSML في ضبط الوقفات والنطق بدقة على الأصوات السحابية الكلاسيكية، لكن النماذج التعبيرية الأحدث كثيراً ما تتجاهل بعض الوسوم. أما أساليب النص العادي (علامات الترقيم، وإعادة التهجئة، وكتابة الأرقام بالحروف) فتعمل مع كل المحركات.
هل يستطيع الناس التمييز بين أصوات الذكاء الاصطناعي والأصوات الحقيقية؟
في أحيان كثيرة، لا. ففي دراسة نُشرت عام 2025 في PLOS One، حكم المستمعون بأن الأصوات المستنسَخة بشرية في 58–70% من الحالات، مقارنةً بـ62–81% للتسجيلات البشرية الحقيقية. أما أصوات الذكاء الاصطناعي العامة فنالت نسبة أقل، نحو 40%.
اجعل تعليقك الصوتي القادم يبدو بشرياً
لا تحتاج إلى أداة جديدة أو إلى مهندس صوت لإصلاح صوت آلي. ابدأ بالنص: جمل أقصر، وعلامات ترقيم حقيقية، وأرقام مكتوبة بالحروف. ثم اضبط الصوت والسرعة والثبات بدقة.
جرّب الآن: الصق فقرة في أداة تحويل النص إلى كلام من AnySpeech، وولّدها مرة كما هي، ثم مرة أخرى بعد تطبيق الحلول من 3 إلى 5. ستسمع الفرق بسهولة.
الكاتب

التصنيفات
مقالات أخرى

أفضل 10 أدوات تحويل النص إلى كلام في 2026 (مُختبرة ومُصنّفة)
اختبرنا أكثر من 30 أداة تحويل نص إلى كلام واخترنا أفضل 10. قارن جودة الصوت والأسعار واللغات والميزات جنباً إلى جنب. يتضمن خيارات مجانية واستنساخ الصوت بالذكاء الاصطناعي.
كيف تستنسخ صوتك بالذكاء الاصطناعي في 2026 (خطوة بخطوة + أفضل الأدوات)
تعلم كيف تستنسخ صوتك بالذكاء الاصطناعي في حوالي 30 ثانية. دليل خطوة بخطوة لاستنساخ الصوت، والحصول على أفضل جودة، وإضافة المشاعر، والاستنساخ بلغات أخرى — مع الجانب الأخلاقي.

كيفية تفريغ الصوت إلى نص: الدليل الكامل خطوة بخطوة (2026)
تعلّم كيف تفرّغ الصوت أو الفيديو إلى نص بسرعة. شرح خطوة بخطوة، وقائمة تدقيق من 7 نقاط لرفع الدقة، والصيغ المدعومة، ودلائل عملية للاجتماعات والمقابلات والترجمات.